1. Sistemas y abstracciones
En esta sección
Sistemas
Sistemas Distribuidos ocupa un lugar particular en el plan. Por un lado trae teoría nueva: buena parte de la materia consiste en retomar lo que ya sabemos de programación concurrente y llevarlo a un escenario donde los procesos no comparten memoria, lo que obliga a reconstruir desde cero varias herramientas que dábamos por sentadas. Por otro lado es una materia de cierre, de las últimas de la carrera, y depende de casi todo lo que vino antes.
Al escuchar “sistema distribuido”, lo primero que uno piensa es en la red: cables, protocolos, máquinas hablando entre sí. La red va a estar, por supuesto, pero más allá de ella vamos a estar hablando sobre todo de sistemas. Por eso lo primero que necesitamos es una definición de sistema —algo que no es seguro que hayamos visto formalmente en ningún lugar de la carrera—, y solo a partir de ella vamos a poder decidir cuáles son los sistemas que nos interesan y de qué manera los vamos a estudiar.
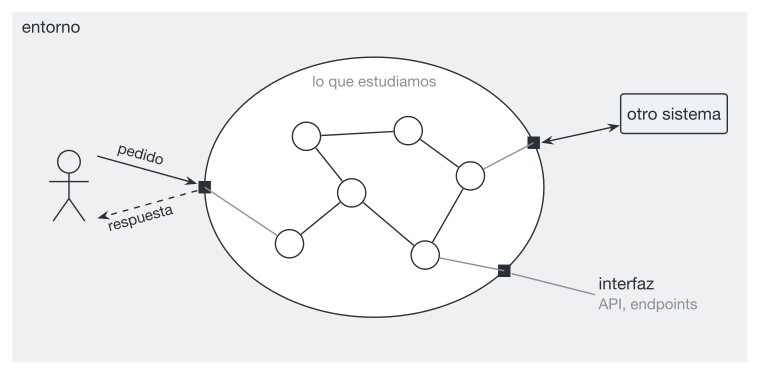
La versión que vamos a usar es esta: un sistema es un conjunto de componentes interconectados que interactúan entre sí para producir un comportamiento observable en su interfaz con el entorno. Vale la pena desarmarla despacio. Lo primero que dice es que hay muchos componentes y que están interconectados: todas esas piezas hablan unas con otras. Lo segundo, y lo verdaderamente importante de cualquier sistema, es el concepto de abstracción. Si bien cada componente hace lo suyo, uno los termina viendo desde afuera como una gran unidad. Esa unidad es la interfaz que tiene el sistema distribuido, o cualquier otro sistema.
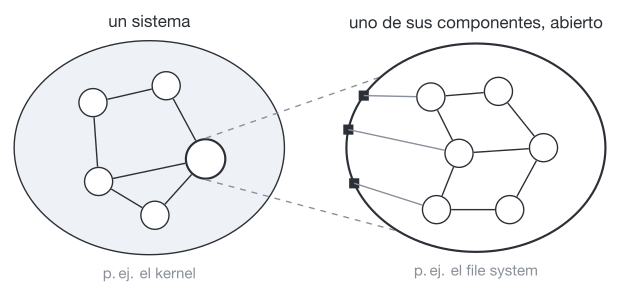
Lo que estamos dibujando es un diagrama genérico sobre diagramas, y lo venimos viendo desde que empezamos la facultad. La caja que representa al kernel contiene adentro el componente del file system y el de tantas otras cosas: un sistema que contiene otros subsistemas. Es algo a lo que ya estamos acostumbrados. La clave está en preguntarse para qué hacemos estos diagramas, y la respuesta es que sirven para definir la granularidad con la que vamos a estudiar las cosas —que va a resultar importante— y el nivel de abstracción en el que decidimos pararnos.
Esa interfaz que rodea al sistema recibe distintos nombres; en un sistema distribuido se la suele llamar API endpoints, o simplemente interfaz. Y lo que ese contorno nos está diciendo es cuál es el recorte que hicimos: lo de adentro es lo que estamos estudiando, lo de afuera es el entorno, que no nos interesa. Son perspectivas distintas según dónde nos coloquemos.
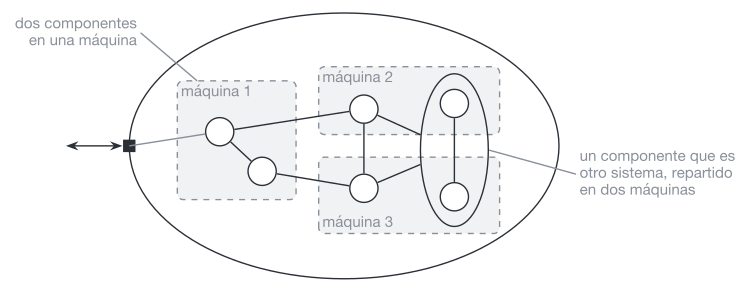
Cada uno de esos componentes puede ser, a su vez, otro subsistema. Vamos a ver que en un sistema distribuido es muy frecuente que no haya un mapeo directo entre estos círculos del diagrama y las computadoras que lo componen: muchas veces un sistema interactúa internamente con otro sistema entero, que ya es una complejidad en sí mismo.
Metodología de estudio del curso
Con esa definición en la mano podemos precisar cuáles son los sistemas que nos interesan. Vamos a estudiar sistemas distribuidos: sistemas en el sentido que le acabamos de dar a la palabra, pero grandes. No hace falta enfatizar tanto que están conectados por una red —típicamente lo van a estar—, porque la característica que verdaderamente los define es el tamaño. Y ahí está buena parte del motivo por el cual la materia entusiasma tanto: al ser grandes, tocan problemas que ya vimos por todos lados en la carrera: comunicaciones de red, los algoritmos que tiene adentro cada uno de ellos y, sobre todo, concurrencia, muchísima concurrencia, justamente porque las partes están separadas y se comunican a través de la red. Conviene anotar una advertencia desde ahora: de todo lo que aprendimos en concurrencia, algunas cosas van a servir y otras no. Hay herramientas que ya conocemos y que sencillamente no se pueden aplicar aquí, y esa diferencia va a ser una parte importante de lo que tenemos por delante.
¿Y cuál va a ser nuestro método de estudio? Van a ser papers de sistemas reales de empresas reales. La clase va a funcionar como un club de lectura técnico: vamos a leer estos papers y los vamos a discutir entre todos, y los temas de sistemas distribuidos van a ir emergiendo de esos casos de uso reales, en lugar de bajar desde una teoría previa. El primero que vamos a leer es el de MapReduce, un paper clásico de Google que se espera que leamos y entendamos antes de discutirlo en clase. La palabra “paper” puede llevar a confusión: no son papers académicos estrictos, en el sentido de un trabajo de investigación en abstracto. Son problemas de ingeniería reales que estas empresas tuvieron que resolver, y que después contaron. Se va a notar además que fueron tres las líderes de esta nueva era —Google, Amazon y Facebook son las que más innovaron—, y de ellas nos vamos a nutrir para la mayor parte de la materia. Los temas, en cambio, van a ser generales: en el programa figuran algunas cuestiones transversales que vamos a ir viendo una y otra vez, sin importar de qué sistema estemos hablando.
Todo eso lo vamos a estructurar en varios ejes temáticos de aplicación. El primero es compute: cuando una sola máquina no soporta el trabajo, ¿cómo hacemos para particionar un cálculo gigante entre muchas máquinas? El ejemplo típico es MapReduce. El segundo es storage, y a eso le vamos a dedicar gran parte de la materia, con muchísimos papers, porque es de las cosas más difíciles de hacer; ya nos vamos a ir dando cuenta de por qué. Ahí aparecen distintas variaciones del mismo problema: file systems distribuidos, bases de datos relacionales, bases de datos no relacionales. El tercer eje en el que queremos profundizar es el de stream processing, que no se trata de streams multimedia sino de streams de datos, procesados en tiempo real o casi real, junto con todo lo que es mensajería.
Mas alla de si en algún momento de nuestras carreras nos encontremos implementando uno de estos sistemas, la utilidad del curso se aplica en el saber cómo funcionan internamente. Con este conocimiento uno puede, incluso antes de consultar cualquier herramienta, intuir cuáles pueden ser los problemas y dónde puede fallar el sistema, y cuando lo usamos desde afuera vamos a poder entender mucho mejor las garantías que nos ofrece. Un ejemplo concreto: si escribimos algo en DynamoDB y lo leemos inmediatamente después, es posible que nos devuelva un valor diferente del que acabamos de escribir. Esa clase de comportamientos resultan misteriosos para la mayoría de la gente que los sufre, y nosotros vamos a entender por qué DynamoDB tiene consistencia eventual. Después de hacer el trabajo de Raft va a ser obvio por qué surge: va a transformarse en un problema inevitable con el que hay que convivir.
El paper que funda el sistema es Dynamo: Amazon’s Highly Available Key-value Store, de DeCandia et al., presentado en SOSP 2007; recibió el ACM SIGOPS Hall of Fame Award en 2017. Dynamo es el sistema interno que ese paper describe, y DynamoDB el servicio público que Amazon construyó después.
Hay además otras razones para leer papers, y tienen que ver menos con los sistemas distribuidos que con el oficio de ingeniero. La primera es que hay que saber leer, y no es una obviedad: se está subestimando mucho, justo ahora, la capacidad para comprender textos. Y sin embargo va a ser importante poder entender las cosas que están haciendo las inteligencias artificiales, interpretarlas bien y también alimentarlas, darles contenido de manera que hagan cosas. La segunda es saber interpretar diagramas, y aquí conectamos con lo anterior, porque los diagramas son siempre variaciones de sistemas. Si abrimos el paper de Google File System, que vamos a ver la próxima vez, y pensamos ese dibujo como un sistema, lo que tenemos es la frontera de un sistema que se llama master; esos otros de al lado son subsistemas, los chunkservers; y todo el conjunto es el Google File System. Ese tipo de lectura, y entender cómo se comunican esas partes entre sí, es lo que hay que poder sacar de un diagrama. Estas cosas se aprenden practicándolas, leyendo y tratando de entender una fuente primaria: el paper mismo, no un libro que lo explica.
La última razón es la de los patrones. Después de leer toda esa cantidad de papers vamos a ver que, si bien son sistemas diferentes, hay muchos patrones que surgen siempre. Por ejemplo, en los primeros papers siempre hay una especie de master central, coordinador o primary, que coordina cosas. Eso va a surgir naturalmente de ver varios papers, y va a quedar claro que es un patrón común, uno de tantos de ese tipo. Lo importante es descubrirlo por cuenta propia al comparar un paper con otro, y no que nos lo enumeren de antemano. Para complementar vamos a ir recomendando también algunos libros. El de esta primera clase no es un paper sino un libro, escrito por dos profesores del MIT, Jerome Saltzer y Frans Kaashoek: es mucho más básico que lo que queremos ver nosotros, del tipo de un primer curso de sistemas en general, pero tiene un par de cosas que sirven bien para una clase introductoria como esta.
Principles of Computer System Design: An Introduction, Jerome H. Saltzer y M. Frans Kaashoek, Morgan Kaufmann, 2009. De ahí sale el marco de las tres abstracciones de la subsección siguiente, y también varias de las figuras que se proyectan a lo largo de la clase.
Abstracciones fundamentales
Saltzer y Kaashoek parten del proponer que existen tres abstracciones fundamentales en nuestra area. La observación de fondo es que los componentes que forman los distintos sistemas siempre terminan cayendo, y a veces superponiéndose, en apenas tres funcionalidades básicas. Y esto es lo que nos va a permitir llegar después a una definición de los sistemas distribuidos que vamos a estudiar.
La primera es la memoria, la segunda son los intérpretes y la tercera son los enlaces de comunicación. En nuestra disciplina siempre estamos ante variaciones de esas tres.
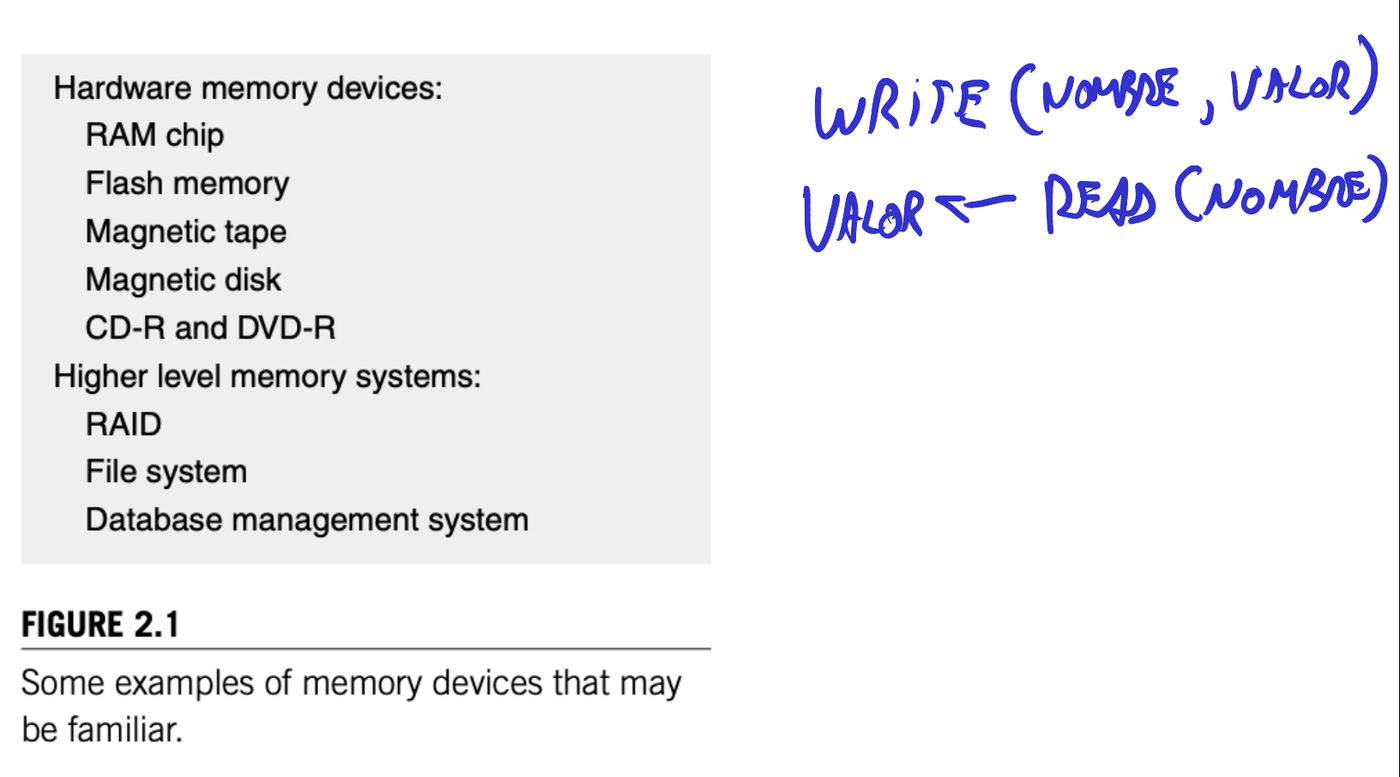
Lo primero que conviene despejar es la idea de que estemos hablando necesariamente de hardware. Si uno piensa en dispositivos de memoria, los ejemplos obvios son de hardware: la flash memory, que se llama memoria y evidentemente lo es. Pero hay cosas bastante más de alto nivel que representan exactamente la misma abstracción. El RAID, por ejemplo, esa capa de software que junta varios discos y hace que parezcan uno solo. El file system es una abstracción de memoria, y los sistemas de base de datos son, para nosotros, otra abstracción de memoria.
Si todas esas piezas son una misma abstracción, tiene que haber una esencia compartida, y esa esencia es la interfaz. Se puede interpretar que la memoria está caracterizada por una interfaz de esta forma: una operación write(nombre, valor), a la que se le pasa un nombre y un valor, y otra que escribimos valor ← read(nombre). Esto es muy abstracto: ese nombre puede ser una dirección en binario de la memoria física, pero también puede ser el nombre de una variable. Lo importante, la esencia de la abstracción de memoria, es que lo que uno pone ahí el sistema lo recuerda, y cuando después hace read le devuelve el mismo valor que le puso.
write(address, buffer)
read(address, buffer)
En nuestro estudio, lo más parecido a esta abstracción van a ser los sistemas de storage: sistemas en los cuales queremos escribir bytes y queremos que el sistema nos los devuelva en el mismo orden en que los guardamos.
La segunda abstracción es el intérprete. Lo primero que uno piensa al escuchar la palabra es, de vuelta, un procesador, un pedazo de hardware. Pero un intérprete puede ser cualquier cosa que ejecute código: desde los procesadores físicos hasta la máquina virtual de Java o Node.js. Hasta la máquina de Turing podría considerarse una abstracción de un intérprete, aunque tenga además una memoria y algunas cosas más.
¿Y qué hace un intérprete? Tiene un entorno en el cual se ejecuta, tiene un lugar donde están las instrucciones, toma una instrucción, la interpreta y guarda el resultado en la memoria. En nuestro caso va a ser el elemento que hace cosas.
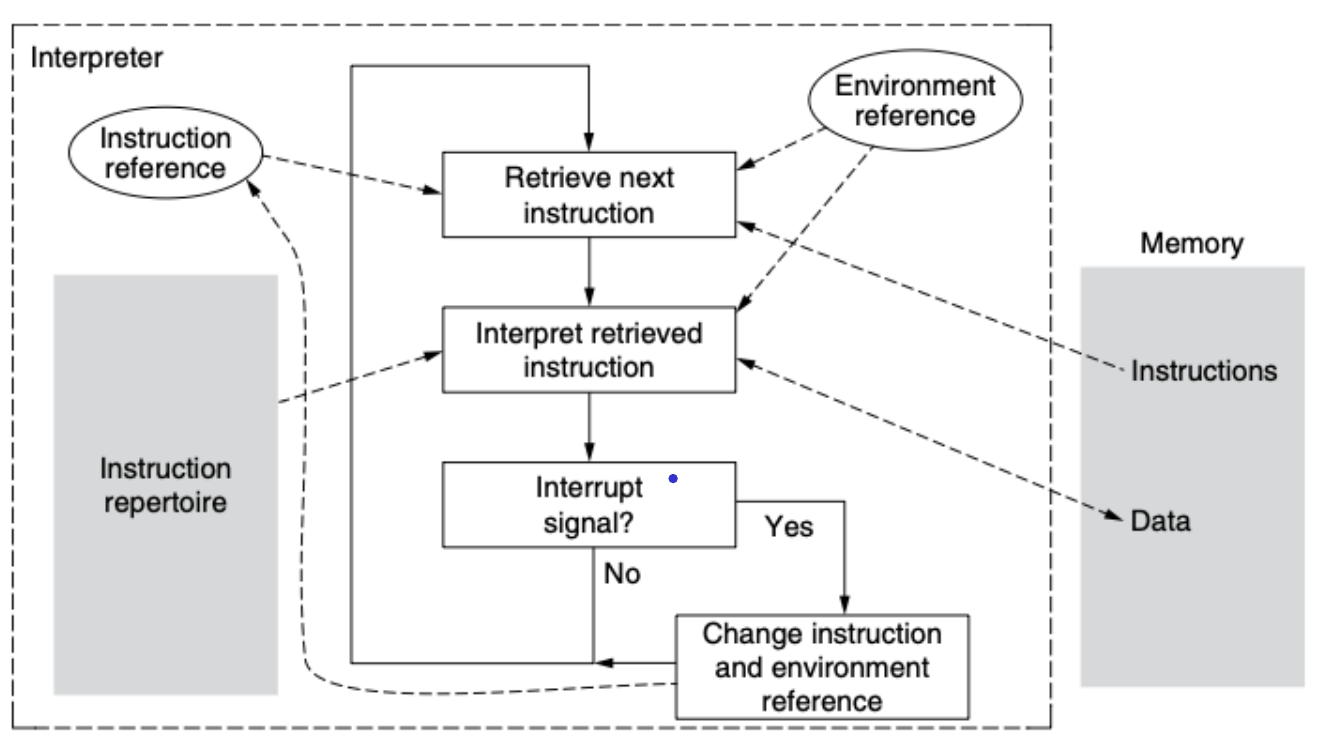
Estas dos primeras abstracciones vienen acompañándonos desde hace tiempo: durante toda la carrera vimos distintas variaciones de intérpretes y de memorias sin llamarlas así. Aprender a programar, por ejemplo, es aprender a usar un intérprete; el lenguaje en sí podría considerarse un intérprete que usa una memoria para ir guardando cosas.
La tercera son los enlaces o canales de comunicación, y con ellos la historia cambia. Son, en principio, lo que uno correctamente puede interpretar como una red. Si la memoria tenía una interfaz fundamental que era write y read, los enlaces van a tener una que es send y receive. El send lleva un nombre y un buffer con lo que se quiere mandar; el receive lleva un nombre y un buffer donde se lo quiere recibir.
send(channel, buffer)
receive(channel, buffer)
Inicialmente parecería que es exactamente lo mismo que una memoria. Pero ahí ya hay que ir más allá de la interfaz —que sí es parecida— e ir a la realidad, porque lo que suelen tener abajo los enlaces tiene semánticas muy diferentes. Para empezar, son secuenciales. En la memoria cada “nombre” era una variable o una dirección; en un enlace ese nombre suele ser el nombre del canal, y por ese mismo nombre se mandan cosas una después de la otra, que llegan a veces ordenadas y a veces desordenadas.
Los enlaces de comunicación sirven, entre otras cosas, para conectar dos computadoras mediante un cable (o abstracciones de ese cable). Y al conectar dos componentes mediante un enlace físico aparecen problemas que no aparecen con la memoria. Esos links suelen ser poco confiables: se pueden romper, se pueden perder paquetes, pueden ser lentos, y el orden en que se mandan las cosas no está garantizado. En la memoria uno no tiene el problema de escribir un valor y después otro y que lleguen en desorden. Con los enlaces vamos a ver que hay maneras de solucionarlo, pero de entrada nadie nos garantiza nada. El caso extremo es todavía peor: puede perderse completamente lo que se mandó. Uno puede hacer un send y el que hace receive del otro lado no recibe nada, y también hay que recurrir a ciertos mecanismos para que eso no ocurra.
¿Por qué querríamos, entonces, una abstracción tan deficiente? Porque es inevitable: las computadoras hay que conectarlas entre si, y ese cable que se utiliza tiene esos problemas. Vamos a ver enseguida que si vamos demasiado lejos con las abstracciones y nos olvidamos de cómo están implementadas, a veces surgen problemas, porque no funcionan como en nuestra imaginación ideal querríamos.
Abstracciones de comunicación
De las tres abstracciones, la última merece más detenimiento, porque los enlaces son un elemento central de esta materia. En abstracto, un enlace de comunicación es esto: un nodo, otro nodo, y la línea que los une. El enlace es esa línea, y nada más.
Dicho así, el dibujo no dice demasiado. Lo que hace falta saber es cómo se manifiestan esos enlaces, y en nuestro curso se manifiestan como redes. Las redes van a ser el principal tipo de enlace que vamos a usar, y la forma en que se conectan estas tres abstracciones va a ser lo que define un sistema distribuido tal como lo entendemos nosotros.
Antes hace falta un repaso breve de los modelos de redes, con una pregunta encima: cuál es el nivel de abstracción en el que vivimos nosotros, hasta dónde nos interesan pensando como sistema.
Toda clase de redes arranca por el modelo OSI, el estándar que publicó ISO. Empieza con la capa física, y encima vienen la capa de enlace, la de red, la de transporte, la de sesión, la de presentación y la de aplicación. A nosotros rara vez nos hace falta tanto detalle.
El modelo está publicado como ISO/IEC 7498-1, Information technology — Open Systems Interconnection — Basic Reference Model.
Hay un lugar donde el modelo se vuelve incómodo, y es arriba de todo: las capas de presentación, sesión y aplicación suelen aparecer mezcladas entre sí. Hay quienes dicen que HTTPS es la capa de sesión y que lo que está por encima es la capa de aplicación, y la discusión resulta francamente confusa. Desde el punto de vista de alto nivel en el que vivimos nosotros, esa subdivisión termina siendo un poco redundante.
El modelo de internet, también conocido como modelo TCP/IP, mejora bastante el panorama, y lo hace unificando. Lo primero que unifica son las dos capas de abajo, la física y la de enlace, que pasan a llamarse capa de acceso a la red. Después la capa de red sobrevive con la misma funcionalidad de siempre, encima está la capa de transporte, y arriba de todo aparece la gran unificación, que es la capa de aplicación: si buscamos un equivalente en OSI, corresponde a esas tres de más arriba tomadas juntas.
El foco de esta división se ve apenas uno mira dónde cae cada protocolo. En la capa de red está IP, y en la capa de transporte están TCP y UDP, que son los dos principales. Hay otros, por supuesto: en la capa de red vive también ICMP, el protocolo del que se vale ping para averiguar si una máquina responde.
Nosotros lo vamos a simplificar todavía más, porque a fines practicos son principalmente tres capas. Abajo de todo sobrevive la capa de enlace: cómo se conecta una máquina físicamente con otra. Ahí queda mezclado todo lo que es la parte física, y principalmente los protocolos de Ethernet, Wi-Fi y Bluetooth.
Encima viene la capa de red, la que hace que las cosas lleguen de un lugar a otro pasando por varios de esos enlaces. Esa definición, por suerte, es consistente en los tres modelos: se trata de saltar de una red a otra para que las cosas se ruteen. El principal problema que resuelve es el ruteo de paquetes a través de una red heterogénea: algunos tramos son Ethernet, otros son Wi-Fi, y los paquetes igual llegan de un lugar a otro.
Y arriba de todo, lo que a nosotros como programadores nos interesa son las tres capas superiores tomadas juntas, que podríamos llamar end to end, porque ese es típicamente el problema que vamos a resolver. A este nivel no nos interesa tanto cómo son los frames de Ethernet ni cómo funciona el ruteo. A nosotros nos interesa que una máquina, que puede estar en cualquier lugar del mundo, pueda mandarle un mensaje a otra máquina que está en otro lugar del mundo. Nuestros canales de comunicación viven ahí: eso es la materia.
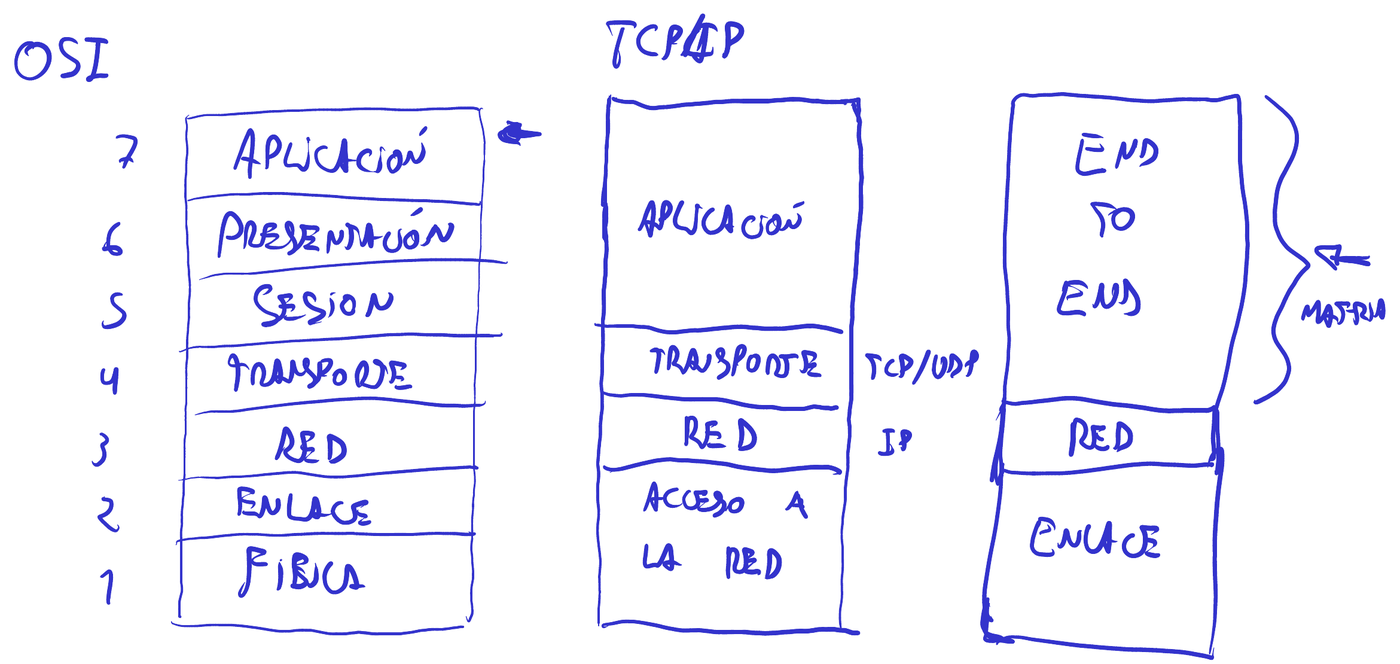
Aparece naturalmente la pregunta de cómo se llama este último modelo. No tiene un nombre oficial, sino que lo itroducimos nosotros para ilustrar justamente el nivel en el que nos vamos a estar moviend en esta materia. Vamos a ver que probablemente nunca más volvamos a hablar del protocolo IP, y que vamos a asumir sin más que las cosas llegan de alguna forma. Pero sí va a resultar interesante la diferencia entre TCP y UDP, porque cuando uno está desarrollando una aplicación necesita saber si tiene la garantía de que las cosas llegan ordenadas, o si en cambio se pueden perder o llegar en cualquier orden. Eso no va a ser totalmente transparente: al final de la clase vamos a ver un ejemplo donde tenemos que usar TCP para obtener ciertas garantías.
Estos nodos se mandan mensajes entre sí. Un mensaje es, conceptualmente, algo abstracto: un paquete de información de alto nivel que un nodo le manda a otro. Pueden ser de tamaño fijo o variable, muy grandes o muy pequeños, y puede haber distintos tipos.
Hay diseños de sistemas distribuidos que hacen mucho énfasis en los mensajes y hay otros que los esconden un poco más. Al final de esta misma clase vamos a ver uno que esconde el mensaje y hace que todo parezca una llamada a un procedimiento. Y hay otros, como los message oriented middleware, donde esos mensajes son explícitos.
Sockets en C
Todo esto se materializa de una manera muy concreta apenas uno se sienta a escribir código, y vale la pena verlo por lo menos una vez: un servidor y un cliente que se comunican por sockets. Quien haya programado sockets alguna vez probablemente lo haya hecho en Python; la versión que vamos a mirar es la de C, la de bajo nivel. Estas son las system calls con las que se programan los sockets.
La pregunta natural es cómo se hace un servidor. Del lado del servidor la respuesta es una secuencia de llamadas al sistema engorrosa para los estándares actuales, aunque conviene recordar que esta es una tecnología muy antigua y que buena parte de su forma se explica por su edad. Lo primero es llamar a socket(). Después hay que hacer bind(), que asocia ese socket a una dirección. Después listen(). Después accept(), para aceptar una conexión. Después read(). Y eventualmente se lo cierra con close().
Lo interesante de esa secuencia es otra cuestión: aquella división de capas que acabábamos de unificar reaparece unificada también en el código. Cuando uno arma el socket le tiene que pasar SOCK_STREAM, y eso es decirle que queremos un socket de tipo TCP; si quisiéramos uno de tipo UDP le pondríamos otra flag, SOCK_DGRAM. Aun estando parados en la capa de aplicación, entonces, estamos tomando una decisión sobre la capa de transporte. Es exactamente lo que anticipábamos: como diseñadores la decisión nos llega hasta la capa de transporte, y esa elección nos toca a nosotros.
En este ejemplo estamos usando un stream porque prácticamente todas las aplicaciones que hay ahora usan TCP. Y usan TCP porque sus garantías nos facilitan enormemente la vida: que las cosas lleguen ordenadas, y que si llega algo esté garantizado que no van a faltar cosas en el medio. Eso permite sacar una cantidad de código de nuestra aplicación y pasárselo a TCP, que lo resuelve de manera automática.
El cliente no es tan interesante: también arma un socket, y también hay que decirle de qué tipo lo queremos. De ahí en adelante es más fácil, porque simplemente se conecta, después empieza a leer (o escribir) y eventualmente cierra.
Aquí aparece por primera vez otro de los términos que van a reaparecer con distintas interpretaciones: cliente y servidor. A nivel de sockets, a nivel de TCP, la diferencia es clara: el cliente es el que inicia la comunicación; el servidor es el que está ahí escuchando y recibe la comunicación. Nosotros vamos a hacer más adelante una interpretación más de alto nivel que podemos anticipar ahora: el cliente va a ser el que pide, el que necesita algo, y el servidor el que tiene eso que hace falta y se lo da. Existe una asimetria en la funcionalidad que estos dos componentes proveen que exceden simplemente el protocolo de conexion inicial.
Cliente y servidor se dicen, además, para diferenciarlos de peer to peer, donde tenemos dos máquinas que son iguales: tienen el mismo código, tienen distinta información, pero son dos pares iguales entre sí. Lo interesante es lo que ocurre cuando esas dos máquinas se ponen a hablar: lo más probable es que se conecten por alguna red TCP/IP y por sockets, así que uno de los dos pares, visto desde el punto de vista de los sockets, va a actuar como cliente y el otro como servidor, simplemente porque una máquina se quiere conectar a la otra. Los dos niveles de lectura conviven sobre el mismo par de máquinas, y por eso todo esto resulta mas confuso para el estudiante.