4. State transfer, máquina de estados y orden de las operaciones
Esos mecanismos no son tantos, y son los que después vamos a ver aparecer, de una forma u otra, en los papers.
La primera forma de replicar, la más intuitiva, es la que se suele llamar state transfer, también conocida como snapshot. Supongamos dos máquinas, nodo uno y nodo dos. El state transfer consiste en tomar toda la memoria del nodo uno —no en el sentido de RAM, sino todo el disco— y transferírsela a la otra: un cp remoto, un scp, hacia el nodo dos. Eso evidentemente va a funcionar, y también se puede sospechar que tiene problemas.
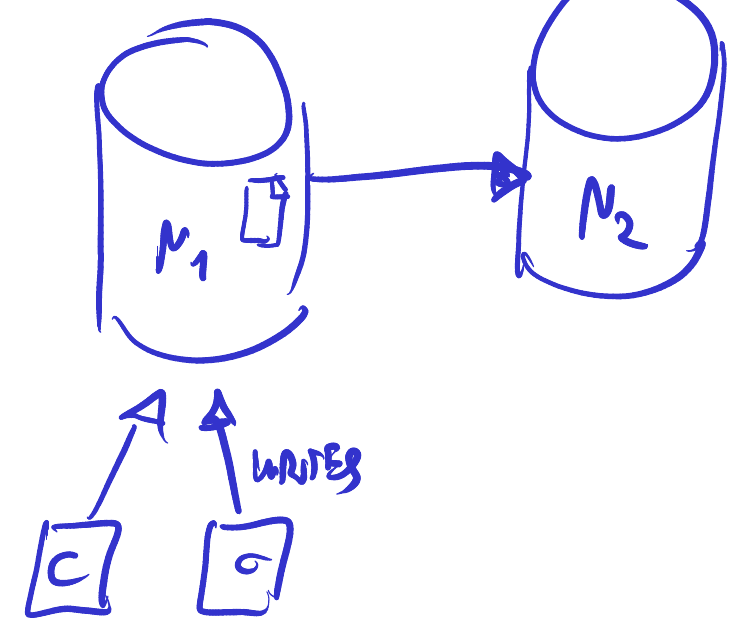
Primera cuestión: ese storage puede ser de varios gigabytes, o terabytes. Supongamos el terabyte del ejemplo anterior y una red de un gigabit por segundo, que además compartimos con el tráfico normal. Transferir esa copia entera tarda más de dos horas: el primer problema es que es lento.
El segundo, también evidente, es que mientras copia vamos a tener clientes enviándole operaciones al nodo uno, y muchas van a ser writes. ¿Cómo seguimos recibiendo writes y enviamos el snapshot al mismo tiempo? El snapshot va a quedar parcialmente correcto y parcialmente incorrecto. Así planteada, la pregunta no tiene respuesta. Una forma de resolverla es que el nodo uno detenga toda actividad: que deje de atender clientes mientras dura la copia. Pero recordemos cuánto dura: dos horas sin servicio.
El beneficio, en cambio, es que es simple: muchas veces se reduce a copiar los archivos y ya funciona.
Por esos dos problemas, principalmente el segundo, no se suele usar de manera aislada: los sistemas que se replican únicamente por snapshot no llegan a ser muy útiles. Lo que se hace es combinarlo con la segunda forma.
Esa segunda forma se llama máquina de estados replicada. Apareció la clase pasada, porque es una de las innovaciones que propuso Lamport —no está claro si la inventó o la formalizó—, y se basa en un principio muy simple. Supongamos que esa base de datos es determinista y que le enviamos muchas operaciones seguidas: o₁, o₂, o₃, o₄. Si le enviamos esas mismas operaciones a otra base, el estado va a ser el mismo. De modo que basta con tomar dos bases —en el sentido amplio, dos nodos— y enviarles las operaciones en el mismo orden.
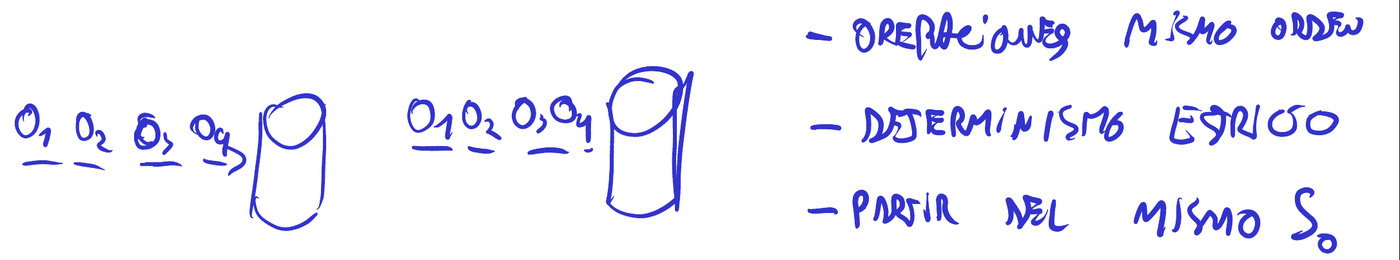
Dicho así, sin embargo, no alcanza: hacen falta requisitos. Uno es que las operaciones lleguen en el mismo orden. El otro es que esas máquinas tengan determinismo estricto, que en términos más formales quiere decir que si la máquina está en un estado determinado y le enviamos una operación conocida, no hay varias opciones de estados a los que puede llegar, sino uno solo y conocido.
Esa es la manera compleja de decirlo. En la práctica, y especialmente en los sistemas de storage, casi siempre esa propiedad la tenemos por default. Para ilustrar su importancia sirve el ejemplo del banco: si agregamos 2.000 al saldo, no queremos que a veces agregue 1.000, a veces 200 y a veces 500, sino que el saldo final sea lo que teníamos más 2.000. Estos sistemas ya están pensados para ser deterministas porque los necesitamos así, y lo mismo vale para un write en un file system: no queremos que a veces se lea una cosa y a veces otra.
Y hay un tercer requisito, partir del mismo estado inicial —llamémoslo S₀—, que va a reaparecer más adelante. Si dos máquinas parten del mismo estado inicial, reciben todas las operaciones en el mismo orden y son deterministas en el sentido fuerte, entonces van a estar siempre sincronizadas: si leemos un dato de una y de la otra, leemos el mismo.
Evidentemente hay sutilezas. ¿Cuál es la principal? Cómo conseguimos que las operaciones lleguen exactamente en el mismo orden a las dos máquinas. Porque la parte de la máquina ya está resuelta: se instala Postgres y tenemos una máquina de estados determinista. La pregunta es cómo garantizamos el orden.
Que ese orden no es automático se ve con un caso mínimo. Tenemos dos máquinas y un cliente: si ese único cliente quiere enviar las operaciones uno y dos, le envía la uno a ambas máquinas y después la dos a ambas. Ahí no hay problema. Pero es la versión que nunca se da en la práctica: nunca tenemos un solo cliente.
Agreguemos el segundo, que interviene con la operación dos. Cada cliente le envía la suya a las dos máquinas. Como hay una red en el medio y los dos clientes no están sincronizados entre sí, puede ocurrir que la primera máquina reciba primero la operación uno y la segunda reciba primero la dos. Después le llega a cada una la que faltaba, y quedaron en órdenes distintos.
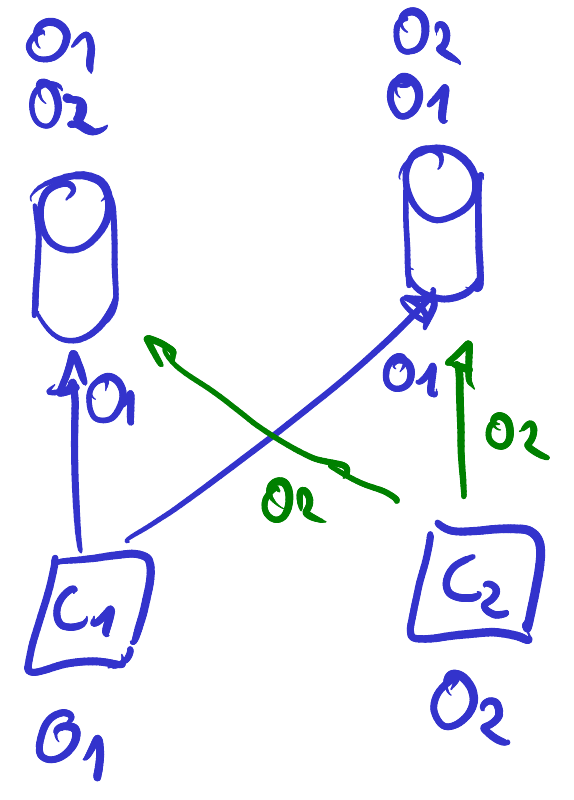
De modo que si no tomamos precauciones, por default el orden no se respeta nunca, y la replicación no funciona. De hecho, todo el esfuerzo de esta clase va a estar dirigido a que esas operaciones lleguen en orden: básicamente todo lo que hace Raft —el del trabajo práctico— es lograr eso. La única excepción sería que lo único que hiciéramos fuese sumar; en cuanto agregamos operaciones no conmutativas, el problema se manifiesta.
El problema tiene nombre. Garantizar el orden es una variación de lo que vamos a ver como problema de consenso; de hecho es el gran problema de consenso: decidir cuál es la siguiente operación, la parte difícil de toda replicación. Si replicamos por máquina de estados y no por snapshot —que es lo que hace la mayoría—, ¿cómo decidimos el orden? Eso es lo que hace difícil a la replicación, en contraposición con el sharding, donde este problema no existe: allí las dificultades aparecen cuando queremos hacer transacciones que tocan varios shards a la vez.
El problema básico es cuál es la siguiente operación. Pero el que se manifiesta siempre —y quien haya leído el artículo de la bibliografía ya lo habrá encontrado— no es tanto decidir la siguiente, sino decidir el orden de todas a medida que van apareciendo.