6. Asignación de timestamps con TrueTime
En esta sección
Timestamp de las lecturas
Con TrueTime llegamos a la pregunta pendiente desde el principio: cómo se logra linealizabilidad. Tenemos el intervalo y las primitivas; falta ver cómo usarlos.
Empecemos por un caso hipotético con tiempo absoluto. Es justamente lo que no vamos a poder hacer, pero conviene dibujarlo porque es la referencia. Tenemos una transacción uno, de escritura, y en el futuro una dos, de lectura: una escribe x = 1, la otra lee x.
¿Dónde van los timestamps? Al commit de la de escritura va el timestamp de escritura, y al start de la de lectura va el de lectura. Es bastante lógico: el timestamp de la escritura hay que ponerlo una vez que ya están guardadas todas las cosas, porque es el momento en que se escribieron esos valores. En una computadora local, con una sola fuente de tiempo, o en una base de datos común, funciona así.
Pongámosle números. La escritura tiene timestamp 10, definido en el commit; la lectura, que ocurrió después, tiene 11. Simplemente se le pide al reloj local, y funciona: la lectura ve los valores guardados con timestamp 10. Coincide el timestamp de la versión guardada con el de la lectura, y está todo bien.
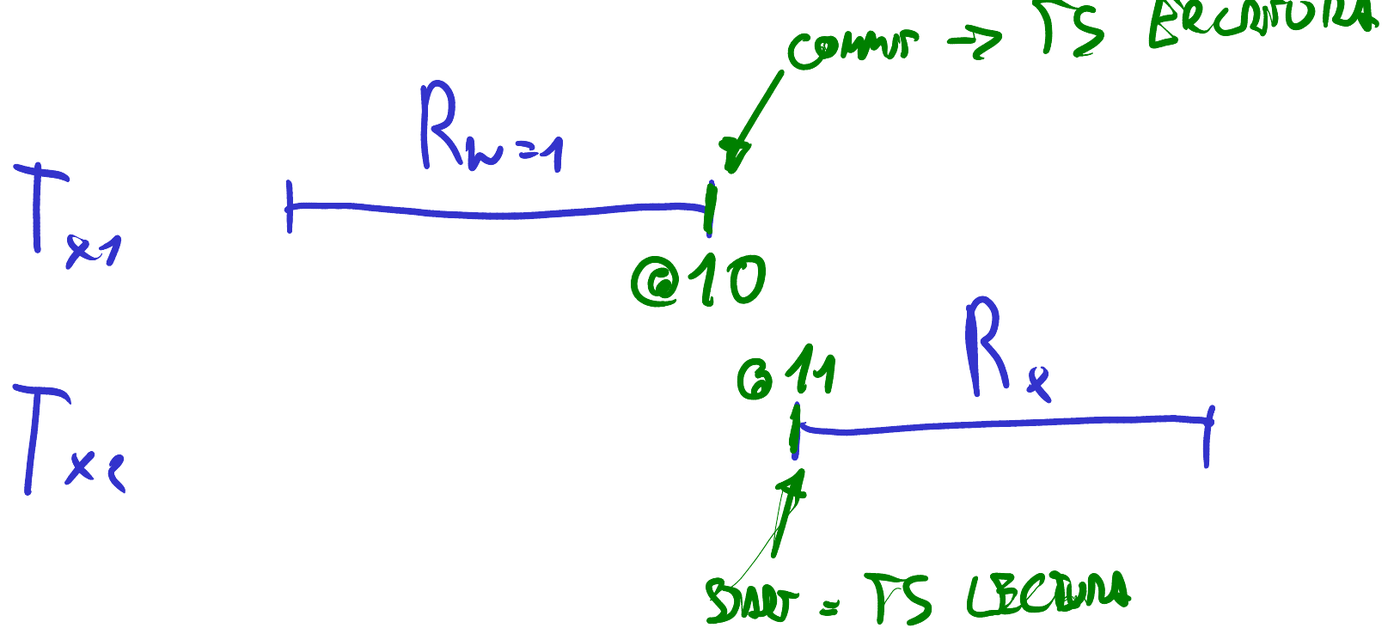
El problema es que no podemos obtener esos valores: obtenemos intervalos, y hay que ver cómo se mapea un intervalo a la transacción, lo cual no es trivial.
Aquí hay una confusión fácil de cometer. TrueTime nos da intervalos, pero para el MVCC no vamos a guardar intervalos: cada valor se guarda con un time preciso, uno solo, y cada lectura también lleva un time preciso. Teniendo un intervalo, hay que elegir un timestamp en particular a partir del earliest y el latest. Es más fácil verlo para una lectura, así que empecemos por ahí.
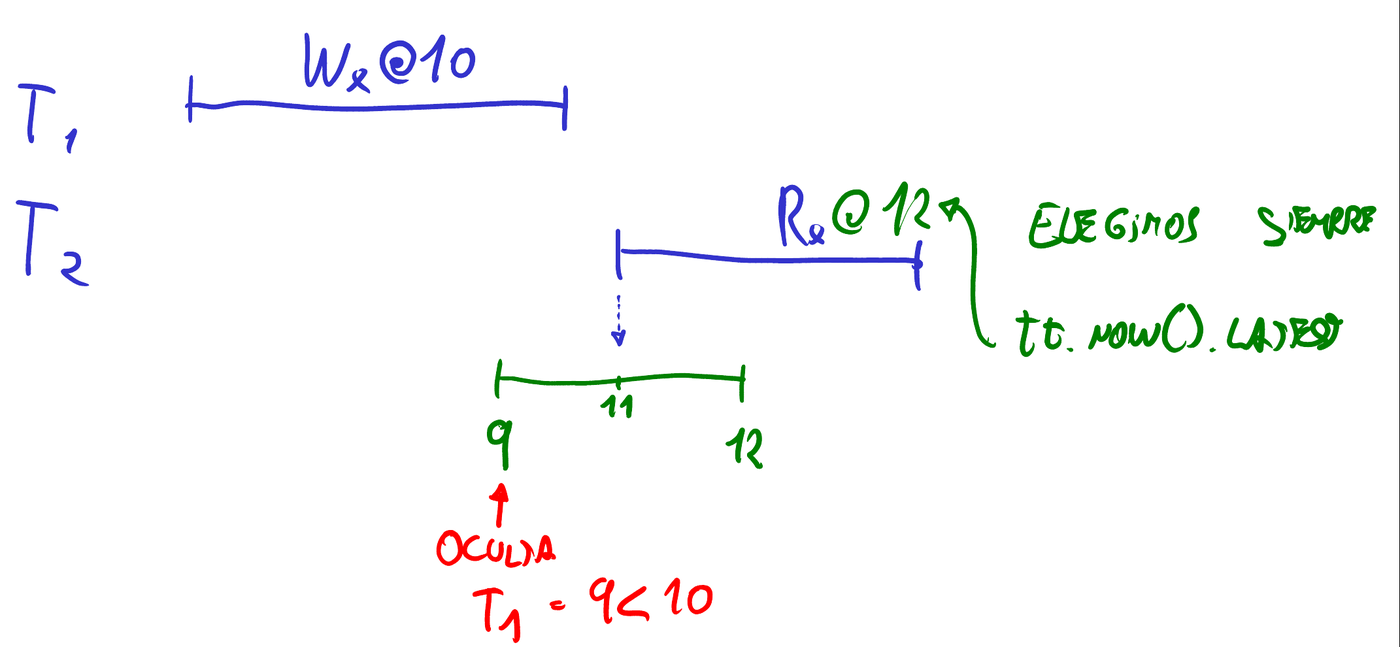
Hagámoslo al revés de lo natural: supongamos que ya resolvimos la escritura, que escribimos x en el 10, y ahora definimos el de la lectura.
La diferencia con el caso hipotético es que no nos devuelve un 11, sino el intervalo de TrueTime. Sobre una línea de tiempo: el tiempo real está en el 11, y lo que nos devolvió es 9 y 12.
El earliest está garantizado en el pasado del tiempo real, y el latest garantizado en el futuro. En este ejemplo el tiempo real es 11, pero ese 11 —lo que hubiéramos obtenido con tiempo absoluto— no lo podemos saber. Sí sabemos el 9 y el 12.
No vamos a elegir un valor aleatorio del medio: tenemos que elegir el earliest o el latest como time de la transacción.
El caso fácil es el primero. Si eligiéramos el earliest, si pusiéramos que la lectura ocurrió en el 9, el problema queda claro. La escritura está en el 10, y aunque en tiempo real la lectura pasó después, no veríamos esa escritura que pusimos antes. Ese valor nos oculta la transacción uno, básicamente porque 9 es menor que 10. Y nosotros queremos ver esa escritura que ocurrió en el 10.
La solución es la que uno adivina siguiendo el razonamiento: elegir el latest, siempre un valor garantizado en el futuro. Con un timestamp de lectura garantizado del futuro, vamos a poder ver las cosas anteriores.
Prestando suma atención aparecen algunos problemas —interviene también el safe time, y otras cosas complicadas—, pero por ahora vamos con el caso fácil de una escritura y una lectura.
La regla queda así: para la lectura elegimos siempre TT.now().latest. Y para las lecturas eso, básicamente, funciona.
Timestamp de las escrituras: start rule y commit wait
Para las escrituras la cuestión es más difícil, y es el último tema: cómo definir el timestamp de las read-write.
Hagamos el mismo dibujo: T1 escribe X y una posterior T2 lee X. Supongamos que al commit hacemos lo que funcionó para la lectura: pedimos un intervalo de TrueTime, que da 9 y 12.
¿Cuál es el problema? La lectura hizo lo mismo: obtuvo 10 y 11, y toma el 11. Tenemos el mismo problema de antes, pero al revés: si elegimos el latest para la escritura, que ocurrió antes, le pusimos un time del futuro —el 12— y la ocultamos. La lectura no la puede ver.
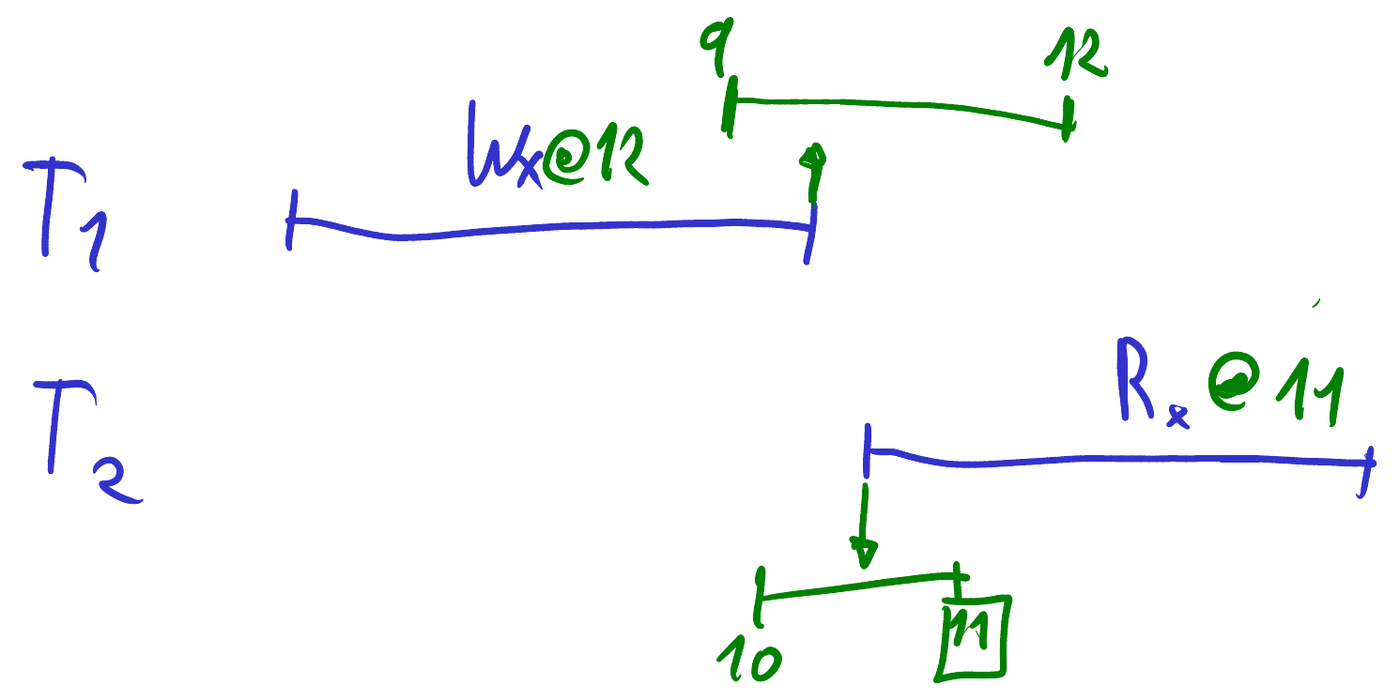
La alternativa obvia es el timestamp del pasado, el 9. Es más sutil, pero tampoco se puede: ponerle un timestamp del pasado a una escritura que ocurre ahora es arriesgarse a reescribir el pasado. Como enseña Volver al futuro, reescribir el pasado no es buena idea, y en Spanner tampoco lo es.
El caso más fácil de ver es el snapshot read, en el que uno elige en qué timestamp del pasado leer. Si antes de la escritura hacemos un snapshot read en 10, no vemos esa escritura que todavía no ocurrió. Después ocurre la escritura, con un timestamp del pasado, y si volvemos a hacer un snapshot read en 10, nos da un valor diferente para el mismo dato. Los tres movimientos: leemos en el 10, escribimos con un timestamp anterior al 10, y volvemos a leer en el 10. Eso es claramente inconsistente: la misma lectura del pasado dio dos valores distintos.
Por ese caso, y por algunas otras sutilezas más, no podemos elegir valores del pasado: va a tener que ser un valor del futuro. Ese es el caso más fácil de entender de por qué no se puede, pero el problema del latest que oculta la escritura hay que solucionarlo igual.
Google diseñó dos reglas que generan un delay artificial. Son dos, están en el paper y se llaman así.
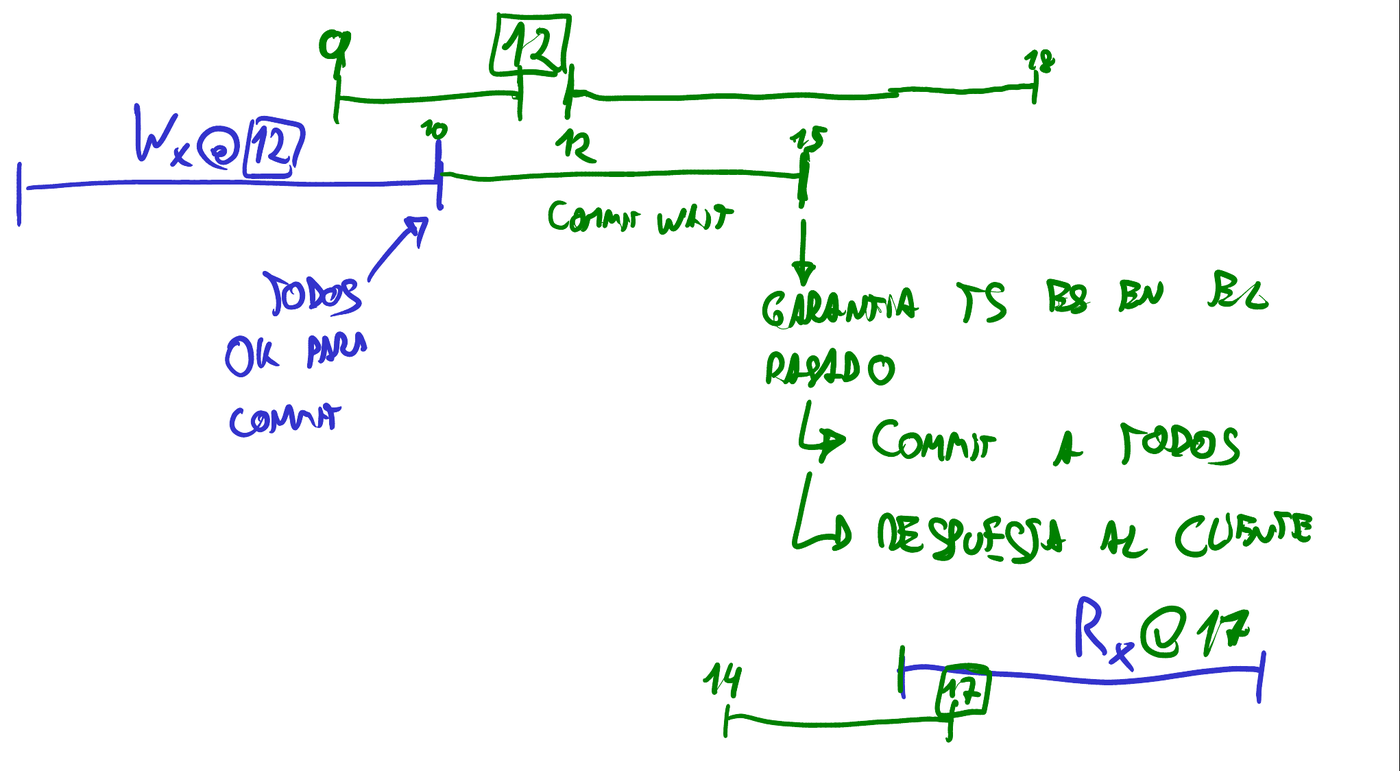
La primera es la start rule. No hay que confundirla con el start de la transacción, algo que confunde bastante al leer el paper: es el start de la fase de commit. Consiste en tomar TT.now().latest en el momento en que al coordinador le llega el pedido de commit. Ese valor es el timestamp de la transacción.
El paper agrega una condición más sobre ese timestamp, en su sección 4.2.1: también tiene que ser mayor que cualquiera que ese líder haya asignado a transacciones anteriores, para preservar la monotonía que hace funcionar el safe time.
La segunda parte es el delay, que se llama commit wait: esperar a que el timestamp elegido sea after now. Dicho así es confuso, así que hay que dibujarlo.
Tenemos lo que hubiera sido la transacción común. Al coordinador le llega el pedido de commit, y ahí aplicamos la start rule: obtenemos el TrueTime actual. Digamos que el tiempo real es 10 y TrueTime nos da 9 y 12. Después corre el prepare, y en un momento todos lo confirman. Ahí normalmente haríamos el commit en todos lados.
Pero antes hay que esperar: eso es el commit wait. Consiste en ir pidiendo el tiempo actual hasta que devuelva, por ejemplo, 13 y 18. El 18 no nos importa para nada. Imaginemos que en tiempo real eso ocurrió en el 15; recordemos que los tiempos reales no son accesibles.
Cuando pasa eso, tenemos la garantía que buscábamos. El valor de la transacción es el 12: la escritura queda at 12, el mismo 12 que tomamos con la start rule. Esperar —pidiendo now varias veces hasta que el nuevo intervalo arranque por delante del 12— garantiza que el 12 ya está en el pasado.
¿Y qué hacemos cuando tenemos esa garantía, la de que el timestamp de la transacción está en el pasado? Dos cosas en simultáneo. Por un lado mandamos el commit a todos los participantes, para que hagan visible el valor. Por el otro, algo que veníamos postergando: la respuesta al cliente, a quien nunca le habíamos respondido. Oficialmente el commit ocurrió solo en ese punto: el cliente lo vio en ese momento y no antes.
Si el cliente mandaba un read antes de eso, puede pasar cualquier cosa: puede verlo o no, porque los intervalos se superponen.
Lo interesante es el read posterior. Supongamos que el cliente manda la lectura después de recibir la respuesta. Obtiene un intervalo algo más pequeño —lo hacemos así a propósito, para enfatizar que el 18 de antes no servía para nada—: 14 y 17.
La regla de las lecturas era la fácil: tomar el latest. La lectura ocurre en el 17, que es mayor que el 12, así que ve la escritura. Y el commit no quedó respondido ni en el futuro ni en el pasado.
Toda esta parte es confusa, porque no se conoce el tiempo real ni los tiempos que va generando el sistema; pero estudiando las dos reglas, start rule y commit wait, se entiende cómo funciona. Es la parte difícil de la clase.
Garantías y costos
¿Qué logramos? Lecturas muy rápidas, porque no tienen locks. Y fuertemente consistentes: snapshot isolation y linealizables. Muchísima más garantía que la de DynamoDB.
Del paper hay cosas que no vimos y que ponen números sobre esto. Las tablas tres y cuatro comparan la velocidad de las escrituras con la de las lecturas. La read-only transaction y el snapshot read están en el orden de 1 milisegundo, contra 14 de la escritura. Y el throughput es mucho más alto, de una forma que dice algo sobre el diseño: agregar réplicas empuja las dos cifras en direcciones opuestas. Con una réplica el sistema hace 11.400 lecturas por segundo y 4.200 escrituras; con cinco, 46.800 lecturas y apenas 1.200 escrituras. Las réplicas que le cuestan throughput a la escritura le multiplican por cuatro el de la lectura, porque una lectura se resuelve contra cualquiera de ellas y una escritura tiene que pasar por todas. La tabla seis dice lo mismo: rapidísimo para las lecturas, y bastante bien pero lento para las escrituras.
Esto viene con dos costos, y los dos son esperas: a veces hay que esperar el safe time, del lado de las read-only, y a veces el commit wait, del lado de las escrituras. Es el costo de usar relojes para sincronizar: esas esperas no se pueden evitar, pero TrueTime las minimiza.
El paper permite ponerle número a este costo. La espera esperada del commit wait es de al menos dos veces la incertidumbre del intervalo, y como esa incertidumbre ronda los 4 milisegundos, la espera medida da unos 4 milisegundos —el paper aclara que se solapa casi siempre con la comunicación de Paxos, así que buena parte se paga de todos modos—. La tabla tres lo muestra en una sola línea: con una réplica y el commit wait deshabilitado, una escritura tarda 10,1 milisegundos; con el commit wait puesto, 14,1. Los 4 milisegundos de diferencia son exactamente lo que cuesta la regla.
Solo ahora se puede cerrar el argumento de los relojes atómicos, porque solo ahora se ve por qué hacían falta. Usando relojes de pared comunes se podría lograr lo mismo. Habría que usar intervalos, sí, pero más grandes, con una incertidumbre más grande, y eso retrasaría mucho más la espera. Cuanto más grande el intervalo —en el dibujo del commit wait se ve muy bien—, más hay que esperar, y más latencia tiene toda la escritura. Por eso se usaron relojes de varianza muy pequeña que además se actualizan cada 30 segundos.
Para concluir, es un ejemplo rarísimo de transacciones distribuidas, y algo que no se explicó en el primer dibujo es que son distribuidas globalmente. DynamoDB ahora tiene tablas globales, pero todo su Paxos estaba entre data centers de la misma región. En Spanner los data centers están por todo el mundo, muy distantes entre sí. Y eso no afecta a la lectura, el caso común, que se resuelve en el data center local sin coordinar con otro. Las escrituras sí tardan, porque están distribuidas por todo el mundo.
Que se hayan logrado transacciones con two-phase commit que funcionen bien, más o menos rápidas, en un sistema distribuido globalmente, es un logro. Por eso, quien lea el paper va a ver que es complicado: no es fácil lograr todo esto.