2. Sloppy quorum y hinted handoff
En esta sección
Quórum estricto y solapamiento de lecturas
La idea de los quórums ya nos es familiar desde la clase de Raft. Lo que quizás no sabíamos es que la formulación original es de un paper de Gifford de 1979, y es exactamente la fórmula que conocemos: R + W tiene que ser mayor que N. Las réplicas que consultamos en una lectura, más las réplicas donde asentamos una escritura, tienen que superar el total de réplicas.
Por qué funciona es un argumento de conteo, el principio del palomar: si se cumple la desigualdad, una lectura y alguna escritura reciente siempre se solapan en al menos un nodo. Tenemos N casilleros; la escritura marca W y la lectura visita R, y si R + W supera N esos dos conjuntos no pueden ser disjuntos. Hay por lo menos un nodo que estuvo en las dos operaciones, y ese nodo le cuenta al que lee lo que hizo el que escribió.
En Raft ese quórum era bastante estricto, y quien hizo el trabajo práctico lo vio en detalle. Si una escritura no conseguía quórum, se le devolvía un error a quien escribía, y eventualmente Raft descartaba esas entradas, justamente porque nunca habían llegado al quórum. O podía ocurrir lo contrario: que eventualmente llegaran y el quórum se armara a posteriori. Dynamo es mucho más relajado.
Coordinador de escritura y quórum de escritura
Los valores típicos de Dynamo son N = 3 —configurable, pero tres es lo habitual—, W = 2 y R = 2. La fórmula de Gifford se cumple con lo justo: dos más dos supera a tres.
Partamos de una versión simplificada del sloppy quorum, que después vamos a corregir. Supongamos que me escribo a mí mismo y trato de escribirles a dos vecinos. Si ninguno responde, le respondo OK al cliente de todos modos. El dato quedó guardado en un solo lugar, con la mitad de la durabilidad prometida. Eso es best effort: un intento de conseguir quórum que, cuando no lo consigue, se conforma con lo que salió y sigue.
La mecánica real es un poco distinta, y ahí está la gracia. En lugar de responderle al cliente habiendo escrito en un solo lugar, Dynamo toma el siguiente nodo del anillo —o cualquier otro— y escribe ahí. Si no puede escribir donde corresponde, elige otro lugar y deja para más adelante la tarea de reubicar el dato. Lo importante es que el dato queda durable en dos lugares, y recién entonces le responde al cliente. De ahí el nombre: un quórum desordenado, que se conforma con lo que hay.
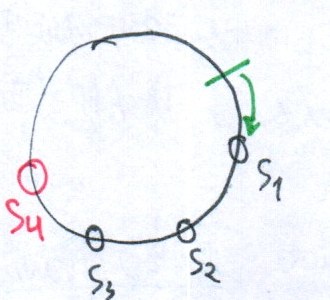
Las escrituras pasan por un coordinador, y el mismo mecanismo nos va a servir para las lecturas. El cliente sabe cuáles son los tres nodos del anillo que le tocan a su clave: los tres consecutivos siguiendo el anillo desde donde cae el hash, la preference list. Le manda la escritura a uno y le asigna, en efecto, el rol de coordinador. Por omisión es el primero de los tres, y si la escritura llega a un nodo que no está entre ellos, ese nodo se la reenvía al primero; pero hacer coordinar siempre al primero repartía la carga de manera desigual y llegaba a violar el SLA, así que se admite que coordine cualquiera de los tres. El coordinador escribe localmente y trata de escribirles a los otros dos. Si uno está caído, elige otro nodo y le envía el dato. Con eso tiene el valor en dos lugares y llegó al quórum; pero aun cuando no llegue a dos, elige algún otro nodo y le envía el valor.
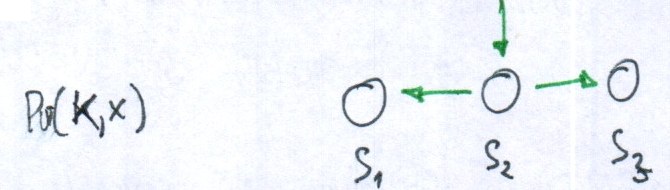
Con nombres queda más claro. Supongamos que el coordinador es S2 —cuál sea no importa demasiado—. La preference list serían S1, S2 y S3. Logramos escribir en S2 y en S1, pero S3 no está disponible, así que se escribe en el siguiente disponible, S4, y se le responde OK al cliente.
Esto puede generar inconsistencias, y en un momento vamos a ver un ejemplo. Nada de esto es tan matemáticamente estricto como Raft, que es un algoritmo muy sofisticado: Dynamo es deliberadamente menos riguroso, y esa es precisamente su propuesta.
Quórum de lecturas y versiones viejas
Las lecturas también funcionan con un coordinador. No se lee de una sola máquina: el quórum de lectura es dos, igual que el de escritura, así que hay que leer de dos lugares.
Supongamos ahora que los dos primeros nodos de la preference list están caídos. Pueden haber fallado realmente, o puede haberse particionado la red: quizás están perfectamente vivos y somos nosotros los que quedamos en la mitad que no los alcanza. El primero que recibe el read request actúa como coordinador de lectura y les manda el pedido a dos vecinos que sí están. Y aquí está el detalle: esos dos no son los que uno hubiera esperado. El coordinador detectó que los primeros dos no responden y sigue recorriendo el anillo hasta que algún nodo le responda. Por esto la preference list de una clave es más larga que N: tiene nodos de sobra para que siempre haya N réplicas sanas, y toda operación se ejecuta sobre las primeras N saludables de esa lista, no necesariamente las primeras N del anillo.
En el ejemplo, S1 y S2 tenían el dato y están caídos, así que S3 coordina la lectura y les pide el valor a S4 y S5. De sus respuestas sale el quórum: con los relojes vectoriales vemos cuál versión es la más reciente y respondemos esa.
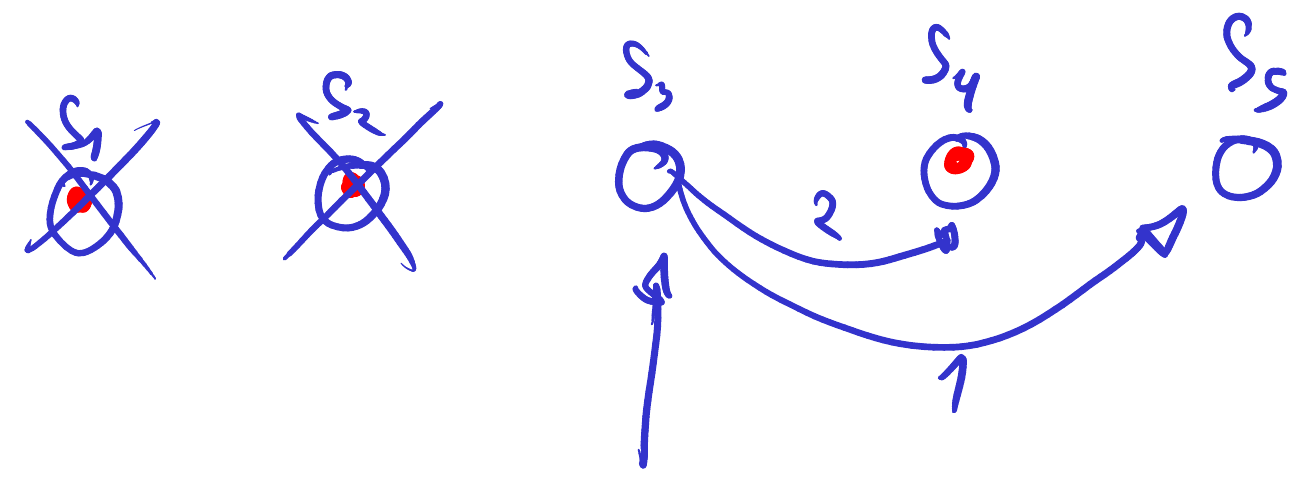
Ahora, si responde primero S5, que no tiene la versión más reciente, le devolvemos al cliente una versión desactualizada. Y eso, en principio, está bien. El contrato con este sistema es exactamente ese: de vez en cuando puede devolver información desactualizada, pero eventualmente se tiene que restaurar.
Por este camino pueden darse situaciones inesperadas. Como los dos nodos que se supone que tienen el dato no responden, el coordinador continúa por el anillo y les pregunta a los dos siguientes. Quizás uno lo tenía desactualizado, y eso es lo que responde. Quizás ni siquiera tienen el dato y responden con lo que tengan. Y quizás el desactualizado era justamente S3, el que coordina. El resultado depende de qué réplicas respondan, y de ahí viene la consistencia eventual.
Consistencia en ausencia de fallas
Lo interesante es que, cuando no hay fallas, esto es casi más fuerte que un Raft en el que no se lee siempre del líder. Ahí uno elegía una réplica, que podía estar desactualizada, y devolvía lo que fuera. En ZooKeeper eso era explícito: se leía de cualquier réplica, aunque estuviera atrasada.
Aquí estamos haciendo algo que nunca habíamos hecho: un quórum de lecturas. Antes leíamos de una sola máquina; ahora tratamos de leer de todas, y cuando responden las que necesitamos, por el solapamiento inferimos que alguna tiene la versión más actualizada. No sabemos de antemano cuál, pero la detectamos con los relojes vectoriales y respondemos esa.
La conclusión es que, cuando no hay fallas graves que afecten grandes porciones de la red, funciona muy bien. Es consistencia eventual, pero bastante buena. Para que aparezcan lecturas inconsistentes sin ninguna falla tiene que haber mucha concurrencia: distintos clientes escribiendo la misma clave a la vez por diferentes servidores, y leyendo al mismo tiempo. Y con fallas, incluso raras, en las que se pierden grandes partes de la red, esto sigue funcionando; inclusive con el split brain que vimos la clase pasada. Lo que queda por entender es cómo se resuelven esas situaciones excepcionales.
Hinted handoff y fallas temporales
Dynamo tiene varios métodos para recuperarse de esas situaciones. No son exactamente parches, sino mecanismos que se le fueron incorporando para que el sistema se vaya arreglando solo con el tiempo. El primero atiende justamente el caso que acabamos de ver: la escritura que no completó el quórum donde correspondía.
En el ejemplo, teníamos que escribir en S1, S2 y S3, y S3 está caído. Escribimos en S1 y S2, y el dato se lo mandamos a S4. Pero a S4 no le mandamos solamente la clave y el valor: en el mismo mensaje le mandamos también S3. El mensaje le indica algo preciso: ese dato no le corresponde a S4, que debe conservarlo disponible por si alguien lo solicita y entregarlo a S3 en cuanto sea posible. Ese dato adjunto, el nombre del destinatario que no pudo recibirlo, es el hint, y el mecanismo se llama hinted handoff.
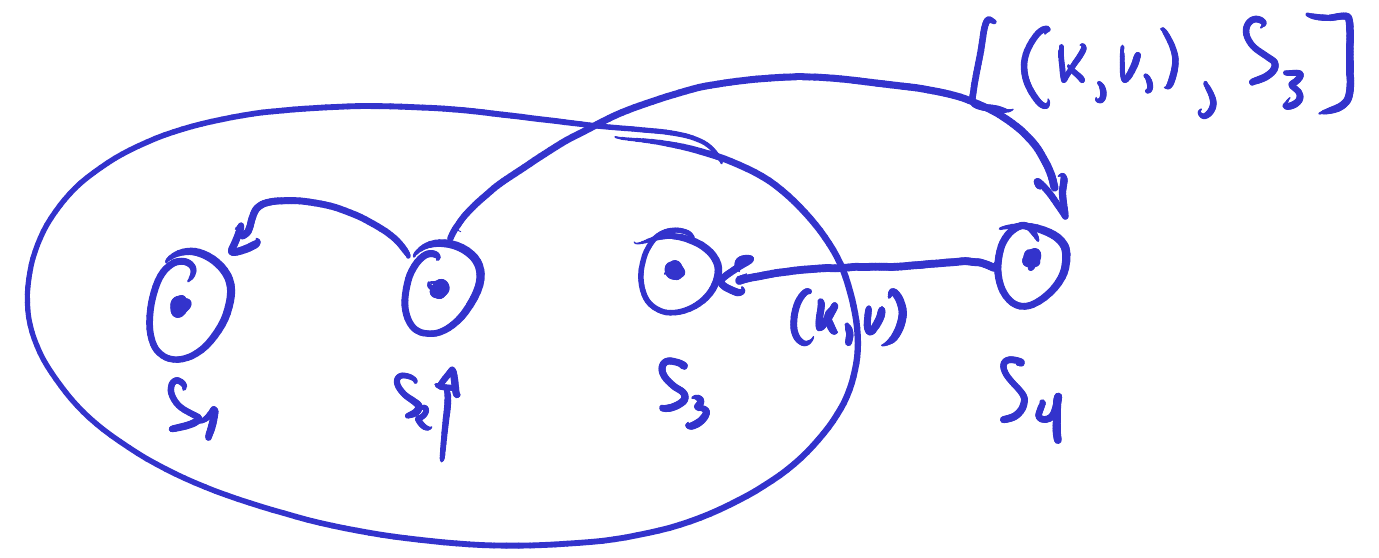
S4 va a monitorear de vez en cuando a S3 para ver si se recupera, o solo para ver si es alcanzable desde S4: quizás S3 nunca estuvo caído, sino que los otros dos no llegaban hasta él, y S4 sí puede. Cuando S3 vuelve a estar disponible, S4 le manda la clave y el valor pendientes. El dato termina en S3, donde correspondía desde el principio; todo se restaura solo.
Nada de esto se parece a los algoritmos sofisticados que vimos antes, como Raft: es un mecanismo pragmático para que los datos, aunque no se hayan escrito donde correspondía, eventualmente se restauren.
La entrega tiene un detalle. Cuando S4 le escribe a S3 se aplican los criterios de siempre para ver si el valor que llega es más actualizado que el que S3 ya tiene. Quizás S3 se recuperó hace tiempo y alguien le escribió un valor todavía más reciente; en ese caso rechaza lo que le manda S4. Si no, lo acepta.
Todo el mecanismo se apoya en una idea sobre cómo fallan estos sistemas. Más que una teoría es una hipótesis, sin definición matemática detrás: la mayoría de las fallas son temporales. El caso típico es un router que empieza a rechazar paquetes pero eventualmente se restaura solo, y el servidor aparece de vuelta. Se cayó unos segundos, o unos minutos, y volvió.
Lo que la hipótesis dice, sobre todo, es lo que la falla no es: no es un servidor que se quemó. Cuando imaginamos fallas en sistemas distribuidos imaginamos casos que no son tan comunes como uno pensaría: que se dañó el disco o la computadora, o que un desastre natural destruyó el data center entero. Esos eventos catastróficos no son tan frecuentes. Mucho más frecuentes son los problemas temporales: que se sature la máquina y no pueda aceptar más requests, que su base de datos esté llena, y entonces los requests den timeout hasta que eso se restaure solo y la máquina vuelva a aceptar mensajes.
De ahí sale la decisión de diseño. Disparar el reemplazo completo de la máquina ante una pequeña latencia no tendría sentido. La apuesta es la contraria: si algo falló, primero asumimos que la máquina va a volver, le mandamos el dato a un compañero, y ese compañero eventualmente se lo devuelve.