1. Introducción histórica: cinco eras de sistemas distribuidos
En esta sección
MapReduce es un nombre que probablemente ya hayamos encontrado antes. En varias materias se enseña a escribir mappers y reducers, y a veces se los corre sobre una sola máquina: el enfoque es el de un modelo de programación. Eso es legítimo y útil, pero deja de lado lo que aquí nos interesa, que es cómo funciona el sistema por dentro.
De todos modos vamos a repasar de manera general el modelo de programación, para que nadie quede desorientado; pero el objetivo está en la maquinaria que hace que ese modelo se pueda ejecutar sobre un conjunto grande de máquinas.
Antes conviene dar un paso más atrás y hacer una cronología general de los sistemas distribuidos, que es lo que explica por qué MapReduce existe y cuándo surgió. Vamos a recorrer cinco eras, y MapReduce va a aparecer en el lugar que le corresponde: como respuesta a una pregunta que alguien se estaba haciendo en ese momento y no antes.
Era 1: fundamentos teóricos (70s–80s)
Todo este campo, cuando todavía no se llamaba sistemas distribuidos, surge de problemas teóricos: no de un producto ni de una necesidad comercial, sino de problemas que encontraron los primeros científicos que trabajaban con redes, a fines de los años 70 y durante los 80.
La figura central de esa era es Leslie Lamport, y lo más fácil es presentarlo por algo más familiar que sus aportes a los sistemas distribuidos: inventó LaTeX, la herramienta con la que los científicos escriben sus papers. También inventó TLA+, un lenguaje para especificar sistemas, sobre el que escribió Specifying Systems, que está disponible gratuitamente en internet; es, en el fondo, un mecanismo para comprobar que un sistema distribuido es funcionalmente correcto. Estuvo cerca de entrar en el programa y quedó fuera porque nos llevaba demasiado lejos.
Lamport era matemático y además sabía de física y de relatividad. De ahí salió una de sus primeras observaciones, que él mismo contó en alguna entrevista: algo que pasa en la relatividad —la imposibilidad de sincronizar relojes— también pasaba en los sistemas distribuidos.
La relatividad especial establece que no hay un orden total invariante de los eventos: dos observadores pueden discrepar sobre cuál de dos eventos ocurrió primero, y lo único que queda es un orden parcial en el que un evento precede a otro si puede afectarlo causalmente. Es esa estructura la que Lamport trasladó a los sistemas distribuidos. Referencia: Leslie Lamport, Time, Clocks, and the Ordering of Events in a Distributed System, CACM, vol. 21, n.º 7, julio de 1978, pp. 558-565.
Dos relojes quieren ponerse en hora y solo pueden comunicarse enviándose mensajes. El primero le envía al segundo la hora que tiene, y cuando ese mensaje llega, el segundo no sabe cuánto tardó en el camino: puede ser que la hora recibida ya sea vieja. Pueden intercambiar mensajes indefinidamente: la sincronización exacta no se va a poder lograr.
La conclusión que sacó de ahí orienta el resto de la materia: si los tiempos absolutos son inalcanzables, no son lo importante. Vamos a ver que muy pocos sistemas distribuidos se apoyan en relojes de tiempo real. Lo que importa mucho más es qué ocurre primero y qué ocurre después.
La pregunta de la era la planteaban, principalmente, matemáticos: no había todavía aplicaciones prácticas que lo impulsaran. Es cómo coordinar distintos procesos cuando hay dos recursos que no se pueden compartir: la memoria y el reloj. Ninguna de las dos está compartida en un sistema distribuido. Eso no lo vamos a resolver de manera definitiva: a lo largo del curso vamos a ver muchas técnicas que lo mitigan.
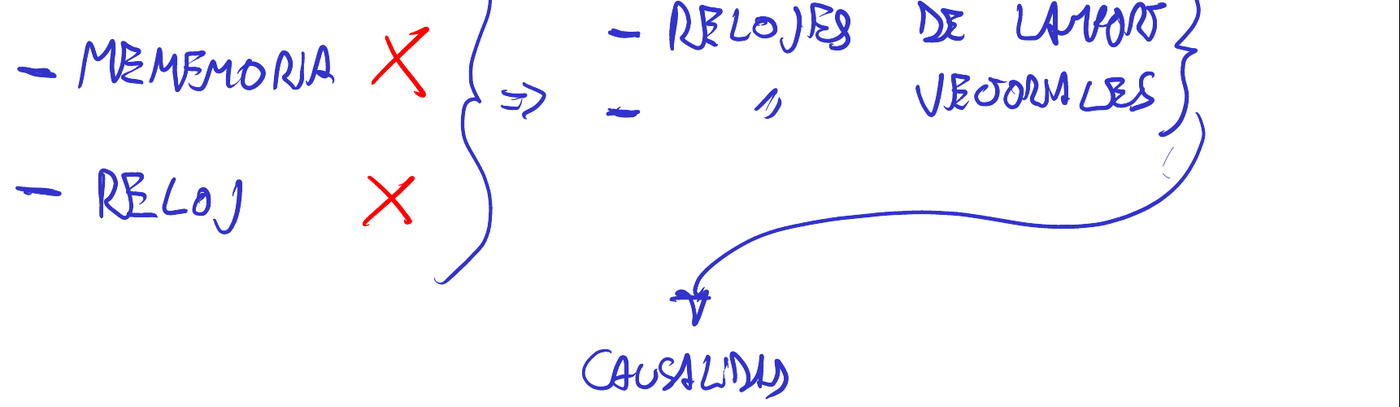
Entre los aportes de esta época —no todas por Lamport— hay tres que conviene mencionar. La primera son los relojes de Lamport, más o menos por la mitad del programa, y con ellos los vectoriales. Aquí hay que evitar una confusión que el nombre invita: no vamos a solucionar el problema de tener un reloj global. “Reloj” refiere a un mecanismo para asegurar que un mensaje ocurrido en un nodo sucedió después que otro ocurrido en un nodo distinto: un orden relativo, no absoluto. Y lo que se resuelve con eso tiene nombre: la causalidad.
Los relojes vectoriales no son de Lamport. Los desarrollaron de forma independiente Colin Fidge —Timestamps in Message-Passing Systems That Preserve the Partial Ordering, 1988— y Friedemann Mattern —Virtual Time and Global States of Distributed Systems, 1989—. La diferencia técnica es la que los motiva: un reloj de Lamport captura una condición necesaria de la causalidad; uno vectorial, la implicación en los dos sentidos.
El segundo aporte —este sí formalizado por Lamport— es la máquina de estados replicada, que vemos en detalle la clase que viene. La idea es simple y va a ser importante cuando lleguemos a los sistemas de storage y a cómo se obtiene ahí tolerancia a fallas. Una forma de tenerla es tener réplicas: en vez de una base de datos, dos bases iguales.
¿Y cómo logramos que sean iguales? Consideremos que una base de datos es una máquina de estados, algo así como un autómata finito: a partir de un evento se sabe a qué otro estado va a ir. Si eso es cierto y le enviamos los eventos en el mismo orden a dos de esas máquinas, siempre nos va a quedar el mismo estado final.
Un ejemplo lo hace más fácil, porque esta propiedad la tienen muchísimos sistemas. Pensemos en nuestra cuenta bancaria: si partimos del saldo de hace un mes y aplicamos todas las transacciones en el mismo orden en que ocurrieron, llegamos exactamente al saldo actual. ¿Por qué funciona? Porque aplicamos las mismas operaciones en el mismo orden, y porque cada operación es determinista. Cuando se acredita un depósito de 200 no se genera un número aleatorio: la suma siempre da el mismo resultado.
Pongámoslo con dos máquinas, A y B, y una secuencia de operaciones a, b, c y d. Si a las dos les aplicamos las mismas operaciones en el mismo orden, el resultado final va a ser el mismo. Ahí, en la palabra “orden”, aparece el concepto de los relojes lógicos.
Y con eso, aparentemente, resolvimos la replicación. Pero en realidad le pasamos el problema al orden: ahora la pregunta es cómo hacemos para que llegue el mismo orden a las dos máquinas.
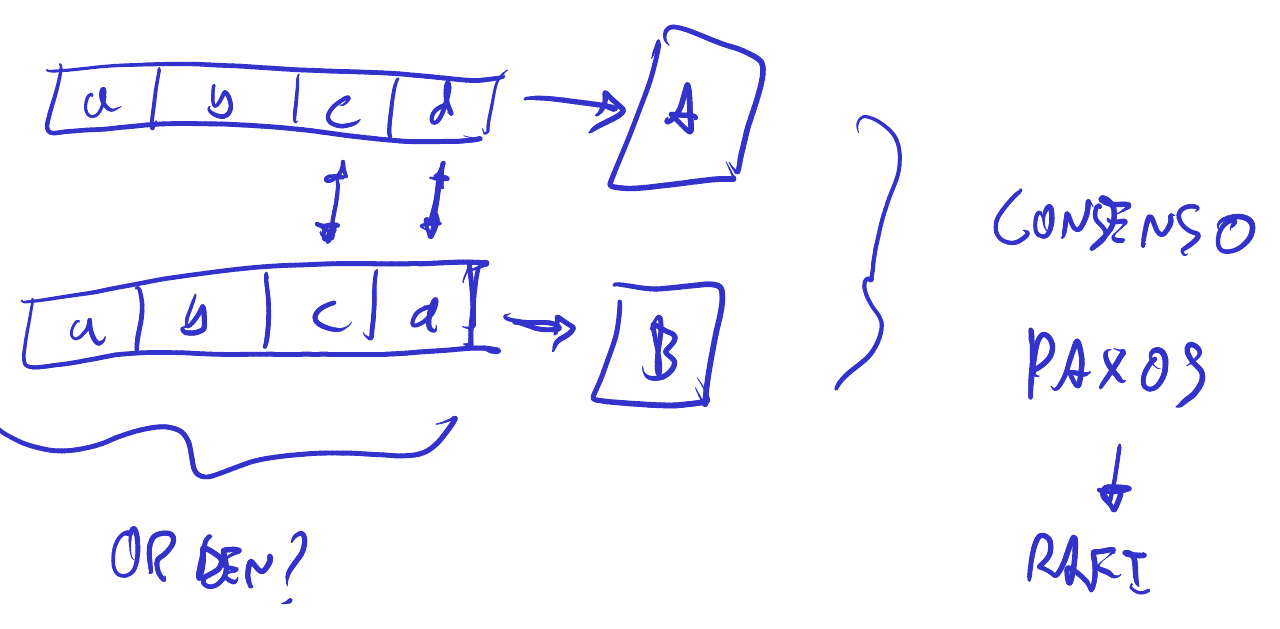
Una respuesta inmediata: que una única máquina defina el orden, con un log de operaciones que les envía a las dos réplicas. Funciona, pero trasladamos el problema de la replicación a esa única máquina: si esa máquina falla, falla todo.
Hace falta algo distinto: un pequeño algoritmo para que las dos máquinas se pongan de acuerdo en cuál es la siguiente operación. Ese es el problema de consenso, el tercer aporte de esta era.
Bastante más tarde, hacia fines de los 80, Lamport propuso un algoritmo que resuelve el consenso: Paxos. Es notablemente difícil de entender, y tiene toda una historia alrededor de eso. Y sin embargo el problema que resuelve es central.
La fecha conviene aclararla, porque la referencia que se cita habitualmente es de casi diez años después. Lamport publicó el algoritmo como reporte técnico del DEC Systems Research Center —The Part-Time Parliament, SRC Research Report 49— y lo envió a Transactions on Computer Systems en 1989. El paper lo presentaba como una alegoría sobre los legisladores de la antigua isla de Paxos, y las reseñas fueron hostiles —una, según Lamport, era una diatriba contra el uso del humor en un paper científico—. Lo volvió a enviar en 1995 y salió recién en 1998, en ACM TOCS, vol. 16, n.º 2, pp. 133-169.
Quien trabaja el tiempo suficiente con sistemas distribuidos termina encontrando que, en algún lugar, hay que resolver que varias máquinas se pongan de acuerdo en algún valor.
Podríamos entonces implementar Paxos, pero tiene dos problemas. El primero es que el consenso se acuerda de a un valor por vez: habría que ejecutar un Paxos para la primera operación, otro para la segunda, y así sucesivamente; hay formas de resolverlo, pero no resultan prácticas. El segundo es que es extremadamente difícil de implementar: el caso sin fallas es sencillo, y los complicados aparecen cuando algo falla en el momento menos conveniente.
Por eso lo que vamos a estudiar en profundidad es otro algoritmo más moderno: Raft, de alrededor de 2014. Se inventó justamente para que el consenso sea más fácil de entender que en Paxos, y aun así va a ser el paper más difícil de la materia: requiere alrededor de una semana de lectura, un poco cada día. Como todos estos algoritmos, Raft está compuesto por muchas piezas independientes que interactúan para que el conjunto funcione. La forma de leerlo se descubre sola: se piensa un caso de borde, se vuelve al paper y ahí aparece la respuesta, que explica por qué en esa situación el algoritmo no falla.
Toda esta primera era es la parte más matemática de la materia y, aunque exija esfuerzo, resulta estimulante. Una advertencia: las eras no son independientes ni tienen bordes limpios, se solapan. Paxos es de fines de los 80 y Raft de 2014, así que las respuestas a las preguntas de esta era siguieron llegando cuando las otras ya habían pasado.
Era 2: intentos de transparencia (80s–90s)
Ya en los 80 se pasó a cuestiones más prácticas, a sistemas que alguien efectivamente quiso construir y poner en funcionamiento. A esa etapa vamos a llamarla la era de los intentos de transparencia, y va de los 80 a los 90.
La estrategia de la época se resume en una línea: tenemos una red, vamos a hacer un sistema distribuido, y hacer un sistema distribuido implica esconder la red.
El primer ejemplo que vimos, en la clase anterior, es el network file system: cuando funcionaba bien, funcionaba bien; cuando no, resultaba una fuente considerable de problemas.
El otro mecanismo de esta época, con el que terminamos la clase anterior, son las remote procedure calls, RPC. Lo que se quería inicialmente era que la red fuera completamente transparente: que quien llama piense que está haciendo una llamada local. Hoy la situación es otra, y es mejor: nos beneficiamos de que llamar a un RPC sea fácil, pero quien llama sabe perfectamente que eso es una API que va a otro sistema. Por eso RPC es lo que mejor sobrevivió de esa época: se quedó con la comodidad y abandonó el engaño.
Hay otra línea de trabajo interesante que hoy es una disciplina prácticamente extinta: los sistemas operativos distribuidos. Hubo varios ejemplos famosos en su momento.
Uno era Amoeba, del equipo de Tanenbaum: el del libro de sistemas operativos, autor de MINIX y protagonista de un célebre debate con Linus Torvalds. Ese equipo trataba de hacer un sistema operativo que pareciera estar todo en la máquina de uno pero estuviera repartido en muchas partes. Se abandonó por los mismos problemas del NFS: cuando fallaba, lo hacía de maneras difíciles de diagnosticar.
Hay, de todos modos, un punto curioso. Hoy existen sistemas que se parecen a un sistema operativo distribuido y que a la vez no tienen nada que ver: se podría pensar que un orquestador de data center —Kubernetes— cumple algunas funciones de sistema operativo, y a la vez la objeción es inmediata. Las dos lecturas se pueden defender.
Otro conocido de la época es Plan 9, que sí quería ser un sistema operativo distribuido y algunas de cuyas ideas quedaron. El nombre completo era Plan 9 from Bell Labs, un guiño a Plan 9 from Outer Space, la película de Ed Wood. Todavía puede instalarse y explorarse, aunque hoy tiene muy poca actividad; de todos modos, no quedó en el olvido.
Vale decir cuáles son esas ideas, porque una la usamos todos los días y otra la vamos a usar en este trabajo práctico. UTF-8 salió de ahí: Ken Thompson y Rob Pike lo diseñaron en 1992 mientras convertían Plan 9 para que soportara Unicode, lo implementaron en un fin de semana y llegaron con eso a la reunión en la que X/Open lo eligió como formato de bytes de Unicode; hoy es la codificación dominante de la web. 9P, el protocolo de Plan 9 para acceder a sistemas de archivos jerárquicos, está implementado en Linux y en WSL. La llamada
rfork, base de los threads livianos, se adoptó en los derivados de BSD y reapareció en Linux comoclone. Y Go, el lenguaje de esta materia, lo diseñaron Griesemer, Pike y Thompson: los tres venían de Plan 9, y buena parte de la simplicidad del lenguaje viene de esa experiencia.
Y toda esta serie de intentos de esconder la red quedó refutada por un paper fundacional del que hablamos la clase anterior: A Note on Distributed Computing, de Waldo y otros, 1994. El argumento es directo: no es buena idea ignorar que hay una red abajo, porque después aparecen todos los problemas.
A Note on Distributed Computing, de Jim Waldo, Geoff Wyant, Ann Wollrath y Sam Kendall, Sun Microsystems Laboratories, informe técnico SMLI TR-94-29, noviembre de 1994. Las cuatro características de la red que el paper enumera como imposibles de esconder —latencia, acceso a memoria, concurrencia y fallas parciales— son las que vimos en detalle en la clase anterior.
Era 3: middleware (90s)
Vamos a los 90, y los problemas ya son de otro tipo. Es la época de la computación corporativa: muchas empresas cuyo funcionamiento se apoyaba fuertemente en tener sistemas, y del otro lado otras —Microsoft, IBM— que se los vendían. El problema principal no era el volumen de datos: big data no aparece aquí, el término ni existía. Lo que había que resolver era cómo se comunica de manera distribuida un sistema con otro. La era del middleware es una bisagra, porque es donde se toma una decisión conceptual que no se deshizo nunca más.
La decisión es esta: se descarta la idea de un sistema donde la red y la comunicación estén completamente escondidas. En lugar de esconderlas, se las reconoce y se les da un lugar propio en el dibujo. Arriba la aplicación, abajo la red, y en el medio una capa que se encarga de esas comunicaciones: el middleware. Eso es lo que la palabra significaba, literalmente: el software que estaba en el medio entre nuestra aplicación y la red.
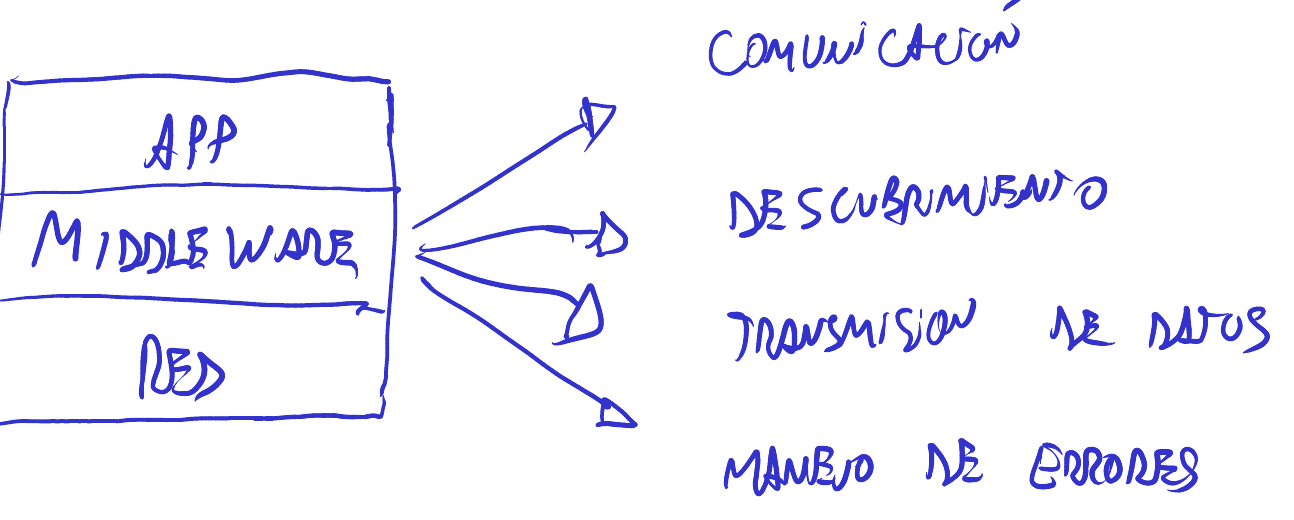
¿Qué resolvía el middleware? La comunicación, por empezar. Después el discovery: nuestro sistema se quiere conectar con otro y hay que averiguar cuál es y cómo se llama, y eso la aplicación no lo quiere resolver. Después la transmisión de datos. Y por último el manejo de errores, que donde la comunicación pasa por una red es una responsabilidad enorme y no un detalle.
Había varios tipos de middleware, y algunos clásicos que se enseñaron en la universidad hasta volverse anacrónicos. Uno era un framework grande para la comunicación entre aplicaciones, una especie de RPC complicado —la simplificación es considerable y un especialista objetaría—: CORBA, Common Object Request Broker Architecture, un estándar de uno de esos comités. Lo que proponía eran objetos distribuidos: llamar a métodos remotos. Hoy es difícil encontrarlo implementado; seguramente haya algún banco que lo siga usando, pero no es algo que aparezca en la práctica actual.
El comité es el Object Management Group (OMG), fundado en 1989 para estandarizar la interoperabilidad entre sistemas de objetos. CORBA 1.0 salió en octubre de 1991 con el modelo de objetos, el IDL —el lenguaje de definición de interfaces— y las APIs para invocación dinámica, con un único mapeo de lenguaje, a C. La primera versión ampliamente difundida fue CORBA 1.1, de febrero de 1992. Fuente: el propio OMG.
¿Y Java RMI, dónde entra? La pregunta es natural, porque también consiste en llamar a métodos remotos. La respuesta es que está mucho más cerca de RPC que de CORBA. CORBA era un estándar grande y complicado: había que instalar servidores en el medio, toda una infraestructura. RMI es la forma en que Java resuelve el RPC, que es el concepto más general. Y ese concepto es bastante amplio: incluso REST, en algunos casos, se podría considerar una especie de RPC, porque en el fondo se trata de llamar a funciones remotas. Vale más quedarse con RPC como concepto que con cualquiera de sus implementaciones.
El otro clásico de la era no desapareció: mutó y volvió. Se llama MOM, message oriented middleware. No es tan central hoy como en los 90, pero este tipo de sistemas se sigue usando, y eso es lo que hay que retener.
La idea es la siguiente. RPC es sincrónico: se llama al servidor remoto y quien llamó queda bloqueado hasta recibir la respuesta; es la versión bloqueante de una llamada, pero en un sistema distribuido. La definición correcta de sincrónico es otra —que hay un tiempo acotado para responder—, aunque en la práctica uno ve eso: se llama, se bloquea, responde. La alternativa es la comunicación asincrónica: se envía un mensaje sin esperar la respuesta, y el destinatario lo recibe más adelante.
“sincrónico” se usa en dos sentidos fáciles de confundir. Uno es el coloquial de programación: la llamada bloquea. El otro es el de la teoría de sistemas distribuidos: un sistema sincrónico es aquel en el que hay una cota superior conocida para el retardo de los mensajes y para la velocidad de procesamiento de los nodos. Un sistema asincrónico no tiene ninguna cota: un mensaje puede tardar arbitrariamente, y lo único garantizado es que eventualmente llega. No es una sutileza terminológica: casi todos los resultados de imposibilidad de la materia dependen de en cuál de los dos modelos estamos.
Muchas veces la semántica sincrónica es más fácil de razonar, porque generalmente enviamos un pedido y esperamos una respuesta. Pero otras veces no necesitamos esperarla: importa solo enviar el mensaje y que alguien en el medio garantice que eventualmente se le va a entregar a quien corresponde. La definición imprecisa de esto, que es a la vez la más citada, es “envío un mensaje y me olvido”.
Los message oriented middleware tenían varias características, y la más importante era que eran persistentes. Si queríamos enviarle un mensaje a un servidor apagado, el middleware lo guardaba y seguía intentando entregarlo hasta que funcionaba. El mensaje sobrevivía a que el destinatario no estuviera, y quien lo envió no se tenía que ocupar de reintentar nada. También resolvían el discovery, porque uno enviaba el mensaje al canal sin saber quién lo iba a recibir.
Todo esto lo vamos a estudiar más adelante en un contexto más actual: el de las colas de mensajes y los sistemas de streaming. Ya casi no se dice MOM, pero es el mismo tipo de sistemas, y la conclusión que importa es doble: se sigue usando, y además es importante.
¿Puede gRPC funcionar de forma asincrónica sin romper con el concepto? Solo parcialmente. Tiene un modo de streams: en vez de una llamada y una respuesta, se pueden enviar muchos requests y recibir muchas responses. Eso mitiga el bloqueo a la espera de una respuesta. Pero el límite es el mismo problema: si el destinatario está caído, no nos podemos conectar y no le podemos enviar nada.
Ejemplos actuales hay varios: SQS, el servicio de Amazon; RabbitMQ; Kafka, un poco diferente pero de la misma categoría; y Pub/Sub, el de Google. Todos se siguen usando. gRPC tiene algo de esta semántica asincrónica, pero nosotros vamos a usar más la otra, la de llamar a una función y recibir su respuesta, porque los streams no están en RPC en general: son algo particular de gRPC.
Era 4: web (2000s)
Llegamos a la era que más nos importa, la era web, alrededor del año 2000. Lo que aparece aquí es la banda ancha, y con ella la posibilidad de que muchos usuarios generen grandes volúmenes de información muy rápido. Aparece internet, y aparecen las bases de datos gigantescas.
Con esos datos aparecen las empresas que trabajan con ellos, y lo que más vamos a ver en la materia son sistemas de esta época. Vale nombrar los papers, porque ubicarlos en el tiempo explica por qué existen: Google File System salió en 2003 y MapReduce en 2004, los dos de Google, igual que BigTable, de 2006, que no cubrimos y queda como lectura. Y Dynamo, de 2007, de Amazon, que sí vamos a estudiar.
Todas estas empresas fueron las primeras que se encontraron con el problema. Hoy muchos están en buena medida resueltos, y precisamente por eso nos interesa cómo hicieron la primera vez. Les tocó porque fueron las primeras que tuvieron que manejar cantidades gigantescas de datos, y las herramientas de entonces no soportaban semejante volumen: los sistemas distribuidos de ese momento estaban enfocados en la comunicación entre sistemas distintos, en el mensaje sincrónico contra el asincrónico, en todos los problemas que acabamos de recorrer. No estaban pensados para escalar.
Y esta época sigue siendo la actual: lo que resuelven hoy los sistemas distribuidos son los problemas de escala: grandes volúmenes de datos y cómo se los administra.
Era 5: cloud computing (2006–hoy)
De ahí, casi sin corte, esto evoluciona al cloud computing. La idea es simple: todas esas técnicas que las empresas desarrollaron para sus propios problemas, empezar a venderlas como servicio, igual que la electricidad o el gas.
El ejemplo concreto es el storage: hoy uno puede alquilar capacidad en la web en lugar de comprar el hardware. Estas dos últimas eras, la web y el cloud, son el recorte que estudia la materia.
De las anteriores vamos a ver algo, aunque no todo. De CORBA nada. De MOM sí: en particular Kafka, los sistemas de streaming y algo de SQS; quizás no tanto cómo funcionan por dentro, pero sí cuál es la idea de cada uno.
Queda lo más interesante de la cronología, que es lo que la cierra. Cuando los equipos de estas empresas abordaron los problemas de escala, tuvieron que recurrir a la teoría que habían desarrollado los investigadores de la primera era. Gran parte de esa teoría había quedado latente y se retomó cuando hubo que resolver efectivamente la replicación de bases enormes, o el consenso. Un indicio es la fecha de Raft: recién 2014, unos quince años hasta que volvió a surgir un algoritmo de consenso útil y práctico, empujado por esta necesidad.
Falta un matiz que explica por qué las fechas de los papers engañan: estas empresas internamente habían llegado antes a soluciones equivalentes, pero no las publicaron. Amazon tenía una versión interna de algo muy parecido a Raft.
De los sistemas internos de Amazon anteriores a 2014 no hay documentación pública, pero la afirmación está respaldada por dos casos publicados. Google usaba Paxos en Chubby, su servicio de locks, y contó cómo fue implementarlo en Paxos Made Live (Chandra, Griesemer y Redstone, 2007); y ZAB, el protocolo de atomic broadcast de ZooKeeper, es de 2008: los dos son anteriores a Raft y estaban en producción. Hay además un antecedente que corrige la idea del vacío de quince años: Viewstamped Replication, de la tesis de Brian Oki dirigida por Barbara Liskov (MIT, 1988), es un protocolo basado en líder anterior a Paxos y estructuralmente más parecido a Raft — el propio paper de Raft lo reconoce como su pariente más cercano. Lo que faltó durante quince años no fue un algoritmo de consenso que funcionara, sino uno pensado desde el principio para poder entenderse.