1. Objetivos y arquitectura de Spanner
Con Spanner terminamos la parte de sistemas de storage, y no hay mejor sistema para cerrarla, porque combina prácticamente todo lo que fuimos viendo. En Google construyeron un sistema extraordinariamente complicado: usa muchas técnicas apiladas unas sobre otras, y todas tienen que salir bien al mismo tiempo. Es una base de datos distribuida, y lo que la vuelve interesante es que soporta transacciones casi como si fuera SQL común. Quien trabaje con Google Cloud probablemente lo tenga disponible como servicio, así que no es un sistema de laboratorio: se puede contratar y usar.
El paper de Spanner es de los más difíciles de la materia, y el sistema probablemente el más complejo del curso. Vamos a ver una versión resumida, pasando por alto varios detalles que el paper explica, simplemente porque el sistema tiene de todo. Dentro de ese todo hay dos temas que nos interesan particularmente, y uno de ellos —multiversion concurrency control— va a ser lo más interesante de hoy. A eso llegamos en la segunda mitad de la clase.
El objetivo es una base de datos distribuida que soporte transacciones como las que ya conocemos. Uno escribe un begin, un read X, un read Y, después X = X + Y, le hace commit, y la transacción se confirma.
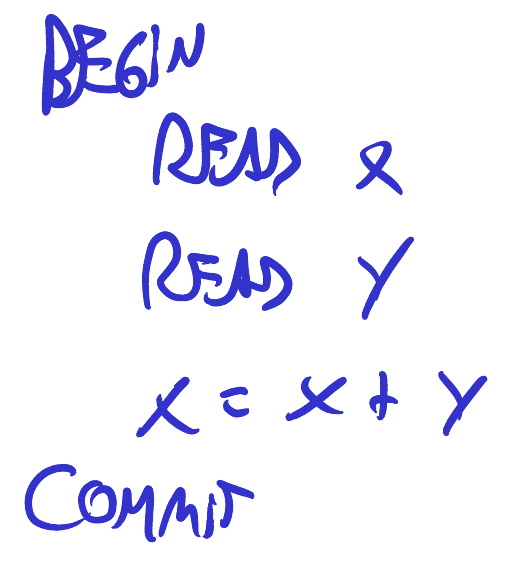
Visto así no parece algo extraordinario, porque es lo que hacemos todos los días contra cualquier base relacional. Pero aunque para nosotros esté resuelto, internamente, en una base como Postgres, lograrlo es muy complejo: alguien ya lo resolvió, con muchísimo trabajo. Lo que hicieron en Google fue esforzarse mucho para lograr eso mismo en un sistema distribuido. Es muy ambicioso, y por eso el sistema resulta bastante raro.
Para apreciar cuán ambicioso es, alcanza con compararlo con lo que vimos antes. Los otros sistemas ni siquiera lo intentaban, y surge la pregunta de por qué nadie más lo encaró de frente. En el caso de DynamoDB, la respuesta es que nunca intentó ofrecer algo tan genérico: agrupaba writes y los escribía todos juntos, y con eso resolvía una parte del problema. La posibilidad de leer, escribir, calcular con lo leído y encerrarlo todo entre un begin y un commit no existía. La primera versión de Spanner tampoco tenía SQL; se lo agregaron después, y hoy es básicamente un motor de SQL distribuido, casi completamente compatible con el SQL que se aprende en las materias de bases de datos.
El paper original de Spanner (Corbett et al., OSDI 2012) describe un modelo de datos semirelacional con un lenguaje de consulta propio, no SQL. La migración al dialecto SQL común de Google está documentada en un segundo paper, “Spanner: Becoming a SQL System” (Bacon et al., SIGMOD 2017).
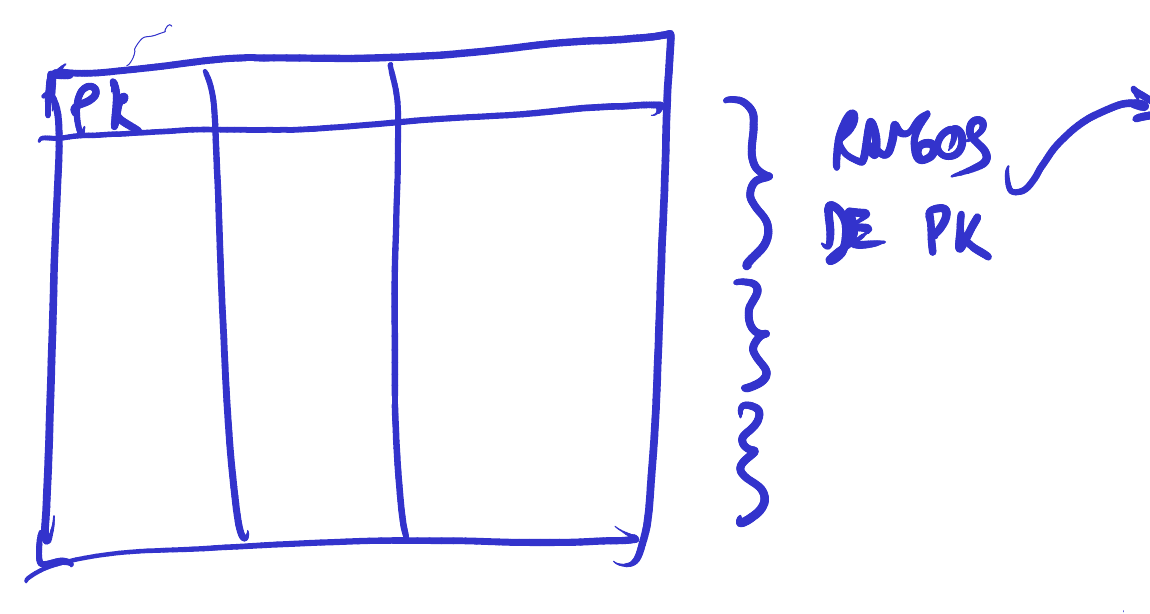
El storage es lo básico y no es lo que más nos interesa, porque a esta altura lo vimos muchas veces. Spanner tiene tablas adentro, y son las que ya conocemos: tablas de SQL. Hay un detalle del estándar SQL poco conocido, que uno descubre solo cuando lo empieza a usar en serio: no es obligatorio ponerle primary key a las tablas. En Spanner sí lo es, y esa primary key obligatoria va a ser importante más adelante.
Lo que hace Spanner con esas tablas es lo mismo que venimos viendo en todo el curso: shardear, tomar la tabla y partirla en pedazos. Y se parte por rangos de primary key. Esto tampoco es lo principal —lo vimos cinco veces ya—, pero conviene retener que no usa hashing, sino los rangos comunes de la primary key. Es una decisión que tomaron ellos, y no es evidente por qué.
Lo interesante es qué hacen con esos shards: los replican en distintos data centers. Imaginemos tres, DC1, DC2 y DC3, cada uno con los mismos shards adentro. Un rango cualquiera de la tabla existe entonces tres veces, una en cada data center, y a esas tres copias del mismo rango las agrupamos: eso es un grupo de replicación.
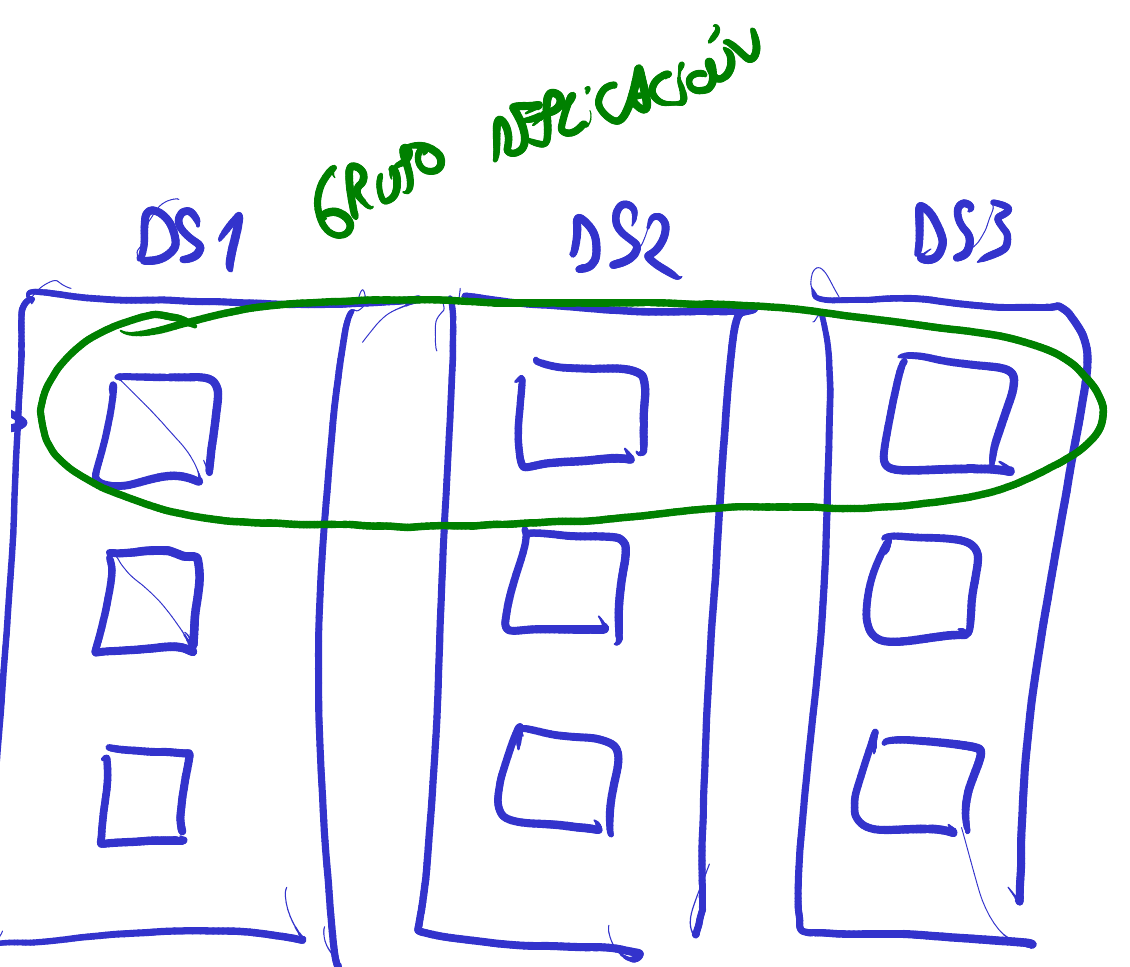
A esta altura, y sobre todo con el trabajo práctico en marcha, esto debería resultarnos muy familiar: es prácticamente la misma estrategia de DynamoDB. Hay una diferencia: para mantener esos shards replicados, Spanner no usa Raft sino Paxos, el otro algoritmo de consenso, el que no vimos en la materia y que también usa DynamoDB. Los detalles finos de ese Paxos —en realidad multipaxos— no nos van a interesar.
Podemos imaginar que es símil Raft y asumirlo por el resto de la clase; vamos a entender igual todo lo que sigue.
Toda esta parte es muy similar a DynamoDB. Lo completamente diferente son las transacciones, y eso es lo que nos interesa: si no fuera por ellas, la clase terminaría aquí. Todo el resto es cómo resolvieron las transacciones ACID, que tienen prácticamente las mismas propiedades que en Postgres o MySQL, con la salvedad de que las de escritura quizás sean un poco más lentas.
La idea clave es que hay dos tipos de transacciones, y el paper las diferencia bien. Por un lado están las read-write, las que leen y escriben. Las implementan con algo que ya vimos: two-phase commit, el de la clase pasada, junto con locking pesimista, que es lo mismo que decir two-phase locking. Ninguna de las dos piezas es nueva; lo nuevo es sobre qué las apoyan: los grupos de replicación que acabamos de dibujar, que en el vocabulario de Spanner son los Paxos groups —de nuevo, símil Raft.
La parte más interesante es cómo resolvieron las read-only transactions, las que solamente leen. Esas tienen varias rarezas, y la clase de hoy es sobre eso. Logran snapshot isolation, que es leer snapshots, como vimos al final de la clase de DynamoDB, pero sin logs: usan otra técnica, MVCC, multiversion concurrency control.
Aquí hace falta una digresión, porque es un tema de bases de datos y no de sistemas distribuidos. A muchos no les mencionan MVCC cuando cursan bases de datos, y no está claro que hoy se enseñe en todas las cátedras, pese a que MySQL y Postgres lo usan. Es muy importante, y no es raro aprenderlo después, ya trabajando, mirando cómo funciona el motor por dentro. Esta clase es también una buena excusa para verlo.
Lo que MVCC nos permite lograr es snapshot isolation. Conviene ser precisos: snapshot isolation no es la técnica, es el resultado. Repasemos la idea: entre cada transacción de lectura y escritura, la base de datos va pasando por distintos snapshots, y queremos leer de un snapshot solo, no una mezcla de dos. La read-only transaction se llama transacción justamente por eso: lee un snapshot entero, todo a la vez.
Y hay una rareza más, la más llamativa del sistema, aunque casi no se haya aplicado en otros lugares: Spanner usa TrueTime. Es un invento de Google para sincronizar usando relojes atómicos, y el paper se hizo famoso justamente por eso. Vamos a llegar ahí. Lo fundamental, sin embargo, no es tanto que los relojes sean atómicos, sino la forma en que el sistema maneja el tiempo.
Queda una aclaración, fácil de pasar por alto: ¿cómo se distingue una read-write de una read-only? Lo declara el usuario explícitamente al iniciar la transacción. El sistema no lo infiere: si iniciamos una read-write y adentro solo hacemos lecturas, no termina siendo read-only. Son dos categorías distintas, con mecanismos completamente diferentes, como vamos a ver.
Todo lo que sigue, en el fondo, podría ser una clase de bases de datos: tomaron las técnicas comunes de bases de datos y las aplicaron distribuido, usando two-phase commit.