4. Raft: origen y funcionamiento
En esta sección
Paxos, Viewstamped Replication y comprensibilidad
La cronología del problema dice bastante sobre lo difícil que es, así que lo que sigue es un desvío histórico.
Hace falta una distinción previa. Un algoritmo de consenso a secas es muy fácil, y es probable que ya lo hayamos visto en programación concurrente: ponerse de acuerdo entre varios participantes sobre un valor no presenta mayor dificultad. Lo que buscamos es otra cosa: un algoritmo de consenso que tolere particiones de red y una cantidad dada de fallos. Ese problema no se resolvió al principio de la computación.
Hubo dos intentos originales, independientes y casi simultáneos. Uno probablemente ya lo hayamos escuchado nombrar: Paxos, resuelto en 1989. Puede parecer una eternidad, pero hay que ponerlo en perspectiva: las computadoras existen desde los años cincuenta, y los primeros algoritmos capaces de resolver el consenso no aparecieron hasta fines de los ochenta. Es muy reciente. Y a Paxos lo resolvió Lamport, que ya apareció en la materia y sigue en actividad, otro indicio de lo joven que es el área.
Casi simultáneamente apareció el otro intento, que tampoco vamos a tratar: Viewstamped Replication, de 1988, que resuelve básicamente el mismo problema. Sus autores son Oki y Liskov, que debería sonarnos de otra materia y que hizo otros aportes importantes.
Las fechas conviene tomarlas con cuidado. Viewstamped Replication se publicó en PODC en 1988. Paxos circuló como technical report en 1989 y se publicó en ACM TOCS solo en 1998, de modo que Viewstamped Replication precede a Paxos por las dos medidas, aunque Paxos haya quedado como la referencia histórica del problema.
Después pasó mucho tiempo, con muchas empresas resolviéndolo de distintas maneras, varias implementando Paxos. Paxos tiene fama de ser muy difícil de implementar; en realidad es muy difícil de entender, que no es lo mismo. La idea no es tan difícil: leyendo el paper uno se la encuentra. Pero Lamport es matemático y el paper es muy matemático, y si uno se pone a implementarlo va a encontrar muchos detalles que el paper no resuelve. Y esas partes, a diferencia de las de Lamport, no están demostradas matemáticamente. Paxos sí: está demostrado que no puede haber fallas si se cumplen ciertas condiciones.
Paxos es además muy abstracto, y divide los nodos en tres roles: los que proponen un valor, los que lo aceptan y los que aprenden el valor definido. Es complicado, con mensajes de todos con todos, para definir un valor únicamente. Ahí está la fricción con la máquina de estados replicada, porque no queremos definir un valor sino una secuencia: cuál es la siguiente operación que las tres máquinas van a aplicar. En Paxos habría que construir un algoritmo aparte para eso, y cada valor aceptado tendría que ser todo un Paxos entero. Hubo variaciones —las que funcionaron durante mucho tiempo— que trataban de evitar todos los pasos: se hacía algo una vez y ya quedaba un líder que después elegía las distintas cosas. Pero eran más complicadas.
El tercero de la lista es Raft, que también fue una tesis de doctorado. El autor es Ongaro, y su director fue Ousterhout, que es famoso y tiene muchos libros, entre ellos A Philosophy of Software Design, recomendable aunque no trate temas de la materia. Ongaro se hizo famoso por este protocolo, cuyo objetivo declarado es ser más fácil de aprender: como parte del doctorado hizo un estudio de corte psicológico en el que presentó Paxos y Raft a distintas personas y encontró que aprendían Raft con más facilidad. Esa conclusión fue discutida; Lamport, por ejemplo, la cuestiona.
Lamport lo dice en la entrevista Thinking Clearly, Paxos vs Raft, Working With Dijkstra, disponible en
https://www.youtube.com/watch?v=U719vQz-WFs&t=2817s.
La teoría detrás de esa facilidad —y esto ya lo dice el paper— es que Raft tiene dos fases bien definidas: en una se elige el líder, y la otra es toda la que se usa para aceptar los pedidos.
El plan, entonces: primero el algoritmo en general en el caso feliz, después cómo se elige el líder, y por último qué ocurre cuando algo falla. Eso último es lo que más nos interesa a quienes trabajamos en sistemas distribuidos y es principalmente el tema de la clase que viene.
Arquitectura: aplicación, Raft y log
La estructura básica de Raft es la que ya anticipamos hace varias clases, y conviene leerla sabiendo que es una versión simplificada.
Raft está pensado para ser una biblioteca que uno pone como capa inferior. Hay dos capas: abajo Raft, arriba la aplicación. Esa aplicación puede ser de cualquier naturaleza; típicamente, variaciones de una base de datos. Para fijar ideas, una tabla pequeña de dos columnas: una base key-value.
Zookeeper sirve de contraste: si bien no usa Raft sino otro protocolo muy parecido pero distinto, su estructura es la de un file system, completamente diferente de un key-value. Y sin embargo también es un sistema de storage.
La condición sobre ese sistema de storage es que cumpla las de la replicated state machine: tiene que ser determinista. No hay datos random; el orden de las operaciones define el estado final. Si dos de esas tablas parten del mismo estado y reciben las mismas operaciones en el mismo orden, terminan idénticas. Es lo mismo que vimos en la clase 4 con el log.
Lo que Raft implementa internamente es una sola estructura: un log. Y sobre ese log vamos a hablar mucho tiempo, porque es precisamente lo que Raft resuelve: hacer que esté consistente en todas las máquinas, que van a ser por lo menos tres.
El dibujo se repite tres veces, una por máquina. Cada una tiene arriba la tabla —la misma en las tres— y abajo un log. Y una de las tres va a ser el líder, elegido dinámicamente. Para el ejemplo, digamos que es el del medio.
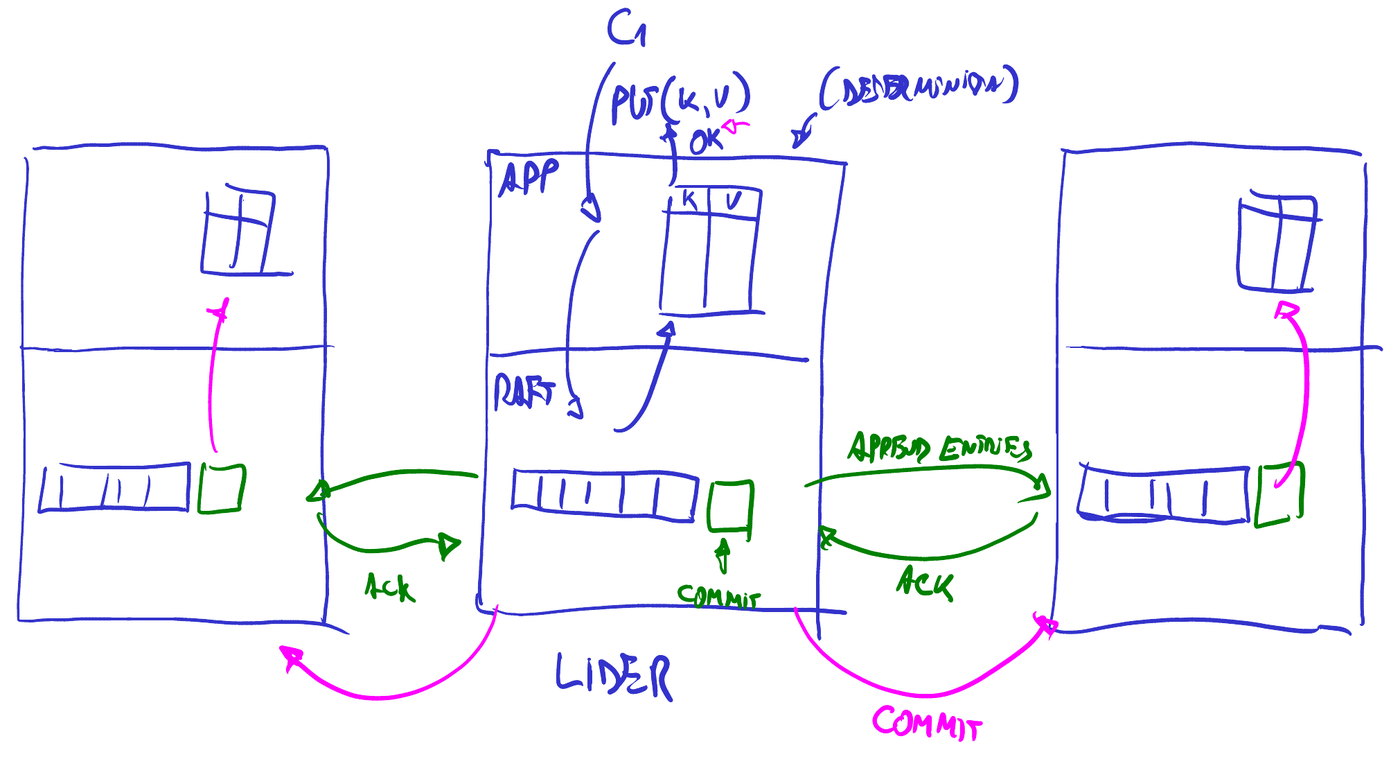
Los clientes, cuando quieran escribir en ese key-value, le van a enviar el mensaje con la operación: un put con la clave y el valor. Eso todavía no es Raft.
Lo esencial de todo el asunto es que la aplicación no va a aplicar esa operación directamente al key-value. Se la va a pasar a la capa de abajo, a Raft.
Para Raft el comando es algo opaco. No le interesa de qué se trata, porque Raft no entiende de key-values: tiene que poder funcionar con cualquier aplicación. Lo interpreta como un array de bytes que coloca en el log. Lo agrega a su propio log, y aquí viene la clave: se lo envía a los Rafts compañeros del otro lado. Esa operación se llama AppendEntries, y así se llama también en el paper. El nombre conviene retenerlo, y también por qué importa: Raft tiene dos operaciones solamente. Una es esta, y la otra es la que sirve para elegir al líder. Con esas dos se resuelve todo el protocolo.
Recapitulemos. El cliente le envió la operación a la aplicación, la aplicación llamó a la biblioteca de Raft, y el cliente todavía no obtuvo respuesta: está esperando. Raft les envía las entries a todos los compañeros.
Hasta aquí la mayoría no había aparecido: el líder agregó la entrada a su log y la repartió. Pero Raft va a esperar a que una mayoría le responda. Supongamos que uno responde que está todo bien; antes de responder tiene que guardar la entrada en su log. Y ahí ya hay una mayoría. ¿Por qué, si respondió solamente uno? Porque hay que contar también al líder. Tenemos la entry en dos lugares diferentes, y eso ya alcanza para que Raft le indique a la capa superior que esta entrada ya está fija y que la aplique: “no sé qué se quería hacer con estos bytes; se los devuelvo, ya están seguros”. La aplicación la aplica y solo entonces le responde OK al cliente.
Le responde OK por dos cosas. Una, porque ya está guardado al nivel de la aplicación. La otra, porque la log entry ya está en una mayoría de máquinas, y eso nos garantiza que de una forma u otra se va a poder recuperar.
Hay detalles importantes que conviene notar. Se aplicó solamente en la máquina del medio, no en las de los costados, y eso no es un inconveniente: el cliente ya recibe OK porque, si bien no está aplicado en las otras dos aplicaciones, sí está en sus logs. Hay dos logs donde está ese comando, así que Raft eventualmente va a poder reejecutarlos —parecido a lo que hace una base de datos— y aplicar en los lugares que faltaban si algo falla. El tercero probablemente también responda, pero a esa altura su respuesta es anecdótica.
Una vez que Raft tuvo una mayoría, esa entrada se considera comiteada. No es el commit de una base de datos relacional: es simplemente el concepto de una entrada para la cual el líder recibió una mayoría de respuestas, y estar comiteada es lo que implica que se puede aplicar. Después el líder les avisa el commit a los demás, y eso hace que los followers puedan aplicarla ellos también, porque cuando respondieron el ACK esa entrada ya tenía que estar en su log.
Commit por mayoría
Hay un paso fácil de pasar por alto: el momento exacto en que el líder le pasa los bytes a la aplicación. Ocurre cuando recibe una mayoría de ACKs, ahí y no antes, porque no puede pasárselo sin tener nodos que hayan confirmado que disponen de ese dato.
Imaginemos que el líder lo pone en su propio log, se lo pasa a la aplicación, le responde OK al cliente, y después muere. El único que tenía el dato era él, y murió con el único disco donde esa entrada estaba escrita: ya le habíamos dicho OK al cliente, pero los otros dos no tienen esa información y se pierde para siempre.
Si en cambio la tenemos por lo menos en otra máquina, la historia es distinta. Cuando muere la del medio, esa otra eventualmente se convierte en líder y aplica el commit arriba. Después le envía ese dato a la que quedó en la otra punta, esa se lo aplica, y ahí se restaura automáticamente todo el sistema, sin que nadie intervenga manualmente.
Lo importante es la garantía que obtiene el cliente. Cuando recibe OK, tiene la garantía de que ese dato no se puede perder a menos que fallen dos máquinas juntas; ese caso queda fuera de lo que el sistema tolera. Pero si falla una sola, el cliente que recibió el OK sabe que ese dato no se va a perder de ninguna forma. ¿Y si queremos que puedan fallar dos? Ahí hay que disponer cinco réplicas, y la coordinación se vuelve más costosa: nos tienen que responder dos antes de confirmar.
Aparece una pregunta natural sobre el orden de los envíos. Uno podría imaginar que el líder le hace el AppendEntries a una réplica, esa responde el ACK, da la entrada por aceptada, y a la otra se lo pasa después. No es así: se lo envía a todas simultáneamente, y el primero que responde ya alcanza para responderle al cliente.
Eso deja abierto un caso incómodo. Puede haber una máquina a la que le enviamos entradas para las cuales nunca se reunió el quórum de respuestas, y esas entradas eventualmente las vamos a tener que borrar. Nuevamente, va a tener sentido cuando veamos el algoritmo completo, pero conviene tenerlo anotado.
La objeción natural es la que uno haría de inmediato: si esto fuera una RPC, uno esperaría un error al vencerse el plazo, o que el líder le respondiera al cliente que no pudo y que reintente. A veces es así, pero no siempre. Se ve mejor con cinco máquinas, donde hacen falta dos ACKs: puede pasar que el líder replique la entrada en una sola y ahí mismo muera. Nos queda una máquina con una log entry que no está en ningún otro lugar y no está comiteada. A partir de ahí puede ser que esa máquina se convierta en líder y actualice a las demás con esa entry, o que otra se convierta en líder y le indique que la borre. Vamos a llegar a ese punto.
Recapitulando: ese es el caso feliz, el que no tiene fallas. Y lo importante es qué garantías tiene el cliente cuando recibe un OK, que son dos. La primera es que la operación está persistida en una mayoría de nodos. La segunda es que está aplicada en el líder.
AppendEntries y RequestVote
Hay una observación que aparece naturalmente al mirar ese AppendEntries: es un paquete rutinario, del estilo del heartbeat que tenía el coordinador de los sistemas anteriores. Y efectivamente hay varias cosas que se combinan en este protocolo: el AppendEntries también sirve de heartbeat, para indicarles a las réplicas que el líder sigue vivo.
En qué sentido es rutinario conviene precisarlo, porque uno diría que lo rutinario es que se envía frecuentemente, y en realidad es al revés. Siempre que un cliente envía un request, la aplicación se lo pasa a Raft y Raft, en ese momento, envía el AppendEntries. Si ningún cliente está enviando updates, Raft está obligado a enviar uno vacío solamente a modo de heartbeat, para que los otros sepan que está vivo.
Podría haberse hecho distinto, y eso lo vuelve una decisión de diseño: se podría haber implementado el heartbeat aparte, y entonces tendríamos tres operaciones, AppendEntries, RequestVote y heartbeat. E inclusive el commit se incluye dentro del AppendEntries, aunque no tenga nada que ver con agregar entradas. Es lo que se llama piggyback: incluir en un único mensaje de red varios datos distintos que el sistema necesita, exactamente para no tener tres tipos de mensajes. Por separado el algoritmo probablemente seguiría siendo correcto a nivel matemático, pero se optó por unificarlo todo en un solo mensaje.
Eso responde de paso a una duda abierta: si el commit es un aviso que el líder envía, entonces no eran dos los mensajes de Raft. El commit no cuenta aparte, precisamente porque viaja incluido en él. Los dos mensajes son AppendEntries y RequestVote.
Y ahí está la famosa figura 2 del paper, que nos va a acompañar durante las próximas semanas y de la que probablemente terminemos algo cansados: es la que enuncia las reglas que hay que implementar, además del estado. Ahí están las dos operaciones. El AppendEntries incluye campos de los que todavía no hablamos, pero entre ellos está el leaderCommit. El líder aprovecha para decir dos cosas a la vez: “agregue esta entrada”, y de paso “yo vengo aplicando hasta este punto; este punto es seguro, así que si lo tiene, aplíquelo también”. Puede ser que el otro no lo tenga, y eso lo vemos la clase que viene; si lo tiene, hasta ahí puede aplicar, porque ese tramo es seguro y eventualmente se lo van a pedir igual. El otro elemento importante son las entries, y ahí hay algo interesante: está optimizado, porque puede enviar muchas juntas. Más allá de lo que digamos en clase sobre esa figura, el paper hay que leerlo de todos modos.
Ese leaderCommit es también el mecanismo del catch-up. Si una máquina se murió por un tiempo y después revivió, las otras dos van a tener un commit más avanzado, y la que revivió va a tardar un tiempo en aplicar todo el log que le falta. Lo que le avisa el líder es dónde está el punto de commit: si le faltan entries, se las va enviando, y ella las aplica hasta ese punto.
Y está el caso inverso: las entradas que se colocan pero que todavía no recibieron una mayoría. Si a una máquina le llega la entrada pero no el commit, no tiene permiso de aplicarla en la capa superior. Y hay algo que parece sencillo pero no es intuitivo: puede haber entries que se agregan al log, que eventualmente se borran y que nunca llegan a aplicarse. Por eso el commit no dice “aplique esto” sino “hasta aquí puede aplicar”, precisamente porque las que llegaron después quizás se borren.
Con todo esto se cierra el círculo con lo primero que vimos: el líder espera una mayoría de respuestas por todo lo que vimos antes. Si la recibe, entonces si hay una partición se va a poder elegir un nuevo líder, y la mitad que tiene al líder va a tener la entrada del log actualizada, la misma por la que se le respondió OK al cliente.
Queda una última observación: los logs pueden diverger. No es que el proceso sea ordenado y los logs avancen todos iguales. Especialmente cuando hay muchas fallas, los logs divergen, y parte del algoritmo de Raft es volver a sincronizarlos sin que se desincronice la capa superior: la máquina de estados no se puede desincronizar. Ese va a ser el punto de la clase que viene.