5. Relojes desincronizados y TrueTime
En esta sección
Lector adelantado y lector atrasado
Llegamos a la pregunta que venía latiendo debajo de todo lo anterior: ¿qué pasa cuando los relojes no están sincronizados?
La primera respuesta es tranquilizadora: para las read-write, nada. Las read-write no tenían nada que ver con el tiempo; la serializabilidad y la consistencia externa quedaban garantizadas por el two-phase locking. Esa mitad del sistema está solucionada.
El problema aparece cuando interviene el tiempo: MVCC y relojes distribuidos por todo el mundo. Si el reloj que usamos para escribir es distinto del que usamos para leer, pueden estar desincronizados, y el resultado puede ser incorrecto.
Para las read-only hay dos casos, y no son igual de graves. El primero es el del lector adelantado. Ahí la lectura es correcta —técnicamente correcta, sin trampa—, pero lenta, porque hay que esperar el safe time. Si son las 7 de la tarde y mandamos una lectura que dice las 9 de la noche, tiene que esperar hasta que se escriba algo con timestamp mayor que las 9, es decir, hasta que sean las 9 y alguien escriba algo después. Va a ser correcta: técnicamente vamos a estar leyendo un snapshot de las 9 de la noche. Pero para eso tenemos que esperar a que lleguen las 9. Ese caso no es tan terrible, y en el fondo es simplemente una cuestión de performance: queremos que todo esté lo más sincronizado posible para que funcione rápido.
El segundo caso es el del lector atrasado, y ahí sí está el problema. Mandamos una lectura con un timestamp en el pasado: aunque queremos el valor de ahora, es como si etiquetáramos la transacción con las 12 del mediodía. Con el tiempo incorrecto, leemos cosas del pasado.
Los ejemplos son exagerados a propósito, pero con que la diferencia sea de algunos milisegundos ya rompemos lo que nos habíamos impuesto: la lectura es inconsistente, porque es no linealizable.
Un ejemplo cotidiano: un sitio web actualiza un campo de un formulario a través de un cliente, que etiqueta la transacción con su timestamp; después queremos leerla inmediatamente y llegamos por otro cliente con un timestamp atrasado. No vamos a ver el formulario que acabamos de mandar.
En algunos sistemas eso es aceptable. Dynamo funciona así: uno escribe, lee inmediatamente, y quizás no lo ve. En Spanner, por diseño, es inaceptable, porque tiene que ser fuertemente consistente: si mandé una escritura, me respondió, y al microsegundo la leo, tengo que verla. Lograr eso es toda la mitad de la clase que nos falta.
Y este es el punto que más importa: nos lo autoimponemos. En Dynamo es aceptable; en Spanner no, por requisito de diseño. Por eso tanto esfuerzo para evitarlo, y no porque el sistema deje de funcionar. Con un lector atrasado tendríamos, de hecho, una versión de consistencia eventual: eventualmente el lector avanza y vemos lo que tenemos que ver.
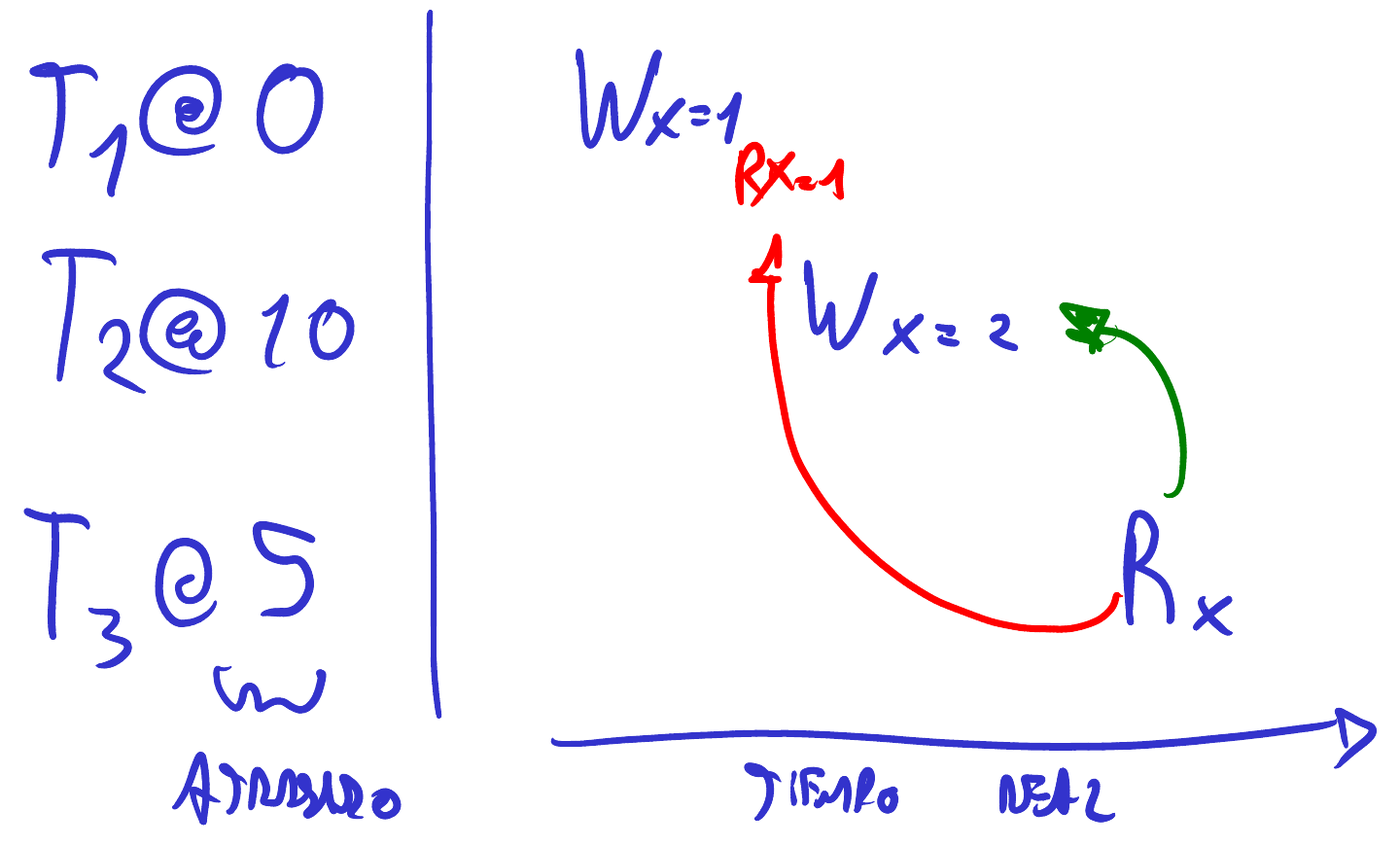
Hagámoslo con números. La transacción uno, en el timestamp 0, escribe x = 1. La transacción dos, en el 10, escribe x = 2. Esto es el tiempo real. Después mandamos la transacción tres, que lee x.
Mirando el tiempo real, esta lectura tendría que devolver el valor de la transacción dos: escribimos x = 1 y se confirma; escribimos x = 2 y se confirma; leemos x, tiene que volver 2.
Pero esta máquina está atrasada y tiene timestamp 5. Aunque la lectura se ejecutó después de las dos escrituras, el MVCC va a buscar una versión menor a 5; como la escritura de x = 2 está en el 10, la lectura cae en el medio y devuelve x = 1. Eso está mal: tendría que haber caído después de la escritura del 10. Que una máquina tenga el reloj atrasado invalida todas las garantías.
¿Cómo se soluciona? Hay que sincronizar relojes. Y el problema es que es imposible, como hablamos en la clase de Lamport: no es físicamente posible sincronizar exactamente los relojes, siempre queda una diferencia que no podemos obtener. Vale la pena repensar esa clase con esto en la cabeza, porque todo lo anterior se basa en relojes perfectamente sincronizados, y no lo están.
TrueTime
Lo que inventó Google fue una innovación del paper, y la llamaron TrueTime. No es una técnica tan general como para usarla en varios lugares, pero sirve bien para ilustrar y para reforzar la clase de Lamport, porque deja ver la complejidad del mecanismo que tuvieron que construir para hacer un sistema basado en sincronización de relojes físicos, cosa que en teoría es imposible.
La idea clave es que el tiempo ya no es un escalar, sino un tipo de dato abstracto, un TDA, y ese TDA es un intervalo con dos valores: el earliest y el latest.
Tiene varias primitivas. Una es now, que devuelve el true time de ahora, es decir, ese intervalo. La idea es que el tiempo real físico, exacto, internacionalmente avalado, es algún valor dentro de ese intervalo.
Se parece bastante a un intervalo de confianza, y la comparación ayuda. En un intervalo de confianza hay una probabilidad alta de que el valor esté adentro. Aquí lo que se garantiza es que el tiempo actual es mayor que el earliest y menor que el latest. Por qué tiene que ser un intervalo y no un valor solo, lo vamos a ver enseguida.
Hay dos primitivas más en el paper. Una es after, que recibe otro tiempo y devuelve verdadero si ya pasó. Pensemos cómo se hace. Sobre una línea de tiempo está nuestro intervalo, con su earliest y su latest. Para estar seguros de que el otro valor ya ocurrió, el earliest del otro tiene que ser mayor que nuestro latest: los intervalos no se tienen que solapar. Si se solapan, no hay seguridad. Si no se solapan, ahí reside toda la potencia del invento: tenemos la garantía de que realmente ocurrió después. No sabemos exactamente cuándo, pero sabemos que después, y esa es la base de toda la solución.
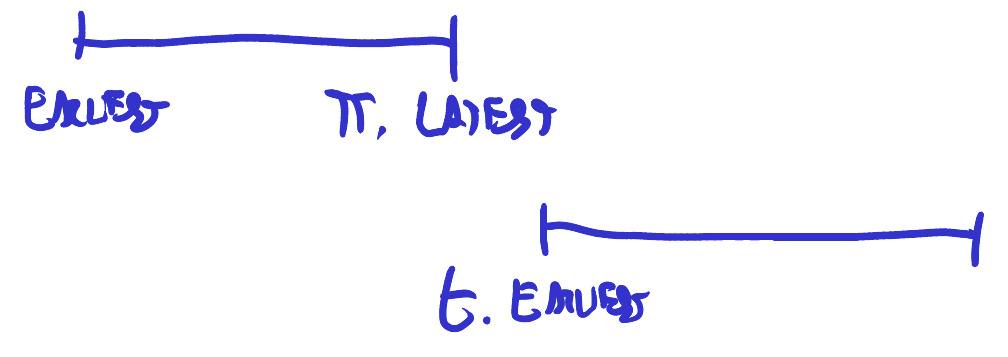
La otra es before, que es lo mismo pero al revés: se fija que el intervalo ocurra primero.
Con eso ya podemos ver por qué hacen falta relojes atómicos. Sin entrar en demasiado detalle, la arquitectura es así: está el servidor de uno, y algunos servidores llamados time master, una especie de cadena de servidores conectados físicamente a un reloj atómico o a un GPS.
Cómo un reloj atómico o un GPS obtiene el tiempo exacto es más de electrónica. Lo que tienen, más que un tiempo absoluto más preciso, es muy poco drift. Drift es lo que un reloj se va atrasando. Un reloj mecánico había que ajustarlo cada tanto, porque se atrasaba; uno de cuarzo no es un gran problema para nosotros, pero también se atrasa. ¿Cuánto? Spanner no apuesta a la cifra real de cada máquina: adopta una cota deliberadamente pesimista de 200 microsegundos por segundo y razona siempre con esa. Ese número, que parece un detalle de implementación, gobierna todo lo que sigue.
El mecanismo es este. Cuando hacemos un get time, nos devuelve un intervalo con su earliest y su latest, que guardamos localmente y vamos adelantando con el reloj de cuarzo de la máquina. Pero como es de cuarzo, la incertidumbre va aumentando: el intervalo, inicialmente pequeño, se va ensanchando —en milisegundos o microsegundos—, y hay que dejarlo crecer. Por eso cada 30 segundos se vuelve a hacer get time, se obtiene otra vez un intervalo pequeño, y así se va regulando.
Y aquí se ve de dónde salen los 30 segundos, porque los dos números se multiplican: treinta segundos a 200 microsegundos por segundo son exactamente 6 milisegundos de ensanchamiento. Es lo que puede acumular el intervalo justo antes de la siguiente consulta, y explica la forma de la incertidumbre en producción: un diente de sierra que arranca angosto después de cada get time, crece hasta unos 6 milisegundos y vuelve a caer. Sumado al milisegundo que cuesta la comunicación con el time master, el intervalo va de 1 a 7 milisegundos, y se queda en 4 la mayor parte del tiempo. Esos 4 milisegundos son la moneda con la que vamos a pagar todo lo que viene después.
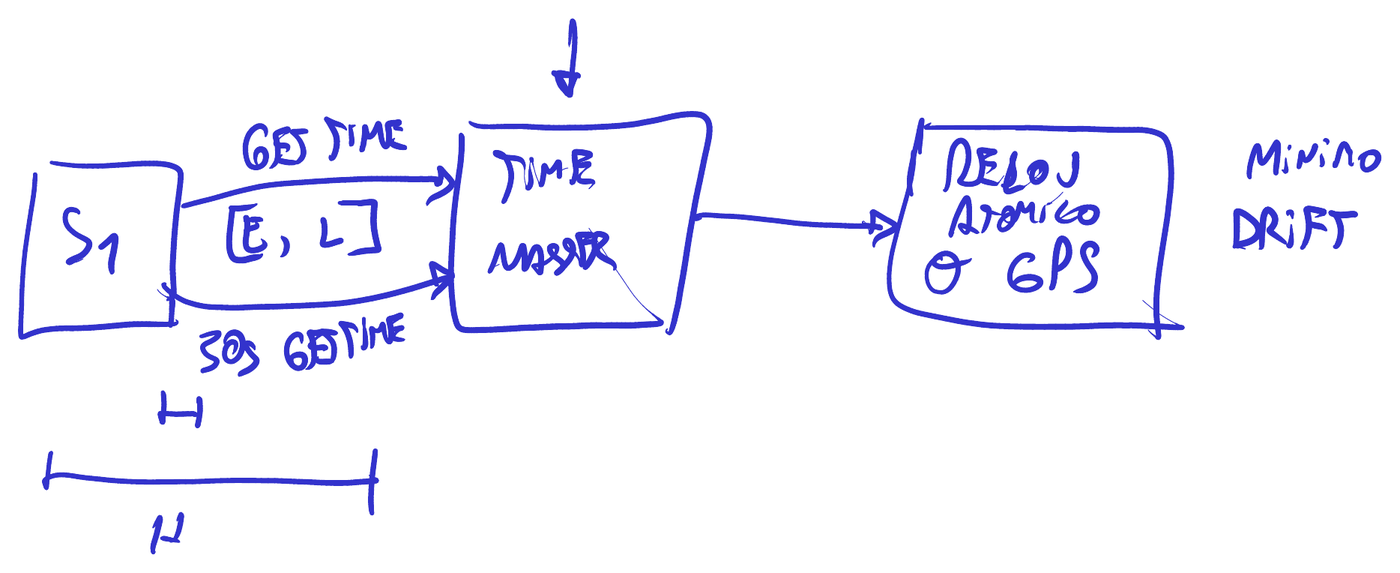
Lo del reloj atómico no es esencial para nuestra clase, pero es interesante: está para que la fuente de verdad no vaya estirando su intervalo, sino que se mantenga pequeño y confiable. Todo el drift lo tenemos localmente, y pidiendo cada 30 segundos nos vamos actualizando. Es un detalle técnico curioso; el paper le dedica una porción grande, que a nosotros no nos importa tanto.
Los números de este pasaje —la tasa aplicada de 200 microsegundos por segundo, el intervalo de consulta de 30 segundos y el diente de sierra de 1 a 7 milisegundos— están en la sección 3 del paper.