6. Divergencia de los logs
En esta sección
Restricción de elección
La segunda de esas condiciones —votar solamente candidatos actualizados— parece una precaución menor mientras no se vea qué pasa si no está. Hacen falta, entonces, un par de ejemplos de cómo puede quedar un log después de unas cuantas fallas. El primero es el mismo que usa el curso del MIT, cuyas clases están en YouTube.
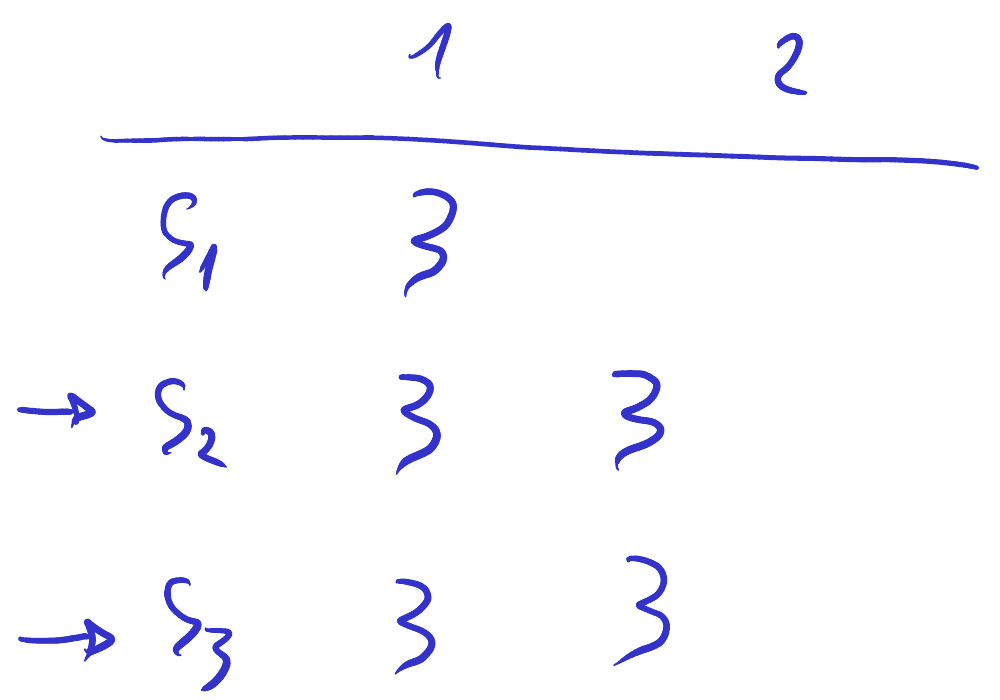
Empecemos por el estado al que queremos llegar. Tenemos tres servidores, S1, S2 y S3, con el log de cada uno como una fila de casilleros. Recordemos la convención: el número de cada casillero no es el dato, es el término en que se escribió. S1 tiene una sola entrada, del término 3; S2 tiene dos, las dos del término 3; y S3 también tiene dos del término 3. Algo que vamos a poder demostrar más adelante y que por ahora tomamos como dado: si dos servidores tienen dos entradas del término 3, está garantizado que su contenido es el mismo. No son dos entradas cualesquiera en cada uno; son las mismas.
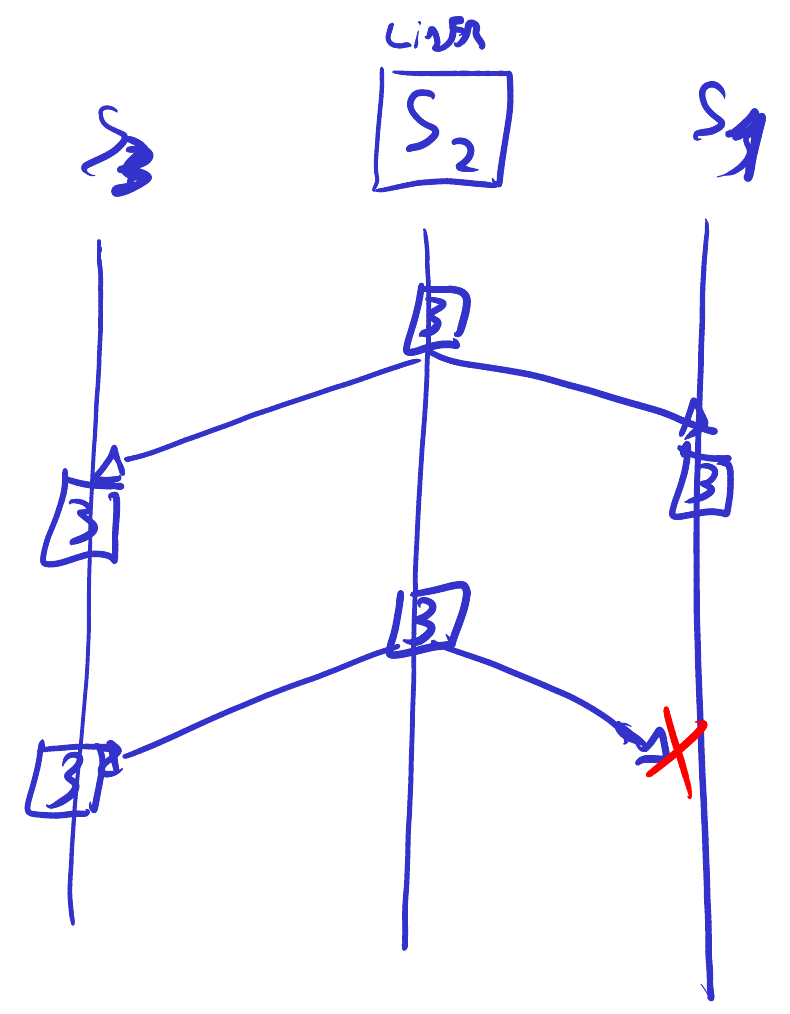
¿Cómo se llega ahí? Dibujemos las tres líneas de tiempo y asumamos que el líder es S2. Podría ser S3 también; con S1 como líder, en cambio, no se llega a ninguna parte. Al principio los tres logs están vacíos. El líder toma la primera entrada del término 3, la guarda en su log y se la envía a los otros dos, que la escriben. Después aparece una segunda: la escribe localmente y se la envía a uno, que también la escribe. Y cuando va a enviársela al otro, muere. Así quedamos exactamente con los tres logs descritos arriba. Lo que importa es eso: ese estado, que parece un accidente improbable, es alcanzable.
Lo que sigue conviene retenerlo, porque es la técnica general para analizar estas situaciones: hagamos que el líder muera y reviva inmediatamente. Al revivir se olvidó de que era líder —revive como follower—, y eventualmente se inicia una nueva elección entre los tres.
Y aquí está la clave: no cualquiera de los tres puede ser líder, porque una de las cosas que hace el líder es sincronizar el log de los demás con el propio. Si S1, el que tiene una sola entrada, fuera elegido líder, lo que va a tratar de hacer es borrar las dos entradas que los otros tienen y él no.
¿Cuál es el problema? Puede ser que el líder anterior ya le haya informado al cliente que la operación salió bien, porque ya tenía esa entrada en dos lugares de tres, un quórum. Puede ser también que todavía no le haya respondido nada: no sabemos qué sabe el cliente. Pero el peor caso es el primero, y con que sea posible ya alcanza. Le dijimos al cliente que su operación estaba, y después borramos esa entrada. Eso no se puede hacer.
La condición a la que llegamos es que el líder va a poder ser cualquiera de los dos que tienen las dos entradas, pero nunca S1, porque no se pueden borrar entradas comiteadas.
Y así es muy fácil saber qué está comiteado, porque comitear en Raft no depende de los mensajes de commit: es por definición. Si una log entry está en una mayoría de logs, está comiteada y no se puede borrar nunca más. La razón última no es ni siquiera la del cliente: si está comiteada, quizás ya fue aplicada a la capa superior, y borrarla nos dejaría la aplicación inconsistente con el log. Eso es todavía peor.
Como definición general esto no alcanza, y es justamente lo que muestra la figura 8 del paper: una entrada de un término anterior replicada en una mayoría todavía puede ser sobrescrita. Raft exige que la entrada sea del término del líder actual para considerarla comiteada; las de términos anteriores quedan comiteadas indirectamente, cuando se comitea una entrada posterior del término en curso. Para el caso que estamos analizando el razonamiento vale igual.
Logs divergentes
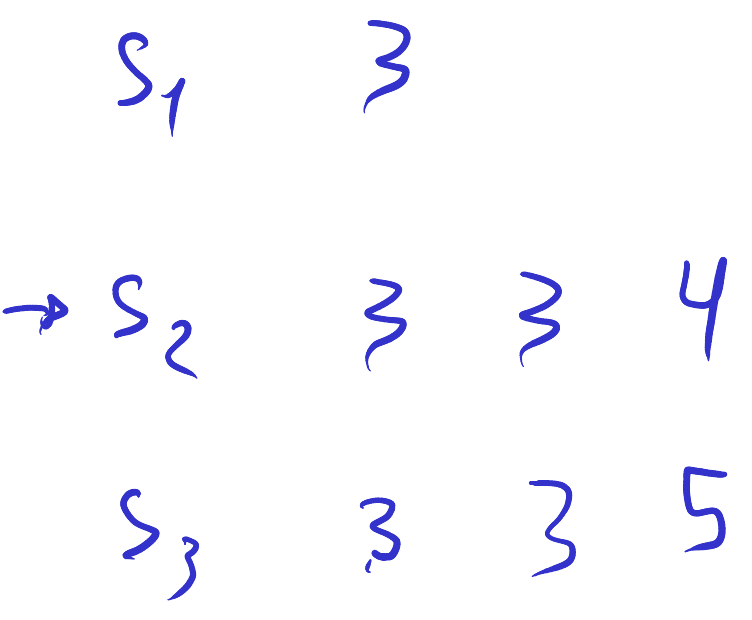
El segundo ejemplo es más complicado, y ahí el log queda en un estado más extraño. Partamos del caso que acabamos de construir y agreguémosle un par de fallas más. El estado al que vamos a llegar es este: S1 tiene una sola entrada del término 3; S2 tiene dos del término 3 y una tercera del término 4; y S3 tiene dos del término 3 y una tercera del término 5. Esas dos últimas filas merecen detenerse: dos servidores tienen, en el mismo casillero, el tercero, términos distintos: uno un cuatro y el otro un cinco. Los logs divergieron.
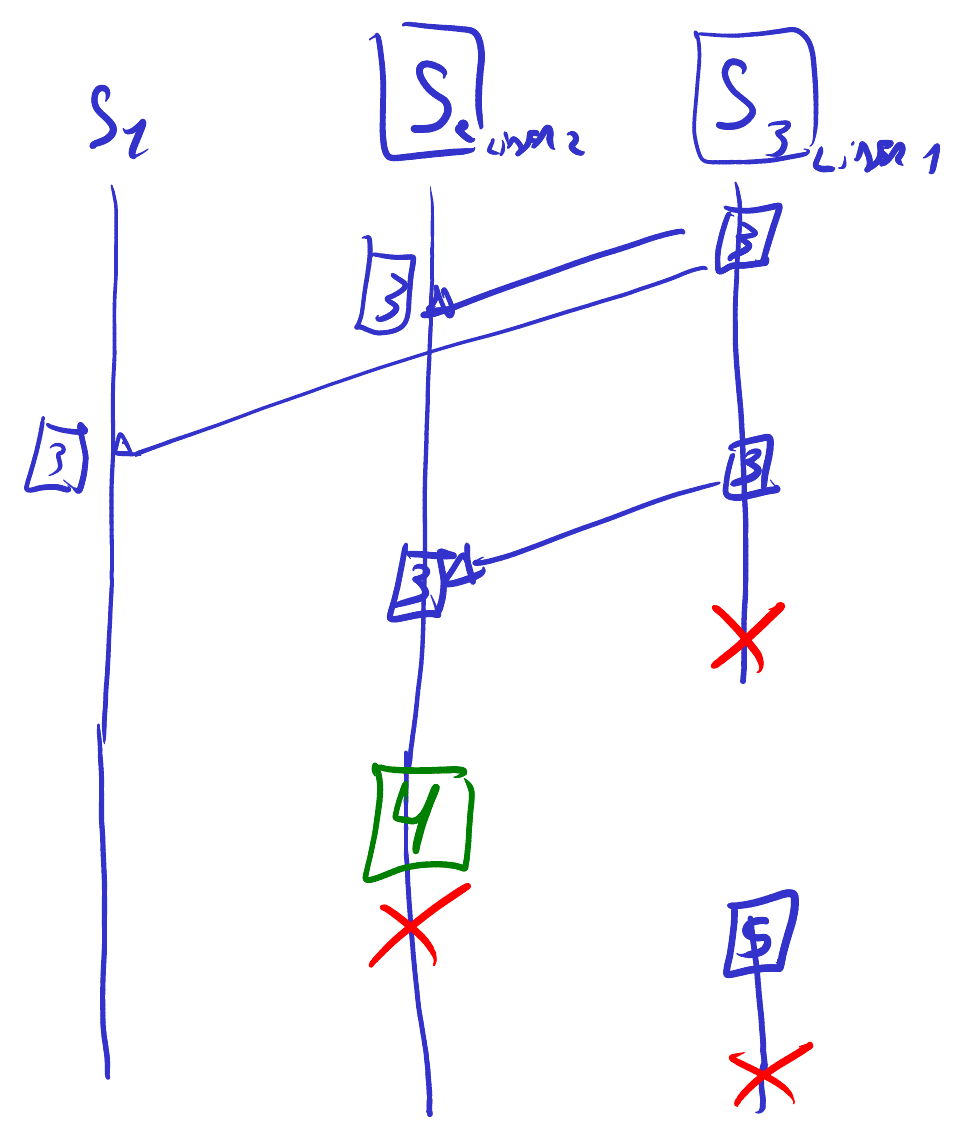
¿Cómo se llega a que dos logs queden diferentes? Volvamos a las tres líneas de tiempo y asumamos que el primer líder es S3. Escribe la primera entrada del término 3 y se la envía a los otros dos, así que los tres quedan con ella. Después aparece una segunda del término 3, y de esa alcanza a enviársela a uno solo, a S2, que la escribe. Y ahí muere, y de él no vuelve a saberse nada durante un tiempo prolongado.
Eventualmente se elige un segundo líder, que va a ser S2. A ese líder le llega un request, lo guarda en su log como una entrada del término 4 —el término es otro porque hubo una elección en el medio— y muere inmediatamente después de escribirlo, sin alcanzar a enviárselo a nadie. Ahora los dos líderes que hubo están muertos.
Entonces el primero revive, justo en un momento en que no hay ningún líder. Se inicia una nueva elección, es elegido líder otra vez, y escribe una entrada del término 5 en el mismo casillero en el que el otro había escrito su cuatro. Y hasta ahí llega: muere otra vez sin enviársela a nadie. Después reviven los tres, y así llegamos al estado dibujado más arriba. El recorrido sirve para mostrar que es posible llegar a estados tan poco intuitivos como este, con máquinas que mueren y reviven constantemente.
Desde ese punto pueden pasar varias cosas, y el detalle es tema de la clase que viene, pero el planteo se puede hacer aquí. Por la misma razón que antes, el cuatro y el cinco no están comiteados: ninguno está en una mayoría de logs. Eso quiere decir dos cosas. La primera, que a S1 no lo vamos a poder elegir líder en ningún caso. La segunda, que los dos candidatos que quedan tienen contenidos diferentes al final de su log.
Lo que hace Raft en este punto es interesante: el algoritmo de elección puede elegir a cualquiera de los dos. Supongamos que elige al del cuatro, a S2. Conviene ser preciso con qué lo hace elegible, porque no es tener el log más actualizado de los tres: el de S3 lo supera, porque termina en un cinco. La regla pide que su log esté al menos tan actualizado como el de una mayoría de nodos, y eso S2 lo cumple: está más actualizado que S1, y con su propio voto más el de S1 reúne dos de tres. S3 no lo votaría, y no hace falta.
¿Y qué hace ese nuevo líder? Con S1 es fácil: le envía las entradas que le faltan, la segunda del término 3 y la del término 4. Con el otro el caso se vuelve menos evidente. Ve que las dos primeras coinciden, y aquí viene lo contraintuitivo: elimina la entrada del término 5 y coloca un 4 en su lugar. Visto desde fuera resulta polémico. Y funciona.
¿Por qué funciona? Hay que volver a la situación en que los tres logs quedaron divergentes. La entrada del cuatro no estaba en una mayoría de nodos, y aun así su dueño fue elegido líder. Y si no está en una mayoría, nunca le respondimos OK al cliente: no se le respondió absolutamente nada, así que no sabe si esa entrada fue comiteada. Y lo mismo pasa con la del cinco.
Como ninguna de las dos fue aprobada —a nadie se le dijo que estaba comiteada—, lo que Raft puede hacer, y esto es lo difícil de aceptar como legal, es elegir cualquiera de las dos y decidir a posteriori que esa es la que va a quedar comiteada.
En el ejemplo, la del cuatro termina comiteada y el cliente nunca se enteró. Y desde su punto de vista tiene todo el sentido: envió la entrada y no recibió ninguna respuesta. Lo que Raft le está diciendo al no responder es que quizás la comiteó y quizás no, y que no puede afirmar nada al respecto. A lo sumo el cliente puede hacer un retry, o una lectura para verificar si está comiteada. Pero a falta de OK, el cliente no sabe.
Y eso vale en los dos sentidos, que es lo que cierra el razonamiento. De la entrada del cuatro el cliente no sabía si estaba o no, y terminó comiteada. De la del cinco tampoco sabía, y se decidió que no queda comiteada. En los dos casos el cliente estaba en la misma ignorancia, y en los dos Raft quedaba libre de resolver en cualquiera de los dos sentidos. El resultado final es que los tres logs quedan sincronizados con las mismas tres entradas: dos del término 3 y una del término 4.
Todo lo que vimos hoy es consecuencia de un solo hecho aritmético: una cantidad impar de nodos, combinada con la regla de la mitad más uno, produce una asimetría. De cualquier corte de la red sale exactamente una mitad con mayoría y una sin ella, y eso le permite a cada una decidir por sí sola, sin comunicarse con la otra, cuál de las dos le corresponde ser. Todo lo demás se sigue de ahí. El candidato necesita una mayoría de votos porque dos mayorías no pueden coexistir en el mismo término, y de ahí sale también que el votante emita un voto por término y solamente a candidatos actualizados. El líder espera una mayoría de ACKs antes de comitear porque cualquier elección futura va a contener al menos un nodo que tenga esa entrada. Y hasta la libertad de borrar el cinco de S3 sale de ahí: si la entrada nunca llegó a una mayoría, nadie pudo haber recibido un OK por ella, y lo que nadie prometió se puede deshacer. La otra mitad del algoritmo —cómo se sincronizan logs como los que acabamos de describir— es de la clase que viene, y para entonces el paper ya tendría que estar leído: entenderlo lleva por lo menos una semana de lecturas, así que conviene empezar desde ahora.