3. Lecturas linealizables en Raft
Con la definición disponible, volvamos a Raft. El tema no es tan evidente: en principio, para que las lecturas sean linealizables siempre hay que leer del líder, porque leyendo de un follower nunca vamos a obtener esa garantía, como mostramos en la primera sección. Pero hay algo todavía más incómodo: aun leyendo del líder no alcanza.
No alcanza por situaciones como la que vimos la clase pasada. Imaginemos un líder y, repentinamente, una partición de red. Del otro lado se elige un nuevo líder, y esa mitad comienza a avanzar. Y entonces llega un cliente y lee del líder —o, más precisamente, de quien cree ser líder—: ese nodo le responde un valor que puede estar desactualizado, uno que del otro lado ya cambió. Dirigirse al líder no es suficiente, al menos no ante fallas, y se requieren condiciones adicionales. El caso debería resultar claro: leímos de un líder que en realidad es una especie de follower desactualizado, y que eventualmente se va a convertir en follower.
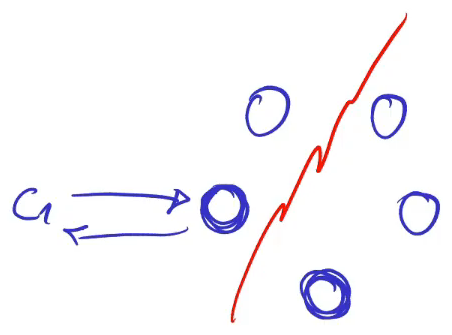
La pregunta es cómo garantizar que las lecturas sean linealizables. Y la respuesta aparece por analogía, examinando por qué las escrituras sí lo son: van al log, se escriben en los followers, se espera confirmación, y solo entonces le respondemos al cliente. Si hacemos lo mismo con las lecturas, el sistema va a resultar linealizable.
Veámoslo dibujando solamente al líder. Le llega una lectura de x, y supongamos que sobre ese nodo tenemos la base de datos efectiva. La forma rápida sería que la lectura se dirija directamente, lea y devuelva el valor. La estrictamente linealizable es contraintuitiva: lo primero que hace el líder es escribirla en el log, con el ID de la operación, enviarla a los vecinos y recibir un quórum; solo entonces volvemos a la capa superior y, como se trata de una lectura, simplemente se realiza y se devuelve. No estamos modificando la base de datos: le indicamos que complete la operación por la que el cliente esperó todo ese tiempo, después de todo el intercambio con los vecinos y su confirmación, como si se tratara de una escritura.
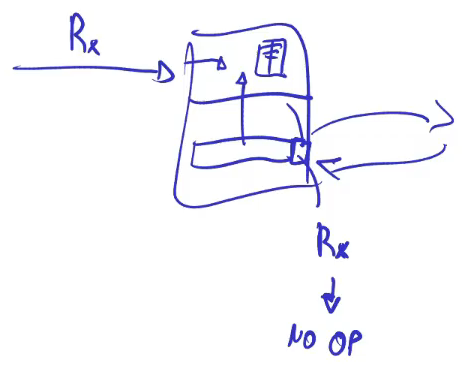
Esa entrada que colocamos en el log es el equivalente de un no-op: si bien la operación es una lectura, no modifica la máquina de estado distribuida. Normalmente en el log registramos solamente las mutaciones, por una razón conocida: se aplican en el mismo orden en todos los nodos, y así se sincronizan las máquinas de estado de cada réplica. Pero el mismo mecanismo puede emplearse para las lecturas, y si ya nos convencimos de que las escrituras funcionan correctamente de este modo, debería resultar evidente por qué funciona.
Y si no, lo contrastamos con el caso que nos trajo hasta aquí. ¿Qué ocurre durante una partición? El líder le envía la entrada de la lectura a su único vecino de ese lado, y ese le confirma. Intenta enviársela a otro y no alcanza destino alguno. Va a quedar intentando reunir confirmaciones, no va a recibir ninguna, y eventualmente le va a responder un error al cliente: en la mitad minoritaria no se reúne quórum, y sin quórum la lectura no puede responderse.
Esa es una forma de garantizar linealizabilidad fuerte, irrompible, en Raft. El problema es que resulta muy costosa. Si lecturas y escrituras estuvieran muy equilibradas no habría inconveniente, pero en general los sistemas leen mucho y escriben poco, y allí el costo se vuelve significativo. En un sistema que realiza 100 lecturas por cada escritura, las lecturas representan el 99 % de las operaciones; imponerle a cada una el precio de una escritura —un viaje de ida y vuelta a la mayoría del cluster— multiplica por 100 el tráfico de coordinación para atender la misma carga. A la inversa: respondidas localmente, un cluster de cinco máquinas las repartiría entre cinco en lugar de concentrarlas en el líder.
No existe una solución oficial para esto, pero el paper de Raft propone dos cosas interesantes. El ejemplo del líder desactualizado es el más sencillo; hay otro caso que atender, el primero que menciona el paper. Imaginemos la otra mitad de la partición: eventualmente ese nodo se activa y es elegido líder, y al ser elegido tenemos la garantía de que va a contener en el log todo lo comiteado, y quizás más, que eventualmente comitearemos. El problema es otro: no sabemos hasta qué punto el otro líder lo había comiteado, ni si la base de datos ya lo refleja. No conocemos cuál era el punto de commit del líder anterior, porque puede haber avanzado y el líder haber fallado antes de informarlo.
Lo que corresponde hacer es avanzar el log completo hasta nuestro final. Para eso el paper propone algo similar a lo anterior: generar una operación ficticia, un no-op, sincronizarla con los vecinos y obtener el quórum; en ese punto el líder ya sabe que esa operación es el punto de commit, comitea todo lo anterior y solo entonces comienza a responderles a los clientes. Eso indica el paper: cada líder comitea una entrada vacía al iniciar su término. Y de allí se desprende una alternativa más rudimentaria, que el paper no menciona: no responder ninguna lectura hasta recibir una escritura. Cualquier entrada de nuestro propio término resulta igualmente válida, de modo que la ubicamos al final del log, sincronizamos, ese va a ser el punto de commit, y a partir de allí podemos responder. El costo es la espera: si nadie escribe, no leemos.
Eso resuelve un problema, pero no el otro: el del líder que desconoce que dejó de serlo. La única forma de comprobar que somos líder es consultarle a un quórum y obtener respuesta afirmativa. Y eso es esencialmente lo mismo que antes: allí colocábamos una operación en el log y obteníamos un quórum de respuestas; ahora, si se trata de una lectura, debemos consultar a los demás de todos modos. Resulta igual de poco performante.
Y llegamos a la parte interesante, la optimización que propone el paper. ¿Recordamos los leases del Google File System? Se trata de combinar esa idea con esta: que cada cinco segundos el líder verifique si continúa siéndolo, y que durante el resto de esos cinco segundos pueda responder lecturas directamente, sin consultar a nadie. Si en ese lapso deja de ser líder y continúa respondiendo, el sistema va a funcionar correctamente en tanto en la otra mitad no se agreguen escrituras nuevas: si esa mitad no acepta ninguna durante esos cinco segundos, todo permanece consistente. La escritura se bloquea cinco segundos, pero el sistema sigue funcionando.
Ese es, entonces, un esquema sencillo de leases, y son dos las reglas que hay que agregar: el líder verifica su liderazgo cada N segundos, y un líder nuevo no acepta escrituras durante N segundos.
El paper agrega una advertencia que marca en qué se diferencia de todo lo demás: el esquema del lease apoya la corrección en el tiempo, no en los mensajes. Asume que los relojes no se desvían más allá de una cota conocida. Todo el resto de Raft es seguro sin suponer nada sobre los relojes —los timeouts afectan la disponibilidad, no la corrección—, y aquí, en cambio, si un reloj se desvía lo suficiente, puede leerse un valor desactualizado. Es el único lugar del algoritmo donde el reloj interviene en el argumento de seguridad, y esa es la moneda con la que se paga la performance.
Y hay un punto final donde resulta fácil confundirse: esto no se relaciona con el split brain. En el GFS los leases servían para evitar que se produjeran dos mitades; eso ya está cubierto por Raft. Aquí se emplea el mismo concepto —máquinas que esperan un lapso antes de operar— pero solo para garantizar la linealizabilidad del sistema. Es una solución ingeniosa, y una buena forma de resolverlo.