5. Modelo de consistencia de Zookeeper
En esta sección
Garantías de consistencia
Descartar la linealizabilidad no puede significar quedarse sin ninguna restricción: alguna debe existir. El modelo de Zookeeper es una combinación de consistencia fuerte con consistencia no fuerte, lo cual dificulta el razonamiento y la implementación, pero es exactamente eso lo que proporciona más performance. Resulta mucho más sencillo saber que un sistema es simplemente de consistencia eventual —que a veces leeremos datos desactualizados y a veces no, como DynamoDB—, y muchísimo más sencillo saber que es linealizable. Aquí debemos razonar con más cuidado si lo que construimos va a funcionar.
El paper plantea dos requerimientos de consistencia. El primero son las escrituras linealizables, con una precisión que conviene registrar sin detenerse demasiado: la linealizabilidad que emplean no es exactamente la de Herlihy y Wing, y por eso la denominan A-linearizability, linealizabilidad asincrónica. La diferencia es una sola: en la definición original un cliente puede tener una única operación pendiente a la vez, porque es un thread, y aquí se le permite tener varias. La misma idea de siempre, con los clientes autorizados a pipelinear sus escrituras.
Que las escrituras sean linealizables significa dos cosas. La primera, la evidente, es que todas las réplicas las reciben en el mismo orden: todas pasan por el líder, y como es el mismo orden para todos, implícitamente podemos disponer de replicación por máquina de estado distribuida.
Ambos términos, tanto este como el siguiente, tienen denominaciones confusas. “Escritura linealizable” resulta difícil de conceptualizar, porque es difícil apreciar la linealizabilidad de un sistema si uno solo escribe y nunca lee: todos los ejemplos que vimos se basaban en escribir y leer y evaluar si el orden tenía sentido.
La segunda condición que ofrecen es que permiten optimistic locking. La intuición del nombre apunta a lo siguiente: bloquear, tomar un valor, desbloquear y validar solamente sobre ese valor. Lo vamos a ver en detalle más adelante, pero concretamente se trata de una escritura condicional: uno escribe algo con una condición, y si se cumple se acepta. Eso habilita una forma de locking que se emplea principalmente en DynamoDB al trabajar con transacciones; y aquí también, con esos números de versión que aparecieron en la API.
Lo importante es que acepta la escritura si el valor era igual a determinado valor, y entonces equivale a una lectura y una escritura al mismo tiempo. Por eso allí tiene más sentido conceptualizarlo, porque el orden ya resulta relevante: es linealizable porque equivale a leer y escribir de manera contigua.
Pasemos al segundo requerimiento, más sencillo y quizás más interesante: FIFO client order, otra denominación poco transparente del paper. Conviene pensarlo como dos propiedades, planteadas desde la perspectiva del cliente. Si no queda claro ahora, al ver la implementación probablemente se aclare.
Se denominan read your writes y monotonic reads. En el paper de Zookeeper esto no se menciona, pero conviene saber que esos dos términos, y dos más, provienen de un paper anterior, de una base de datos denominada Bayou: un paper de 1994, de Terry y varios coautores.
Read your writes establece que si escribimos algo y después leemos, necesariamente debemos leer lo que escribimos. A menos que otro cliente haya escrito ese mismo valor en el intervalo, y en ese caso vamos a leer algo diferente, pero con la garantía de que se escribió después del nuestro. Dicho a la inversa: si escribimos x = 1 y después leemos, nunca puede ocurrir que obtengamos un valor anterior. En un sistema simplemente de consistencia eventual eso era posible: de hecho, la clase comenzó con ese ejemplo. Zookeeper plantea: no es linealizable, pero tampoco carece por completo de garantías. Siempre vamos a poder leer lo que escribimos.
Y aquí aparece la excepción, con todas las letras. Si otro cliente en otro lugar lee el mismo valor, ese sí puede obtener el valor anterior. Eso es legal: el read your writes se define enteramente desde la perspectiva del cliente, con lo cual esa lectura del otro es inconsistente y está permitida.
La otra propiedad, monotonic reads, consiste esencialmente en que no puede leerse información del pasado. Imaginemos que ese cliente que leyó el valor anterior lee nuevamente y ahora sí obtiene el nuevo: es correcto, para eso existe la consistencia eventual. Lo que agrega esta propiedad es que si lee una vez más, debe volver a obtener el valor nuevo, no el anterior. No puede ocurrir que a veces responda datos del pasado y a veces datos actualizados: si ya leímos un valor, lo que leamos ahora debe estar al menos igual de actualizado.
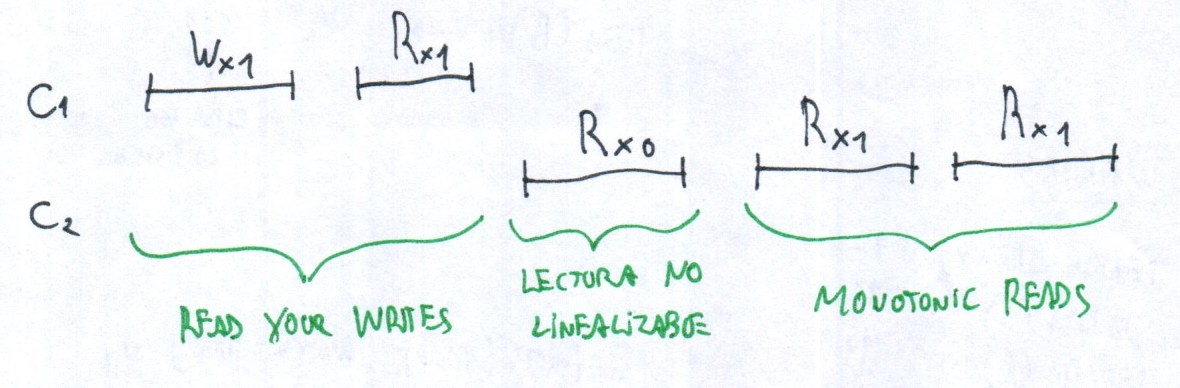
Y hay algo fácil de pasar por alto: ese valor puede no ser el más actualizado del sistema. Puede ocurrir que en el intervalo alguien haya escrito x = 2 y que continuemos leyendo x = 1, y eso es perfectamente legal. Lo relevante es que no sea cero, porque esa es la otra condición. Y eso es todo: en la historia que representamos no hay nada ilegal.
ZXID del cliente
Cómo se logra todo esto resulta más fácil de comprender desde la implementación, y alcanza con dibujar una sola de las máquinas. En la parte superior tiene su árbol de nodos —lo que hay arriba, por ahora, no es relevante— y abajo el log de operaciones. Al costado un cliente, que nos va a enviar un Wx1. Marquemos esa operación con un recuadro de color en el log, para tenerla presente más adelante.
La escritura llega, se transmite a la capa inferior, se agrega al log, y desde allí se envía a los followers igual que antes. Los followers responden, la confirmación asciende a la capa superior, y la máquina le responde al cliente. Pero le responde algo importante, y conviene destacarlo porque es el centro de todo lo que sigue: una confirmación de que la operación se realizó —su forma es indistinta— y, sobre todo, un ZXID.
Ese ZXID es la posición del log en la que quedó comiteada esa operación. Nada más que eso.
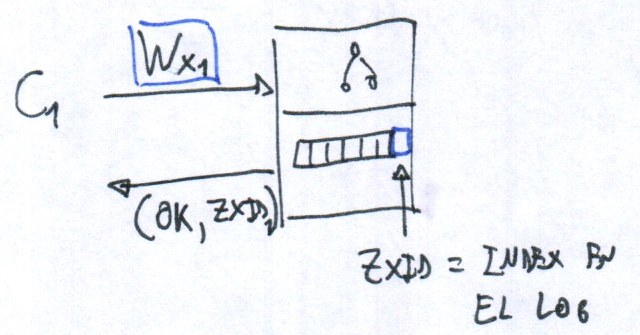
Ese número, en el Raft que venimos implementando, era completamente interno: el índice del log, que se intercambiaba entre los nodos para sincronizarse y restaurar el estado, y nadie desde afuera lo observaba. Aquí, en cambio, se vuelve visible para los clientes. Y el cliente lo va a retener: lo guarda en memoria, registrando ZXID = 100, por ejemplo.
El mecanismo está en lo que sigue. Dibujemos un segundo log junto al primero, el de un follower. El primero debía ser necesariamente el del líder, porque solo allí se escribe. El del follower está desactualizado: le falta la entrada que acaba de escribirse.
Y lo que el cliente pretende ahora es leer lo que acaba de escribir. Por la garantía anterior, debemos obtener información actualizada, y este follower no lo está. Entonces, al enviarle la lectura, no va a transmitirle solamente “quiero leer x”, sino eso más el último ZXID que observó. Dicho de otro modo: quiero leer de alguien que disponga al menos hasta esa posición.
Ese ZXID el follower no lo tiene. El paper no especifica qué hacer, pero supongamos que queda bloqueado hasta actualizarse. Eventualmente el líder le va a enviar esa información, el follower la va a agregar a su log, la va a comitear, la va a aplicar a la capa superior, y solo entonces le va a responder Rx1.
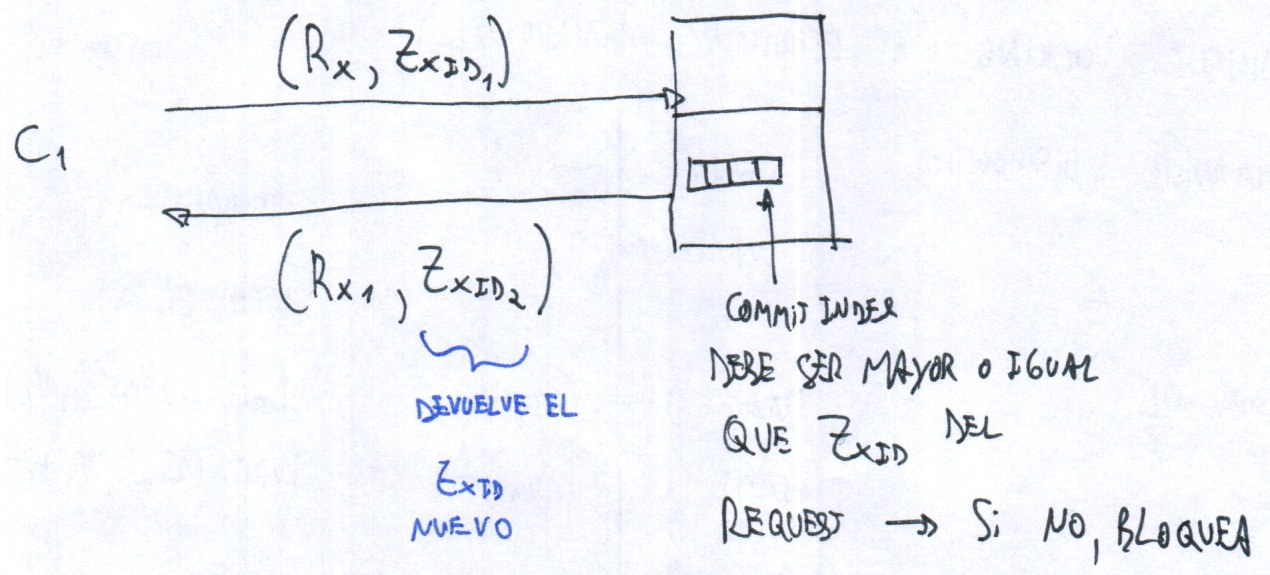
Generalizando: existe un mecanismo de espera, o de sincronización, dentro de los followers, y se apoya en lo que les transmite el cliente. El follower debe estar al menos tan actualizado como eso. Puede estarlo más, naturalmente: el cliente puede haber conservado un ZXID antiguo.
Tampoco queda claro —el paper no lo especifica— qué se transmite de vuelta. Probablemente, si el follower quedó más actualizado, le envíe también el ZXID nuevo, aunque no resulte tan necesario porque en una lectura no se escribió nada: quizás simplemente para que el cliente esté lo más actualizado posible.
Y si el cliente debe cambiar de follower, la situación se repite. Los clientes suelen permanecer asociados a uno, por otra cuestión que veremos más adelante. Pero si debe leer de otro y ese está desactualizado, el paper (§4.4) indica qué ocurre: al conectarse, el servidor nuevo compara el último ZXID del cliente contra el suyo, y si el cliente tiene una vista más reciente, no restablece la sesión hasta haberse puesto al día. El follower espera, entonces, y el cliente con él. La verificación ocurre al establecer la sesión con un servidor, no en cada lectura. Y el cliente también puede desconectarse y probar con uno distinto, con la garantía de encontrar alguno suficientemente actualizado: un cliente solo llega a ver cambios que ya fueron replicados en una mayoría, de modo que alguna máquina de esa mayoría los tiene.
Pero lo que importa es esto: todas las condiciones —principalmente la del FIFO client order— se cumplen simplemente haciendo que el índice del log no sea un dato oscuro, interno al algoritmo, sino algo visible para el cliente desde afuera. Es una solución ingeniosa, y constituye una variación importante respecto de lo que venimos viendo de Raft.