1. Motivación de Dynamo
En esta sección
Carrito de compras y caída del writer
El sistema que vamos a estudiar es Dynamo: el original, el paper de Amazon de 2007. Conviene aclarar de entrada que en principio no tiene nada que ver con DynamoDB, que es el nombre más conocido. DynamoDB es, sobre todo, un nombre comercial: el paper de Dynamo fue uno de los más famosos de sistemas distribuidos —en esa época salieron varios seguidos, los de Google, el de MapReduce, el de Google File System, y este fue uno de los poquísimos de Amazon— y tuvo tanto éxito que después le pusieron ese nombre a un producto, una base de datos en la nube que no tiene casi nada que ver con el paper. La comparación entre los dos igual sirve, porque son dos maneras bien diferentes de hacer una base de datos.
La motivación de Amazon para construir lo que es, en esencia, una base de datos distribuida era muy concreta: necesitaban un storage para el carrito de compras, para las sesiones de los usuarios y para el catálogo de productos. Esto fue en 2007, con lo cual ya tenían un volumen importante de todo. Si se caía la base del carrito, lo que perdían se medía en millones, porque facturaban a una escala enorme.
Así que lo importante era altísima disponibilidad y latencia predecible. El segundo requisito no es evidente y merece atención: una latencia muy errática es casi tan problemática como un sistema que no tiene alta disponibilidad, porque se llenan las colas. Con mucho throughput y sin una latencia baja y predecible, el sistema se satura. Tenía que ser rápido y estable, con variaciones pequeñas.
La forma que tanto Amazon como el resto de la industria usaba para guardar los datos era una base relacional. ¿Y cómo se distribuye una relacional? Vale como repaso. La típica es replicación con lo que se suele llamar un writer y unos readers: una variación de primary y secondary. A favor tiene que es fácil de implementar. Se escribe siempre en el writer, que les transmite todas las modificaciones a los readers; las lecturas, que se supone que son más frecuentes que las escrituras, se sirven desde abajo.
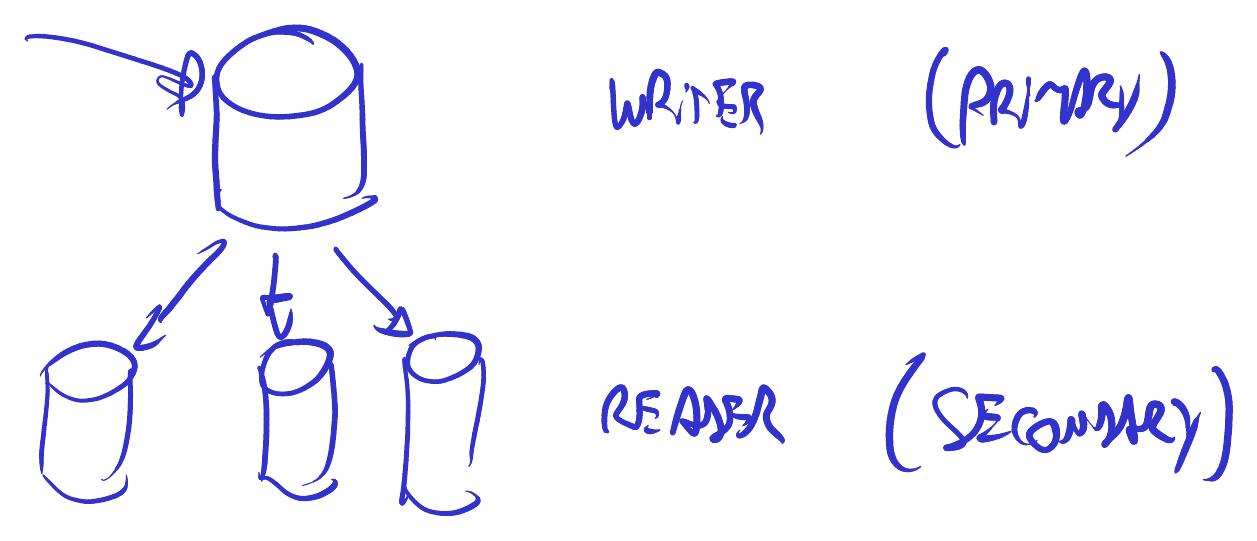
El esquema tiene varios problemas, y el principal es el writer: cuando falla, el impacto es grande. Se puede restaurar promoviendo un reader a writer, pero no con la velocidad que querían en Amazon: entre que se detecta la falla, se promueve a alguien y se reconecta todo pasan varios minutos con el sistema caído.
Y además el writer es difícil de escalar en sí mismo. Si aumenta la cantidad de escrituras —y este es justamente el caso, porque el carrito de compras se lee mucho pero también se escribe mucho—, a lo sumo se le puede poner una máquina más grande. Se puede particionar en shards, pero el problema persiste.
Lo importante de todo esto es lo siguiente: si falla el writer, se dejan de aceptar escrituras. Y eso era exactamente lo que querían evitar.
Disponibilidad de escritura: CAP y split brain
El objetivo de diseño clave conviene anotarlo tal como ellos lo anotaron, porque de ahí se desprende todo lo demás: siempre aceptar escrituras, y aceptarlas por encima de la consistencia. Con esa jerarquía explícita: importa más que la escritura quede registrada que el hecho de que el sistema muestre siempre algo consistente. Hoy eso no resulta tan extraño, pero en 2007 el universo entero eran las relacionales, y las relacionales son consistentes: uno hace una transacción, después la lee, y la transacción está ahí. De ese objetivo surgen los sistemas eventualmente consistentes.
Este paper, junto con algunos otros pero principalmente este, es además el que populariza el teorema CAP. Es un nombre ampliamente conocido, y en otras materias se trata con más detalle. No vamos a verlo en detalle aquí, porque el teorema no es tan interesante: no dice nada tan sorprendente, y su contenido se deduce intuitivamente por otro lado. Vale tenerlo presente porque en su momento estuvo enormemente de moda y porque ubica bien la decisión que tomó Dynamo.
Se dibuja como un triángulo con tres vértices. La C quiere decir consistencia, la A availability y la P partition tolerance, tolerancia a particiones. Lo que afirma es que se pueden tener dos de las tres, y nunca las tres al mismo tiempo. Enunciado así parece fácil; entenderlo de verdad es bastante más difícil.
El propio Eric Brewer matizó después esa formulación. En CAP Twelve Years Later: How the “Rules” Have Changed (IEEE Computer, febrero de 2012) escribe que el enunciado de “dos de tres” siempre fue engañoso, por tres razones: las particiones son raras, y mientras no hay partición no hay motivo para resignar ni C ni A; la elección entre C y A puede tomarse muchas veces dentro del mismo sistema y con granularidad muy fina, incluso según la operación o el dato; y las tres propiedades son continuas antes que binarias. La lectura que sigue —que P no se negocia y que la disyuntiva aparece cuando hay una partición— es justamente la versión corregida.
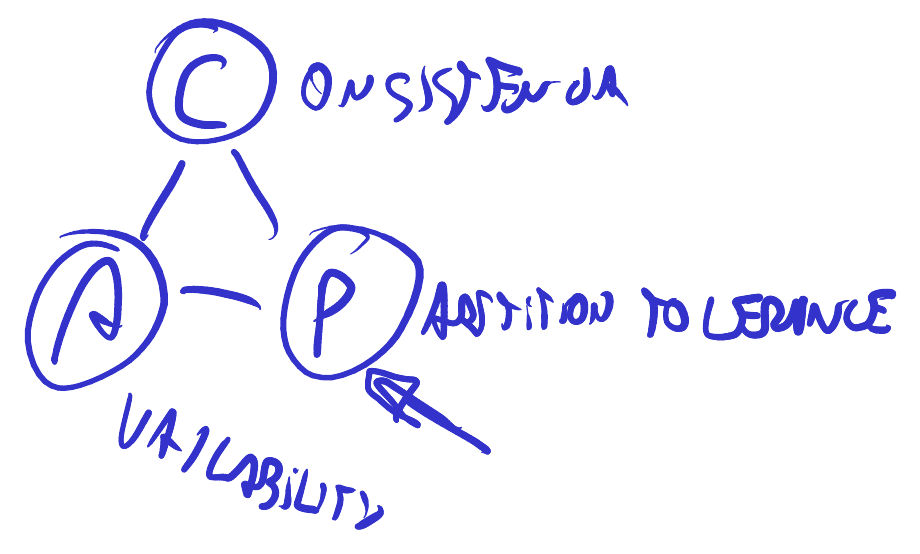
La clave para entenderlo es una sola: P no es negociable. La tolerancia a particiones siempre tiene que estar, porque las redes se desconectan y las particiones van a ocurrir lo queramos o no. Decir que un sistema no es tolerante a particiones tiene sentido en un solo caso: una base de datos común, corriendo en una única máquina, donde no hay ninguna red de por medio y no hay nada que se pueda partir. Ahí sí las cosas pueden ser fuertemente consistentes y estar siempre disponibles al mismo tiempo. El problema aparece en cuanto hay una red.
En una red, donde sí o sí hay que tolerar que ocurran particiones y que el sistema siga funcionando pese a ellas, hay que elegir: o el resultado es siempre consistente —linealizable, en el sentido preciso con el que trabajamos ese término— o el sistema es siempre disponible. Pensada desde Raft, la disyuntiva resulta muy clara. Para que un sistema sea fuertemente consistente, cuando aparece una partición hay una parte que va a tener que dejar de estar disponible, justamente para que la otra mitad pueda seguir siendo consistente; y después, cuando la red se restaura, se restaura también esa parte y el conjunto sigue siendo consistente.
Dynamo optó exactamente al revés, y ahí está lo interesante. Optó por estar siempre disponible: a cualquier nodo, independientemente de dónde haya caído la partición, siempre se lo puede leer y escribir. Lo que no va a tener, a cambio, es consistencia: el sistema no va a ser linealizable.
El otro término que este paper populariza es NoSQL. Las bases NoSQL son también un nombre conocido —Cassandra, DynamoDB, la más conocida de todas— y también un término con algo de marketing. Más que una definición, NoSQL es una antidefinición: definirlo consiste en partir de SQL y sacarle cosas, precisamente para que el sistema pueda ser distribuido. Se define por lo que le falta.
Las tres ideas clave que decidieron los ingenieros se pueden enumerar desde el principio. La primera es la consistencia eventual: el sistema definitivamente no es linealizable.
La segunda es que siempre acepta escrituras, y trae una consecuencia inesperada. Cuando hablábamos de Raft, y también de Google File System, el split brain era el escenario a evitar a toda costa, aquello contra lo cual se diseñaba el sistema entero. Aquí el sistema lo soporta, y merece subrayarse porque es muy poco habitual. El sistema se puede dividir en dos y las dos mitades siguen evolucionando cada una por su lado. Después tiene un mecanismo para reconciliarlas cuando se vuelven a juntar, y esa es la clave de toda esta clase: cómo hace para reconciliarse un sistema que se dividió.
La tercera está muy relacionada: el sistema permite escrituras conflictivas. Si un conjunto de nodos se parte por la mitad, se pueden seguir escribiendo cosas de un lado y del otro; inclusive se puede seguir escribiendo el mismo elemento, la misma row, en las dos mitades a la vez.
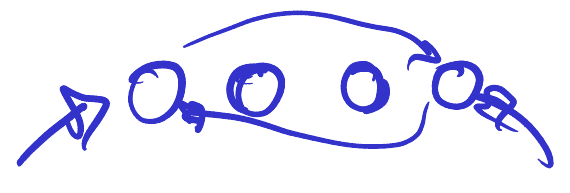
Después, cuando la red se restaura y las dos mitades vuelven a verse, hay una forma de que se pongan de acuerdo. No hay nada mágico en ello, conviene anticiparlo; pero alcanza para que el sistema siga funcionando de manera coherente.
Renuncia a SQL y transacciones
¿A costa de qué se consigue todo esto? El primer costo es importante: Dynamo no tiene SQL; literalmente, no ofrece ese lenguaje.
Analizado con atención, SQL es un lenguaje singular. Para programación de propósito general hay miles de lenguajes: a lo largo de una carrera de informática uno trabaja con al menos cinco. Pero para operar con bases de datos prácticamente no hay ningún otro: SQL desplazó a todos los demás y quedó como el lenguaje por excelencia. ¿Por qué?
Debe haber un conjunto de razones, pero la que importa aquí es la versatilidad. El modelo relacional combinado con SQL es enormemente versátil: permite formular prácticamente cualquier cosa, incluso consultas poco razonables. Una consulta extraña quizás se ejecute con mucha lentitud, pero al menos se puede plantear: el lenguaje tiene el poder expresivo para formular cualquier consulta extraña dentro de su modelo relacional.
Los ingenieros de Dynamo no sacaron SQL porque no les gustara, sino porque, si ni siquiera intentan implementar un lenguaje tan versátil, la implementación se les simplifica muchísimo. La consecuencia directa es un sistema mucho menos versátil para las queries, y esa es la consecuencia general de todas las bases no relacionales, no solo de Dynamo.
El punto es tan central que sirve como pregunta de entrevista. Cuando un candidato dice que usaría una base NoSQL y se le pregunta qué desventajas tiene, una de las cosas que tiene que contestar es justamente esta: que no tiene tanta versatilidad para hacer todas las queries que se le puedan llegar a ocurrir. Para meter una base no relacional y que después funcione, hay que tener el diseño mucho más pensado de antemano.
Se pierde la versatilidad de las queries, y se pierde algo más, una renuncia que al principio parece razonable y más adelante resulta muy costosa: no hay transacciones. En el sentido de ACID, el acrónimo que resultará familiar a quien haya cursado bases de datos: atomicidad, consistencia, isolation y durability.
La durability sí se concede, siempre: estamos haciendo una base de datos, y las cosas que se escriben y se confirman quedan durables. Eso no se negocia. Pero las otras tres se quedan muy cortas: no ofrece atomicidad, ni consistencia, ni isolation, por lo menos no al nivel de una relacional. Lo que sí ofrece son esas tres propiedades a nivel de cada ítem individual, mapeando cada ítem como si fuera una fila de una relacional. Las escrituras van a ser atómicas, sí, pero cada row independientemente de las demás.
Sobre esa base mínima se fue construyendo y mejorando. A DynamoDB se le terminó agregando una especie de transaccionalidad, deficiente con respecto a la de SQL pero transaccionalidad al fin. Y Spanner, la base de Google, también tiene transacciones, de otra forma, aunque con sus propias desventajas frente a una relacional pura. Lo que pasa es que la gran desventaja de la relacional pura es la que ya dijimos: es difícil de distribuir. Si se le saca SQL y se le sacan las transacciones, queda algo mucho más simple de distribuir. Esa es exactamente la razón por la cual inventaron Dynamo.
Ahí está la revolución, si se quiere. Es bastante osado decir “voy a hacer una base de datos, pero que no sea SQL y que no tenga transacciones” en un momento en el que todas las bases lo tenían.
Hay un científico muy conocido del mundo de las bases de datos, Michael Stonebraker, que ha sido un crítico severo de todo el movimiento NoSQL; junto con David DeWitt firmó un artículo diciendo que MapReduce es un enorme retroceso en el avance de las bases de datos, y vale nombrarlo porque la explicación que acabamos de dar sale de ahí: la receta para hacer una base NoSQL es tomar una SQL y sacarle las partes difíciles de implementar y de distribuir, a costa de quitarle features que suelen ser utilísimas.
El artículo es MapReduce: A Major Step Backwards, publicado en el blog The Database Column en enero de 2008.
Dicho de otra forma: al no tener SQL ni transacciones, muchas de las dificultades se trasladan al programador, que tiene que ser más habilidoso y resolver sus problemas sin esas dos features tan importantes.