4. Happens-before y relojes de Lamport
En esta sección
Relación happens-before
A esa condición —que una cosa ocurra antes que otra— Lamport le puso nombre: la llama happens-before. Y la clave para resolver todo este problema está justamente ahí, en definir con precisión qué significa ese “antes”, en términos más matemáticos que los que veníamos manejando.
La definición se apoya en un diagrama de tres procesos, que en el paper es la figura 1. Lamport los llama P, Q y R, y conviene adoptar esos nombres; el único detalle a tener en cuenta es que ahí el tiempo corre hacia arriba, al revés de como lo dibujamos nosotros. Sobre cada línea hay eventos marcados, y entre las líneas hay mensajes que las cruzan.
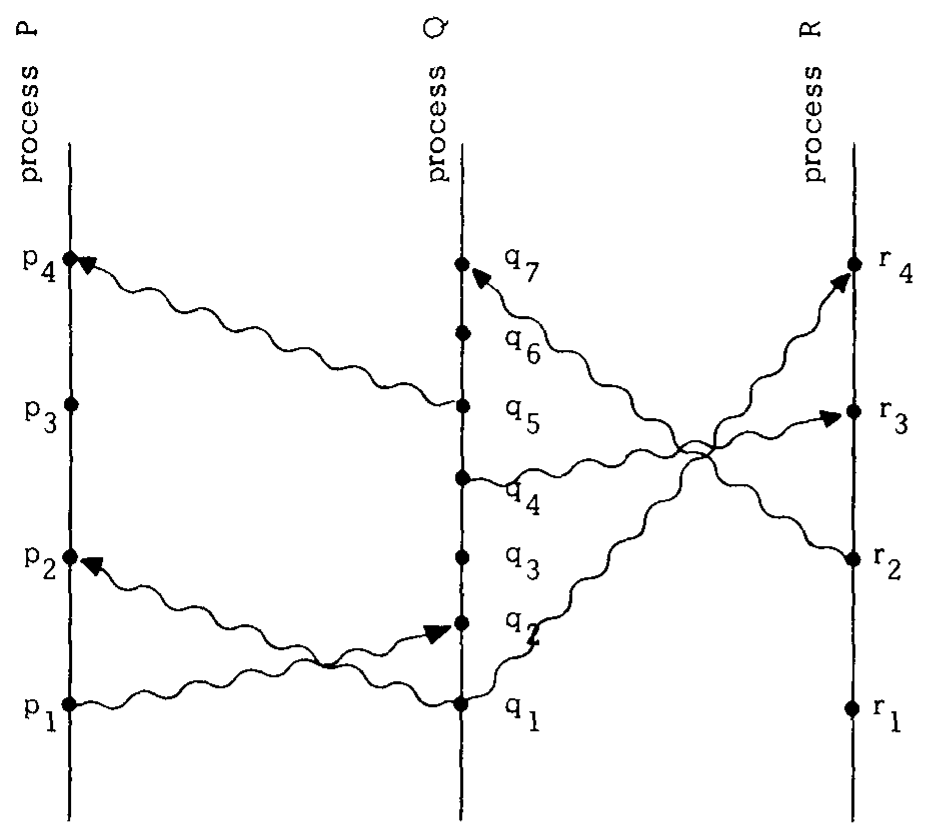
Sobre ese dibujo, la relación queda definida con tres condiciones, y el símbolo que la denota es una flecha. La primera es dentro de un proceso: si dos eventos ocurren en la misma máquina y uno viene antes que el otro, el primero precede al segundo. P1 ocurre antes que P2. Eso no es muy debatible: con un solo proceso, sin threads ni nada intercalado adentro —por ejemplo se suman dos valores y después se multiplican otros dos—, es obvio que uno ocurrió después del otro, y la razón es que la máquina es secuencial.
Lo que Lamport agrega es la segunda condición, y es la interesante: si un mensaje se envía desde una máquina y lo recibe otra, el evento de enviar precede al de recibir. Si una máquina recibió un mensaje, es porque necesariamente la original lo tiene que haber enviado antes; no hay otra manera. Esa es la clave que conecta el antes y el después entre dos máquinas separadas.
La tercera es transitividad, y también es bastante obvia: si A ocurre antes que B y B antes que C, entonces A ocurre antes que C.
Con esas tres reglas podemos armar un grafo, un camino: este evento ocurrió antes que este otro, que a su vez antes que aquel. Se sigue la cadena saltando de una línea a otra cada vez que hay un mensaje, y encadenando dentro de cada línea cuando los eventos son del mismo proceso.
Pero entonces aparece la pregunta que abre el concepto central. ¿Qué pasa entre dos eventos de procesos distintos entre los cuales no se puede armar ningún camino? Ahí, dice Lamport, no se puede establecer una relación de happens-before. Y de esos dos eventos se dice que son concurrentes.
Aquí está el punto importante, porque es donde la palabra engaña. La concurrencia, en los términos en que la define Lamport para sistemas distribuidos, no quiere decir que las dos cosas ocurran al mismo tiempo. Quiere decir que no se puede armar el camino de causalidades entre una y otra. Happens-before no tiene nada que ver con el tiempo real.
Lo que sí tiene es una lectura causal, y es la que le da todo el sentido. Si un evento A ocurre antes que un evento B, entonces B pudo haber sido influenciado por A. Ese pudo hay que conservarlo tal cual: no se afirma que lo haya sido, sino que existe una relación que lo vuelve posible.
Y el caso contrario es el que nos interesa. Tomemos un evento de P y uno de R que son concurrentes. Ese evento de R no puede haber tenido nada que ver con el de P: uno ocurrió en un lugar del mundo y el otro en otro. No puede haber sido influenciado ni motivado por él, ni haber intercambiado información, porque no hay forma de encontrar una causalidad ahí.
Cuando no se puede armar ninguno de los caminos posibles, hay dos situaciones distintas. La primera es la del evento que quedó suelto, aislado, sin relación con nada. La segunda es quizás más interesante: un evento de un proceso que sí se comunicó con otros, pero cuyo mensaje llegó recién después. Esa comunicación existió, pero no tuvo nada que ver con el evento que estamos comparando, porque llegó tarde para influirlo. Y de nuevo: no tiene nada que ver con el tiempo físico de los relojes, lo que importa es la causalidad.
El planteo tiene algo de filosófico. Lo importante va a ser poder definir cuándo una cosa ocurre antes que otra. Pero —y este es el giro que vamos a necesitar cuando volvamos a Dynamo— casi más importante que esa definición es la implicancia contraria: cuándo dos cosas no tienen relación entre sí. Porque si no la tienen y las tenemos que reconciliar, ahí vamos a tener un problema.
Relojes lógicos
Todo lo anterior no tiene nada de disparatado: es apenas una manera cuidadosa de decir qué significa que una cosa haya ocurrido antes que otra cuando no hay ningún reloj común en el que apoyarse. El invento propiamente dicho fue encontrar una forma de plasmar toda esa relación en números. A esos números los llamó relojes lógicos, y también se los suele llamar relojes de Lamport.
Un reloj lógico es, en espíritu, un reloj, pero en vez de contar segundos cuenta eventos: avanza con cada evento que ocurre en el sistema. Cada proceso tiene el suyo; si los procesos se llaman P, Q y R, sus relojes son C(P), C(Q) y C(R), y lo que guarda cada uno es un número entero que va creciendo a medida que en ese proceso pasan cosas.
La mecánica se apoya en tres reglas, y conviene tenerlas enunciadas antes de mirar ningún dibujo. La primera es la más simple: los eventos locales incrementan en uno el reloj del proceso donde ocurren. La segunda empieza a conectar procesos distintos: cuando se envía un mensaje, hay que adjuntarle el valor del reloj lógico del emisor. Si el reloj del que envía valía uno, por el cable viajan dos cosas, el mensaje y ese uno.
La tercera es la interesante, la que hace que todo funcione. El que recibe también tiene su propio reloj, y al recibir tiene que actualizarlo de manera tal que le quede por delante a las dos cosas que ya ocurrieron. La cuenta es un máximo entre dos candidatos: su propio contador más uno, que es el valor que le habría tocado a ese evento de recepción si no hubiera recibido nada; y el reloj que venía adjuntado en el mensaje, también más uno. Se toma el mayor. La razón de tomar el máximo, y no otra combinación, es que el reloj nunca puede retroceder.
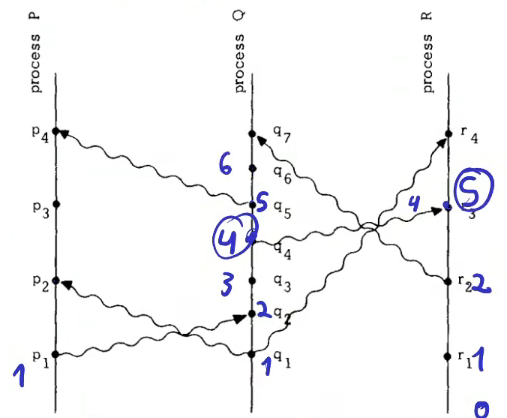
Con las tres reglas puestas, hace falta buscar un lugar del diagrama donde se note el efecto, porque en la mayoría de los eventos la tercera regla no cambia nada. Tomemos un proceso cuyo reloj arranca en cero. Ocurre un evento y pasa a uno. Ocurre otro y pasa a dos. Ahora hay que asignarle un valor al evento siguiente, que es de recepción: si no estuviera recibiendo nada le tocaría tres.
Pero hay que recorrer el camino del otro proceso antes de decidir. Allá había un uno; después el reloj se actualizó a dos, después a tres, después a cuatro. Y desde ese punto, con el reloj marcando cuatro, se envía el mensaje que estamos recibiendo, así que llega con el valor cuatro adjuntado. Si viniéramos solamente por el contador local le pondríamos tres, y tres no se le puede poner: queda más chico que el reloj que nos está llegando. Hay que ponerle un valor más grande que los dos candidatos, y ese valor es cinco.
Ahí está la clave, porque es exactamente lo que nos permite obtener la precedencia. Ese evento, al valer cinco, respeta una de las precedencias porque cinco es más grande que dos, el valor del evento que lo precede dentro de su propio proceso; y respeta la otra porque cinco es más grande que cuatro, el del evento que le mandó el mensaje. Funciona en los dos sentidos a la vez. El contrafáctico termina de demostrarlo: si usáramos el contador local y lo incrementáramos a tres, tendríamos un evento con reloj cuatro que le mandó algo a otro que quedó con tres, rompiendo justamente lo que estamos tratando de lograr.
El truco, en una línea: se adjunta al mensaje el valor que uno tiene, y el que recibe se actualiza de manera tal que los dos relojes queden consistentes entre sí.
Lo que queremos lograr tiene nombre. Lamport lo llama clock condition: si A ocurre antes que B, entonces el reloj de A tiene que ser menor que el de B. Menor estricto. Si los dos relojes son iguales, la condición no está diciendo nada.
Y eso es lo que terminó pasando en el ejemplo. Como el evento del otro proceso ocurrió antes que el de recepción, aquel tres tenía que ser un cinco, y entonces cuatro es menor que cinco y la condición se cumple; y cinco es mayor que dos, con lo cual también se cumple del otro lado. Lo mismo pasa en todos los demás eventos del diagrama: la condición se respeta en todos lados y funciona automáticamente. Lo único que hay que tener en cuenta es aplicar la fórmula cada vez que llega un mensaje.
En otro punto del diagrama la cosa viene al revés. Un proceso trae su contador local en cuatro; ocurre un evento y sube a cinco, ocurre otro y sube a seis, y en ese momento le llega un mensaje que viene de un reloj que estaba en dos. ¿Con qué valor queda ese evento de recepción? Con siete: el máximo entre seis más uno y dos más uno. Aquí gana el contador local, al revés que antes. La fórmula es la misma; lo que cambia es cuál de los dos candidatos resulta más grande.
Es así de simple. Pero tiene una sutileza.
Alcance de la clock condition
La sutileza tiene una razón precisa: la clock condition es mucho menos útil de lo que uno pensaría, porque se trata de una implicancia y no de un si y solo si. Todo el asunto sería muchísimo más útil si valiera en los dos sentidos. No vale.
El planteo concreto es este. Supongamos que alguien nos dice que el reloj del evento uno es menor que el del evento dos. ¿Qué podemos concluir? Hay dos cosas distintas que pueden estar pasando. Una es el caso feliz: E1 efectivamente ocurrió antes que E2, y por eso se respeta la clock condition. Pero tranquilamente puede estar pasando la otra, que E1 y E2 hayan sido concurrentes, que hayan ocurrido en paralelo, y que los números hayan quedado ordenados así de todos modos.
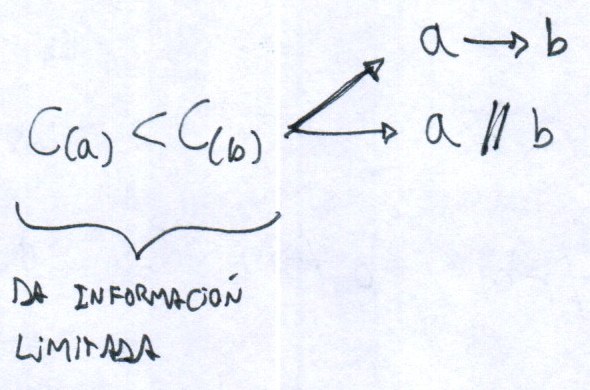
Esto se aprecia mirando un rato cualquiera de los diagramas de relojes lógicos: los números se repiten y muchas veces no dicen nada. En un mismo dibujo puede haber un evento con reloj tres y otro con reloj uno. Que tres sea más grande podría hacernos pensar que ocurrió después; sin embargo, entre esos dos eventos no hay ninguna relación de causalidad. Son concurrentes, y en ese caso el mecanismo simplemente no está diciendo nada.
De esa limitación se desprende una consecuencia práctica: los algoritmos que se arman con relojes de Lamport suelen ser complicados de entender. El paper mismo da un ejemplo y lo presenta como fácil; son palabras de Lamport. En la práctica termina siendo más difícil de entender que cualquier otra cosa, así que el ejemplo que vamos a ver no va a ser ese, sino otro bastante más accesible.
El paso siguiente en la modernización de los relojes son los vector clocks, los relojes vectoriales, y esos sí permiten el si y solo si. Son los que usa Dynamo, y son un poco más complicados que estos, pero tampoco tanto.
Orden total a partir de un orden parcial
Hay algo más que Lamport define en el paper, y que en rigor viene antes que todo lo anterior: la diferencia entre orden total y orden parcial. Son definiciones matemáticas, y quien haya cursado matemática discreta probablemente se las haya cruzado.
El orden total es el más natural para nosotros, que somos personas y no matemáticos. Los números naturales conforman un orden total: dos cualesquiera se pueden comparar y decir cuál es más grande, o si son iguales. Ahí están las dos piezas: un conjunto y una operación relacional para comparar sus elementos. Lo que hace que el orden sea total es que esa operación aplica a cualquier par ordenado de elementos: todos se comparan con todos. No todos los conjuntos de números cumplen con eso; los complejos, por caso, no.
El orden parcial, en cambio, es raro, porque no es tan común verlo en la vida cotidiana. Es un conjunto donde algunos pares se pueden comparar entre sí y para otros la operación directamente no está definida. Sería difícil encontrar un ejemplo si no fuera porque lo tenemos justo arriba: happens-before es exactamente un orden parcial sobre los eventos del sistema. Algunos eventos son claramente comparables, y otros no lo son porque ocurren de manera aislada.
Y de ahí viene el razonamiento importante. Teniendo los relojes, que son simplemente números enteros, y aun cuando happens-before sea un orden parcial en el que hay eventos no relacionados entre sí, con esos relojes se puede armar un orden total. Un orden total sintético: muchas de las relaciones que salen de esos números no van a tener sentido, pero el orden total como tal sí lo va a tener.
Se arma así: se toman todos los eventos del sistema, se los numera y se los ordena por reloj lógico. Con una salvedad que importa: cuando dos números empatan hay que desempatarlos de alguna forma, que puede ser perfectamente arbitraria. Lamport propone, por ejemplo, usar el process ID del proceso que emite. Con ese criterio ya queda armado un orden total.
Lo interesante es la propiedad que tiene. Supongamos que tomamos todos los eventos, los ponemos en un array y hacemos un sort por reloj lógico, y que entre dos de ellos, A y B, había una relación real de que A ocurrió antes que B. Al ordenarlos, A va a aparecer antes que B.
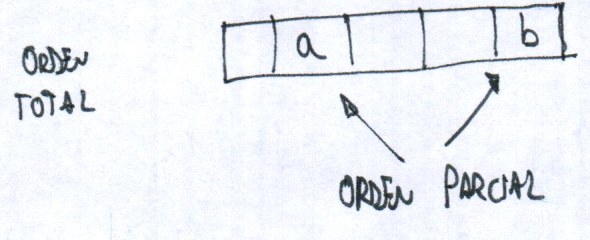
Ahí está el punto. Si bien vamos a tener un orden total en el que pudimos comparar todos con todos, y muchas de esas comparaciones no van a significar nada, ese orden total contiene a las cosas que sí tienen orden parcial y las deja en la posición correcta: lo que ocurrió antes aparece primero, y lo que ocurrió después, después.
Enunciado así resulta difícil de ver, y por eso hace falta un ejemplo.
Ejemplo: chat distribuido
El ejemplo no va a ser el del paper, que no es el más amable para empezar, sino otro mucho más fácil: un chat room distribuido. Algo del estilo de los antiguos canales de IRC, aunque en el IRC había un servidor en el medio; mejor todavía, imaginemos una especie de WhatsApp donde no hay servidor central y cada participante le tiene que mandar sus mensajes a todo el mundo. La implementación trivial es la que a cualquiera se le ocurre primero: mostrar los mensajes en la pantalla a medida que van llegando, uno abajo del otro. Con esa implementación puede ocurrir lo siguiente.
Supongamos tres personas, A, B y C. A escribe “¿Quién viene a comer?”, que llamamos M1. B contesta “Yo voy”, que es M2. Y C, sin relación con lo anterior, escribe “Qué calor”, que es M3. Entre los dos primeros hay una relación lógica evidente: B le está respondiendo a A, con lo cual el mensaje de A ocurre antes que el de B en el sentido preciso de la relación de precedencia. El de C, en cambio, es concurrente con los otros dos: dice algo que no tiene nada que ver con la conversación. Es el que no estaba prestando atención al chat.
Lo que cada participante manda junto con el texto es su reloj de Lamport concatenado con el identificador del proceso. Anotamos ese par como (1, A), que quiere decir el reloj uno del proceso A. La segunda clave está por la razón que ya conocemos: los relojes van a empatar, y cuando empaten hace falta algún criterio para desempatar.
Los mensajes pueden llegar de maneras muy distintas. A le manda su pregunta a B y también a C, pero la red se comporta de forma irregular y a C le llega con mucho retraso. C manda lo suyo, B manda lo suyo, y cada mensaje hace su propio camino, de modo que a cada destinatario le llega el conjunto en un orden distinto. A A le llegaron M1, M2 y M3, en ese orden, que respeta la única precedencia que había. A B le llegaron M1, M3 y M2, y eso sigue estando bien, porque la pregunta le llegó antes que la respuesta; aunque en su caso era obvio de entrada, porque si B está respondiendo es porque leyó el mensaje antes de contestar. Donde la situación se invierte de verdad es en C: ahí los dos mensajes que sí estaban relacionados quedaron al revés.
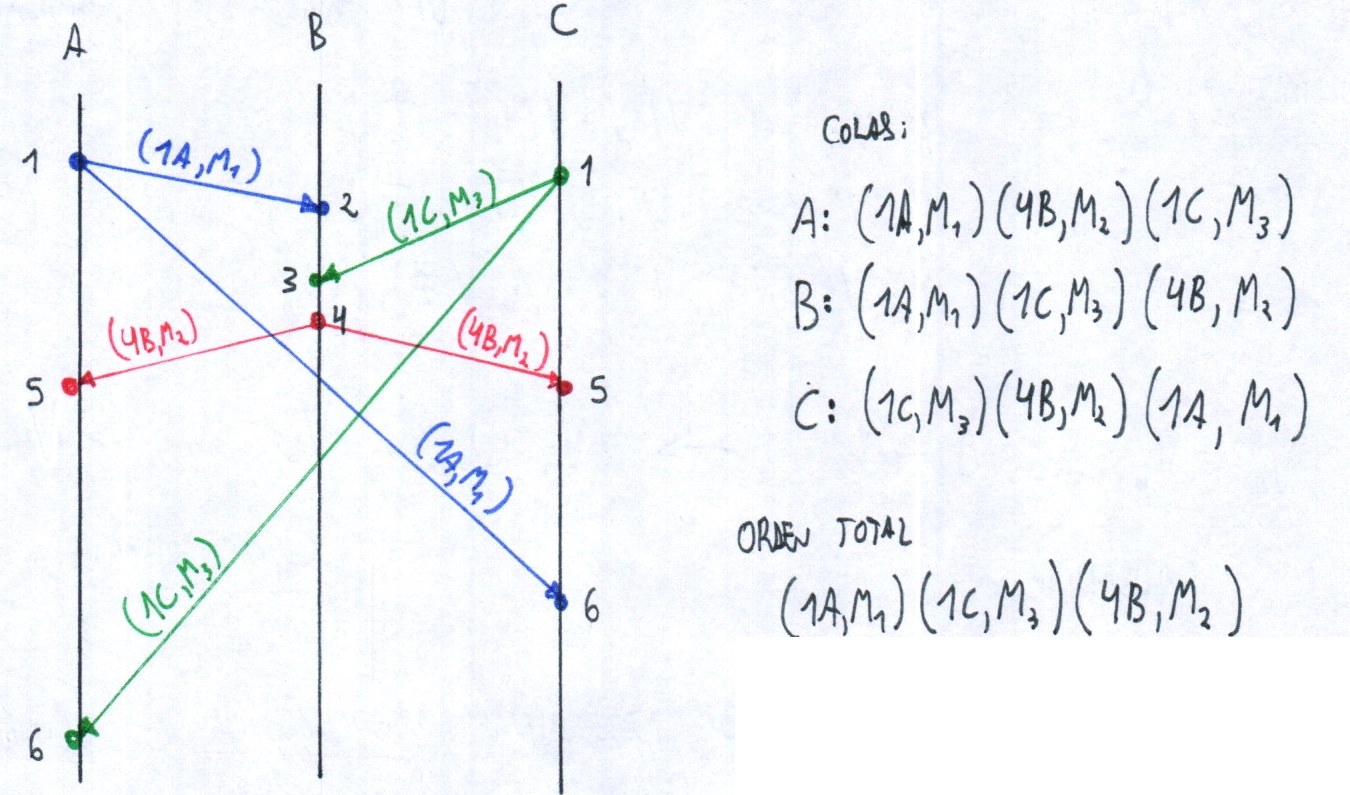
Lo que ve C, si su programa hace lo trivial, es incoherente: en su pantalla aparece primero “qué calor”, después “yo voy” y recién al final “¿quién viene a comer?”. La respuesta antes que la pregunta, un diálogo que no tiene ningún sentido.
El truco consiste en usar los relojes para colocar cada mensaje que llega en la posición que le corresponde dentro del historial, en lugar de agregarlo siempre al final. Si tomamos los tres mensajes y los ordenamos por ese par, el resultado va a ser el mismo para los tres participantes, porque son los mismos tres mensajes; lo único que cambiaba era el orden de llegada, y el orden de llegada dejó de importar. Queda (1, A), (1, C) y (4, B), que es M1, M3 y M2, y con eso todos ven el mismo historial.
Mirando los números cabe una duda concreta: si todos los mensajes salieron con reloj uno, ¿cómo se sabe quién mandó primero? El punto está en que esos números no son un valor fijo que cada mensaje lleva pegado desde el principio, sino relojes que se van actualizando. Uno salió con uno y al llegar le pusieron dos; otro salió también con uno y al llegar le tuvieron que poner tres; después vino un cuatro y después un cinco. Los relojes no aumentan por su cuenta: que al final aparezca esa precedencia entre los números es resultado de haber aplicado la regla en cada envío y en cada recepción.
¿Por qué funciona? Porque inventamos un orden total. No había un orden total sobre esos tres mensajes y nosotros se lo impusimos; por eso todo el mundo termina viendo lo mismo. Pero además, como lo construimos con relojes de Lamport y no con cualquier criterio arbitrario, dentro de ese orden total la relación verdadera queda respetada: A aparece necesariamente primero y B después, aunque C se haya metido en el medio.
Falta lo más importante, que es cómo se garantiza eso último. Entre la pregunta y la respuesta sí hay una relación de precedencia, y esa relación se sostiene sobre una cadena de mensajes que efectivamente se enviaron. El tercero, el que dice “qué calor”, no tiene nada que ver con esa cadena, y por eso el resultado final podría haber sido ABC, que es el que nos quedó, pero igual de bien podría haber sido CAB o ACB. Los tres son órdenes válidos, porque C ocurrió de manera concurrente con los otros dos: llega con el número que le corresponda sin alterar el resultado. Lo que importa es que la cadena se complete, que la pregunta le llegue al otro y que cuando el otro responde su número sea más grande. Eslabón por eslabón, cada número tiene que ser más chico que el que le sigue.
Si preservamos esos números, C puede ir a cualquier lado sin que eso rompa nada. Lo que importa es que las cosas correlacionadas entre sí lleguen en orden, y están correlacionadas porque entre ellas hubo un intercambio de información: A le mandó información a B, B la vio y le respondió, y eso es lo que se traslada a la precedencia de los números. Lo que no intercambió información con nadie puede haber llegado en cualquier orden sin consecuencias.
Así que a C le pueden llegar los mensajes en cualquier orden sin que eso lo afecte. Si los ordenamos de forma determinista, primero por el número y después por la letra, los tres van a ver el mismo chat, y dentro de ese chat C puede aparecer en cualquier lugar. Lo único que importa es que A aparezca antes que B. Conviene pensarlo con calma, porque este es un ejemplo fácil, y es fácil justamente porque es difícil encontrar ejemplos fáciles con relojes de Lamport.
El que da Lamport en el paper es la prueba: consiste en construir un lock distribuido usando estos relojes, y, honestamente, uno puede dedicarle un buen rato con ese ejemplo y no entenderlo. De ahí la preferencia por el chat. Y ya que estamos, un comentario al pasar: Lamport es también el autor de Paxos, un algoritmo con fama de incomprensible, a pesar de que él insiste en que es fácil. En realidad sí se entiende; lo que pasa es que es difícil y que está subespecificado: quedan muchas cosas en duda que uno tiene que resolver por su cuenta a la hora de implementarlo. Paxos, dicho sea de paso, no usa estos relojes.
El ejemplo del paper es el problema de la exclusión mutua —varios procesos que comparten un único recurso que solo uno puede usar por vez—, y Lamport lo resuelve con un algoritmo de cinco reglas y una cola de pedidos en cada proceso. La queja de que lo presenta como fácil tiene respaldo textual: el resumen anuncia “un método simple para resolver problemas de sincronización”, y al llegar al algoritmo escribe que, teniendo el orden total, “encontrar una solución se vuelve un ejercicio directo”; unas líneas más abajo, sin embargo, advierte que “es importante darse cuenta de que este es un problema no trivial”. El desempate por identificador de proceso usado en la subsección anterior también es del paper: para romper empates, dice, se usa “cualquier ordenamiento total arbitrario de los procesos”.
Llegados a este punto cabe una objeción razonable: que el ejemplo parezca puramente didáctico. La sospecha sería que el sistema no puede enterarse solo de quién mandó primero cada mensaje, y que eso tendría que informarse por código o por donde fuera. Pero la información está, y viaja precisamente adentro de cada mensaje. Si cada uno adjunta su propio reloj lógico a lo que emite, y del otro lado se ordenan los mensajes por ese reloj en vez de por orden de recepción, el esquema funciona.
Lo que sí hay que conceder es que un ejemplo así es raro en la práctica. En general hay un servidor centralizado que se ocupa de ordenar los mensajes y mandárselos a todo el mundo ya ordenados: los servidores de chat suelen funcionar con un secuenciador centralizado antes que con relojes de Lamport. Pero si lo que se quiere es un chat completamente distribuido, esta es una buena forma de lograr que todos vean los mensajes en el mismo orden y que ninguno vea una versión diferente del canal.