5. Arquitectura, localidad y tolerancia a fallas
En esta sección
Ya sabemos qué hace un mapper por dentro y qué hace un reducer. ¿Cómo es la arquitectura de todo eso? Quién reparte el trabajo, cómo se entera de que un nodo falló y por dónde viajan los datos.
Coordinador, workers y heartbeats
La figura 1 del paper es el esquema de ejecución completo. Tiene detalles que no hacen falta para lo esencial —el fork del programa del usuario, por ejemplo—. Lo importante es que existe un coordinador, un proceso que coordina todo; el paper lo llama master. Para lanzar un trabajo hay que hablar con él, y es él el que le da trabajo a todo el mundo.
Ahora, la forma de repartir el trabajo que vamos a adoptar es al revés de lo que uno esperaría. Del otro lado hay muchos workers genéricos, que de alguna manera reciben el código del map y el del reduce. Y esos workers conocen al coordinador, no el coordinador a los workers.
La razón es que así es más fácil. La alternativa sería pasarle al coordinador una lista de workers, y esa lista es dinámica: los workers se agregan y se bajan, así que habría que mantenerla al día. En lugar de eso, el coordinador se queda quieto y el trabajo de encontrarlo queda del otro lado: cuando un worker se inicia, se le pasa la dirección del coordinador y el worker le pregunta “¿hay trabajo para mí?”.
Del lado del coordinador, lo primero que hace cuando recibe un job es armarse un plan de trabajo con los parámetros que ya conocemos: con tres mappers y dos reducers, una primera fase con M1, M2 y M3 —cada uno con su input— y una segunda con R1 y R2.
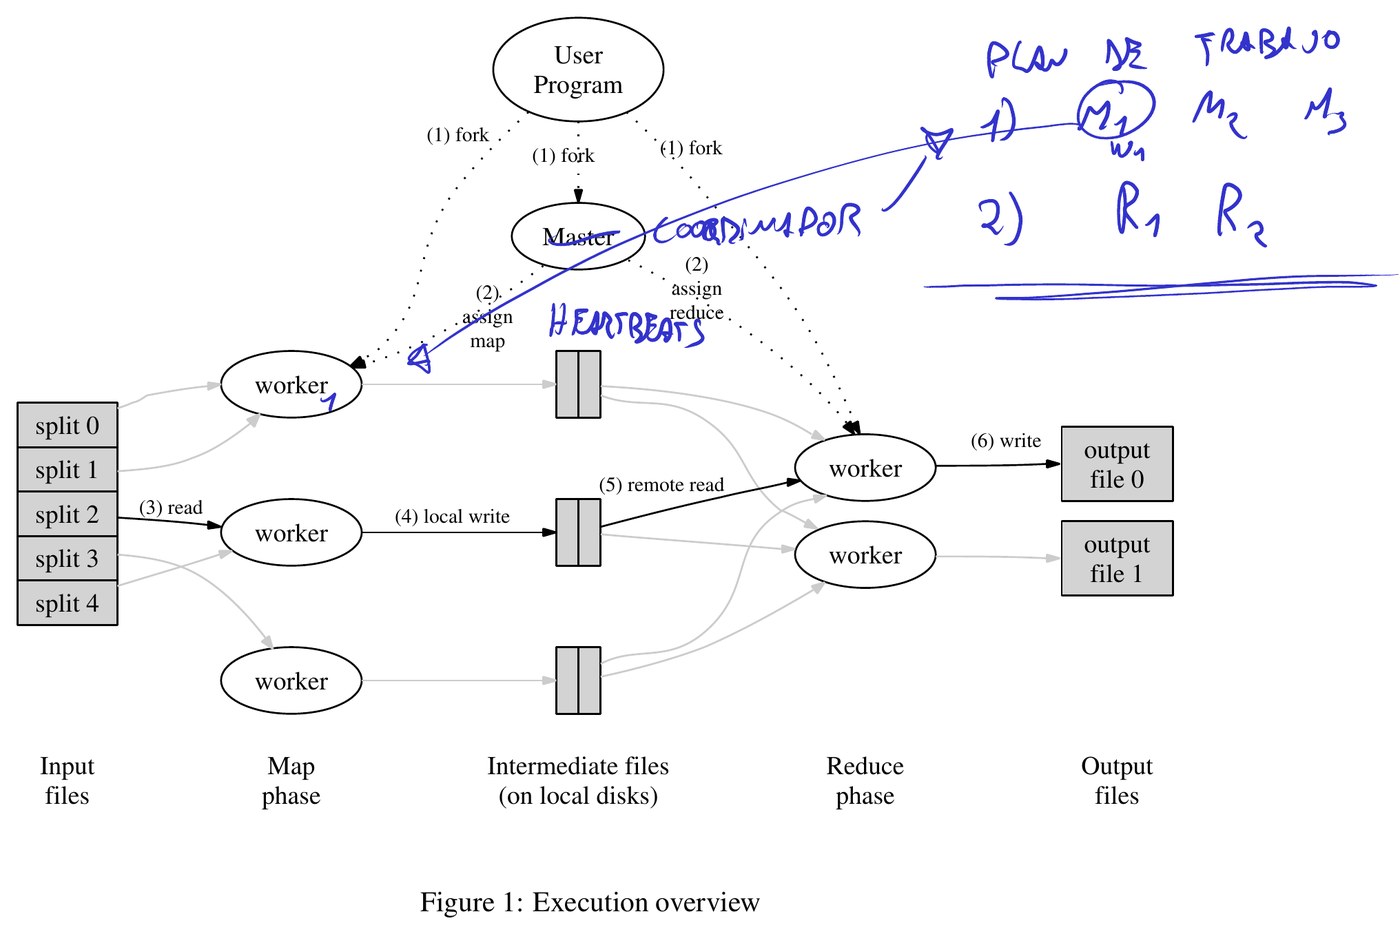
Con ese plan delante podemos contestar algo pendiente: por qué no se puede empezar con los reducers antes de que terminen todos los mappers. Un reducer tiene que agregar todas las apariciones de la misma clave: todas las K1 que emitieron todos los mappers. Si lo lanzamos antes de que M3 termine, va a considerar solamente las claves de los dos primeros y se le van a perder las del tercero. Es un problema general de MapReduce: hay que terminar todos los mappers para saber todas las claves que aparecieron.
Tiene, de todos modos, una ventaja, porque simplifica el coordinador: tiene que hacer dos fases y nada más. En la primera, repartir el trabajo de M1, M2 y M3; en la segunda, cuando esas terminaron, el de R1 y R2.
La mecánica de la asignación es directa. Un worker pregunta si hay trabajo, y el coordinador le contesta “sí, vas a ser el número uno”, y tiene que recordar que ese trabajo lo está haciendo el worker 1. Después necesita algún mecanismo para ver que ese worker está progresando: que de vez en cuando le envíe una señal de que todo está bien. Esas señales se llaman heartbeats, y lo que el worker comunica con cada una es que sigue progresando con su tarea y que no debe darse por caído.
De ahí sale la primera pieza de la tolerancia a fallas. Si el worker al que le asignamos M1 deja de enviar heartbeats —falló, agotó su memoria—, el coordinador puede asignarle ese M1 a otro, y el trabajo sigue avanzando.
El sistema del paper resuelve ambos puntos en la dirección contraria, y la elección de arriba es una decisión de diseño legítima pero distinta. En §3.1 dice que el master elige workers ociosos y le asigna a cada uno una tarea: la iniciativa es del master, que por lo tanto sí conoce a sus workers. Y en §3.3 dice que el master le hace ping a cada worker periódicamente, y que si no recibe respuesta lo marca como fallado; o sea que el latido va del coordinador al worker. Las dos variantes resuelven lo mismo, y el argumento a favor de la que adoptamos se sostiene: si los workers buscan al coordinador, la lista no hay que mantenerla en ningún lado. Es la diferencia entre pull y push.
Localidad de datos: co-locación con GFS
El problema principal de todo este sistema, según el paper, era la red: mover datos.
Ahí hay dos partes distintas. Una es el shuffle, donde no hay alternativa: es inevitable que muchas máquinas le envíen información a muchas otras. La otra es aquella en que los mappers reciben su input y los reducers emiten su output, y esa sí se podía optimizar, porque no tiene por qué viajar.
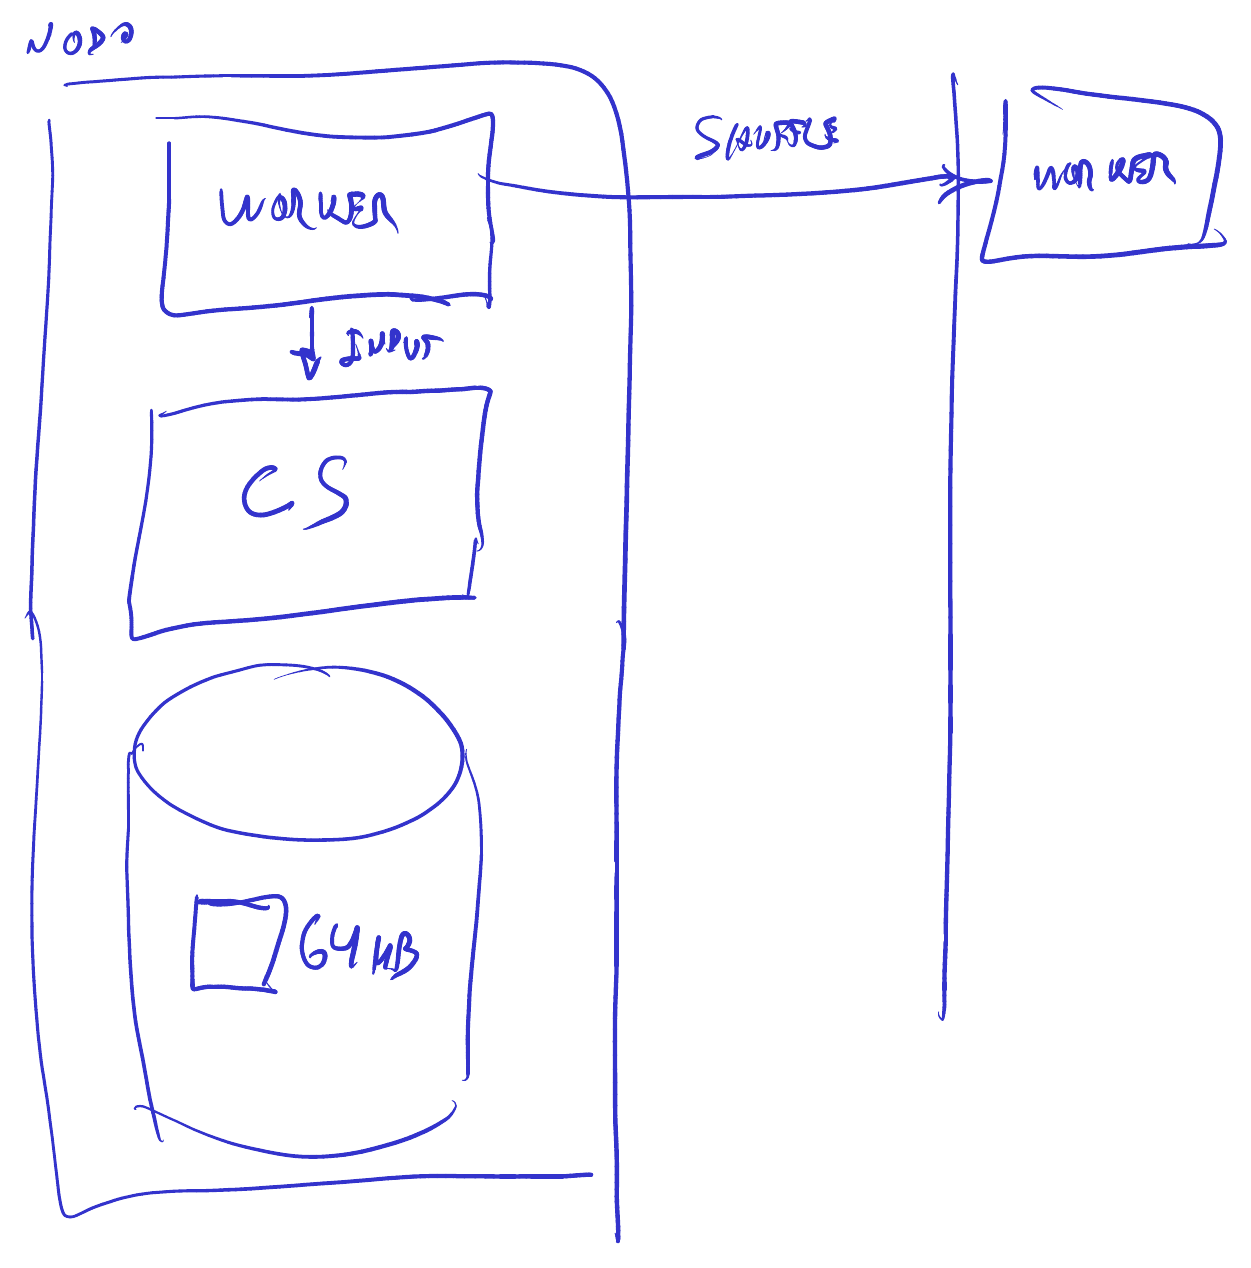
Lo que hicieron obliga a adelantar algo del Google File System, que vamos a estudiar más adelante. MapReduce corría en nodos que tenían un worker pero además un chunk server, que es un concepto de GFS: en los mismos nodos convivían los servidores de los dos sistemas. Un chunk server usa los discos locales de la máquina para guardar pedazos de archivos gigantes, de 64 MB cada uno; GFS se encarga de que todos esos pedazos repartidos entre muchas máquinas parezcan un único archivo gigantesco. Ese número explica hacia atrás el ejemplo de los mil mappers: mil chunks de 64 MB son un archivo de 64 GB, así que la cantidad de mappers no es un número elegido a mano sino una consecuencia de en cuántos pedazos quedó partido el input.
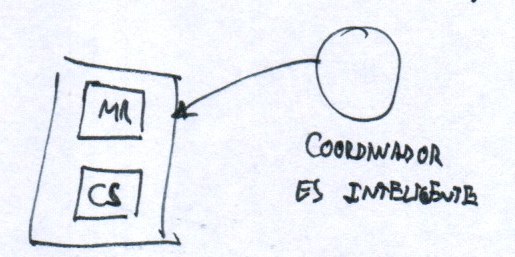
Lo que hicieron fue ingenioso: que esos chunks funcionen directamente como los inputs de los mappers. Cuando el coordinador tiene que asignarle trabajo a una máquina, en vez de darle un map cualquiera mira cuáles de los chunks que ya tiene en su disco local le hacen falta a algún mapper, toma uno de esos y se lo asigna. Así, en lugar de ir por la red a buscarlo, la lectura del input es una lectura local de disco.
Esto es best effort: se trata de reducir al máximo la necesidad de ir a otra máquina a buscar un chunk, no de garantizar que nunca haga falta.
§3.4, Locality, agrega dos precisiones que explican por qué este best effort acierta tan seguido. La primera: GFS mantiene de cada bloque varias copias, típicamente tres, en máquinas distintas, así que el coordinador no tiene un único candidato donde el chunk es local, tiene tres. La segunda: el best effort tiene dos niveles: si no consigue programar la tarea en una máquina que tenga una réplica, intenta programarla cerca de una — por ejemplo, en una máquina conectada al mismo switch. El resultado que reporta el paper es contundente: en operaciones grandes sobre una fracción significativa del clúster, la mayor parte del input se lee localmente y no consume ancho de banda de red.
Del lado del reducer se hace lo mismo: en vez de escribir el output en un chunk server remoto, se elige el local, y con eso se evita que el output se disperse por la red. Por eso el paper dice que los inputs y los outputs los toma del Google File System.
El shuffle, en cambio, quedó afuera de esta optimización y se hace con comunicación directa entre nodos: ahí no aparece GFS, un worker se comunica con otro y se intercambian los archivos. La razón es que el beneficio de guardar esos archivos intermedios en GFS era escaso, porque de todos modos había que enviarlos por la red.
Esta última optimización es una de las combinaciones más interesantes que vamos a ver, y vale volver sobre ella cuando estudiemos el Google File System. Lo que hicieron fue combinar los dos primeros sistemas de la materia —el de cómputo y el de storage— de manera tal que cada uno le resolviera al otro su problema más caro.
Reintentos y determinismo
Y ahora sí, la tolerancia a fallas. La de MapReduce es la más simple de todas las que vamos a ver, y no es un accidente sino la consecuencia de una decisión de diseño que atraviesa el sistema entero.
La decisión es esta: todo está diseñado de manera tal que cada unidad de trabajo —mappers y reducers— se pueda ejecutar más de una vez sin que eso comprometa el resultado y sin que aparezcan duplicados. Miremos el caso del mapper, que escribe sus archivos en su propio disco: si ese worker falla y otro toma ese mismo map, termina escribiendo lo mismo. No queda ningún residuo anómalo: quedan los mismos archivos, en otra máquina.
¿Cuál es entonces la estrategia básica? Reintentar los trabajos que fallaron. Es toda la estrategia, y ahí está su simplicidad.
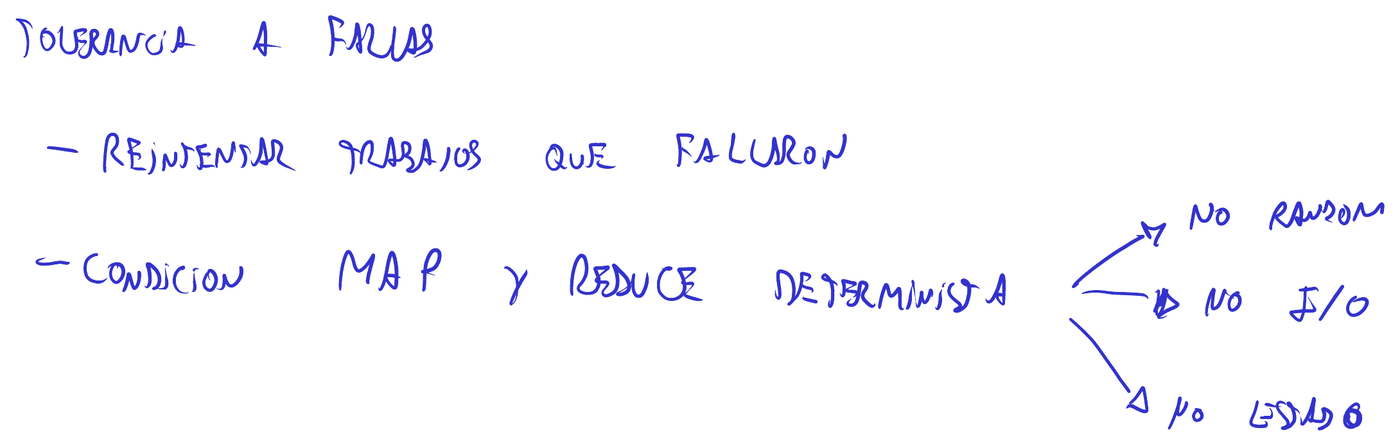
Hay, eso sí, un requisito importante, y se ve con un escenario concreto. Un mapper genera un archivo y falla, otro reintenta ese mismo trabajo, y un reducer recibe la mitad de sus archivos de una ejecución y la otra mitad de la otra. Esos archivos tienen que ser iguales. ¿Cómo se garantiza? No se garantiza: lo tiene que garantizar quien escribe el programa. Hay que estar seguro de que los mappers son deterministas: si a un mapper se le da un input y genera N archivos intermedios, esos archivos siempre tienen que ser los mismos.
Es una condición del sistema, no una recomendación. De ahí salen tres prohibiciones concretas: map y reduce no pueden generar números aleatorios, no pueden hacer entrada y salida, y en general no pueden tener estado. Si volvemos a ejecutar el mapper, el resultado no puede ser distinto. Es muy parecido a la idempotencia.
La prohibición que más incomoda es la de entrada y salida. ¿Por qué el mapper no puede hacerla? Su input es el archivo de entrada, y con eso no hay problema; lo que no puede es pedirle algo por consola a una persona, o conectarse a la red para obtener la hora. Puede acceder a recursos externos siempre y cuando eso no cambie el resultado final: si accede a un archivo modificable, o a un servidor que le devuelve la hora, es muy probable que el diseño sea incorrecto. No está estrictamente prohibido hacer entrada y salida: lo prohibido es hacerla de una forma que cambie el resultado.
El paper es preciso sobre este “no estrictamente prohibido”. Cuando map y reduce son deterministas, la implementación distribuida produce la misma salida que produciría una ejecución secuencial sin fallas del programa entero: esa es la garantía fuerte, y es la que se pierde al romper el determinismo. Cuando los operadores son no deterministas ofrece semánticas más débiles pero todavía razonables: la salida de una tarea de reduce equivale a la de alguna ejecución secuencial del programa, pero la de otra tarea puede corresponder a una ejecución distinta. Cada partición es individualmente coherente, y el conjunto puede no corresponder a ninguna corrida única.
§3.3 agrega una asimetría que conviene tener explícita. Cuando un worker se cae, las tareas de map que ya había completado se vuelven a ejecutar, porque su output quedó en el disco local de la máquina caída; pero las de reduce ya completadas no hace falta re-ejecutarlas, porque su output está en el sistema de archivos global. La distinción entre disco local y GFS que motivaba la co-locación reaparece aquí determinando qué se pierde y qué no. El paper da también el mecanismo detrás de que el coordinador use una sola versión de cada mapper: cuando una tarea la ejecuta primero el worker A y después el B porque A falló, todos los workers que están ejecutando tareas de reduce son notificados, y cualquier reduce que todavía no haya leído los datos de A los va a leer de B. Como muestra de que el mecanismo funciona en la práctica: un mantenimiento de red dejaba inalcanzables grupos de 80 máquinas por varios minutos, y el master re-ejecutó su trabajo y siguió avanzando.
Ejecución especulativa y renames atómicos
Si quien programa cumple esa condición, MapReduce va a reintentar los trabajos cuando fallen. Y además lo que venimos anticipando: reintentarlos también cuando no fallen.
La mecánica es la que asomó con los heartbeats. Si el coordinador ve que un map está lento y que todo el mundo lo está esperando, entonces —a pesar de que no haya fallado nada— puede iniciar el mismo job en otro nodo y dejar que compitan. El primero que termina, termina; al segundo se le descarta el trabajo, sin consecuencias.
Lo que se compra con ese desperdicio se ve poniéndole números al nodo lento. Un disco degradado de 30 MB/s a 1 MB/s —uno de los dos casos del paper— multiplica por treinta lo que tarda una tarea: la que en una máquina sana lleva un minuto, ahí lleva media hora. Y la fase no termina hasta la última tarea, así que ese único nodo degradado compromete el job entero.
Lo que hace que eso no ensucie el resultado es que el coordinador toma una sola versión de cada mapper: no le envía dos veces el mismo archivo a un reducer, uno de cada ejecución. Los reducers terminan trabajando con los mismos archivos, hayan salido de la primera ejecución o de un retry.
Del lado del reducer el mecanismo es otro. El output va al Google File System, que tiene una forma de hacer escrituras atómicas: el reducer genera ahí un archivo temporal y, al final, le cambia el nombre. Ese es el output definitivo.
Si hay dos réplicas del reducer 1 trabajando en lo mismo, las dos escriben en GFS, pero en archivos temporales distintos. Una termina y le cambia el nombre al suyo, que queda como output definitivo; la otra probablemente también termine y el suyo va a sobrescribir al primero. Pero como el reduce es determinista, el contenido es igual al que ya estaba: el resultado final es exactamente el mismo.
El paper llama a esto backup tasks (§3.6), con un disparador algo distinto del que describe la clase. No es que el coordinador vigile a cada tarea y reaccione al verla lenta: espera a que la operación esté cerca de completarse y ahí programa ejecuciones de respaldo de todas las tareas en curso, marcando cada una como completada en cuanto termina la primaria o la de respaldo. Está calibrado para que el costo no pase de unos pocos por ciento de recursos, y lo que compra es mucho: el sort que usa como benchmark tarda un 44% más cuando se desactiva el mecanismo. Los dos ejemplos de straggler que da son buenos: un disco en mal estado cuyos errores corregibles bajaban la velocidad de lectura de 30 MB/s a 1 MB/s, y un bug de inicialización que dejaba deshabilitadas las cachés del procesador y hacía a esas máquinas más de cien veces más lentas.
Fallas del coordinador
Queda el caso que el esquema no cubre: ¿qué pasa si falla el coordinador? Ahí falla todo y hay que iniciar el MapReduce nuevamente. Ese era uno de sus puntos débiles.
Se puede mitigar, aunque no resolver. El coordinador podría guardar su estado en disco en vez de tenerlo todo en memoria, porque el plan de trabajo y esa información administrativa la estábamos suponiendo implícitamente en memoria: un array con todos los jobs y quién fue tomando cada uno. Si eso se va persistiendo en un archivo, tal vez se pueda salvar algo: si el coordinador falla, se lo vuelve a iniciar y quizás pueda retomar el trabajo. Pero en general el sistema no es muy resistente a que falle el master: por defecto hay que hacer un retry de todo.
El paper describe la mitigación en los mismos términos y da la razón por la que no la implementaron. Dice que es fácil hacer que el master escriba checkpoints periódicos de sus estructuras de datos, y que si falla se puede iniciar una copia nueva desde el último. Pero agrega: dado que hay un único master, su falla es improbable, y por eso la implementación de entonces aborta la computación entera, dejando que los clientes detecten esa condición y reintenten si quieren. Es decir que el punto débil es una decisión consciente sobre un evento infrecuente, no un descuido.
Y eso es todo. El sistema es relativamente simple y no incluye mucho más que esto.