5. RPC y semánticas de entrega
En esta sección
Remote procedure call
El pseudocódigo del servidor de tiempo dejó un cabo suelto. En el programa del cliente el mensaje se manda a un canal y la respuesta se recibe de otro: NameForTimeService para la ida y NameForClient para la vuelta. A primera vista tendría que ser el mismo nombre, y la asimetría desconcierta. La explicación es que el ejemplo asume que el canal no es bidireccional, y por eso abre dos. En TCP, típicamente, los canales sí son bidireccionales, y el segundo nombre no haría falta. Es una particularidad del ejemplo y podemos dejarla de lado.
Lo que no es una particularidad del ejemplo, y que en cambio resulta prácticamente inevitable, es la terna de operaciones que aparece cada vez. Decir “siempre” sería demasiado, pero muy frecuentemente los canales de comunicación se van a usar de una forma muy particular: mandamos un mensaje, recibimos un mensaje, y lo deserializamos para saber qué contenido tiene. Eso se repite infinitas veces, cada vez que queramos que un componente se comunique con otro.
¿Y por qué vamos a estar haciendo eso una y otra vez? Porque esa secuencia se parece bastante a la forma que ya tenemos de llamar a un procedimiento. Cuando uno llama a un procedimiento, llama a una funcionalidad; esa funcionalidad hace algo y devuelve un valor. Son los parámetros que se le pasan, más el nombre del procedimiento, más la respuesta: exactamente las mismas tres piezas.
Eso es tan común que existe una solución general que se construye como una capa por encima de los sockets que va a ser la primitiva principal que vamos a usar durante toda la materia. Prácticamente nunca vamos a escribir sockets directamente: vamos a usar en cambio algo que se llama remote procedure call, o RPC. El estilo request-response es tan común que directamente recibió ese nombre propio. A veces no está del todo explícito que algo sea RPC, pero conceptualmente casi siempre termina siéndolo.
El origen de RPC está en los años ochenta, y responde otra vez a la ambición de agregar transparencia: querían que una llamada a un procedimiento local se pudiera reemplazar por una llamada a uno remoto, y que funcionara igual. Es exactamente la misma ambición que produjo el Network File System. RPC se sigue usando muchísimo, pero ya no se enfatiza tanto aquella transparencia, porque hay problemas que emergen de ahí.
¿Qué cambia respecto de lo que teníamos hasta ahora? Seguimos en la capa end to end, pero dentro de ella podemos imaginar a su vez dos capas. Arriba está la aplicación que uno escribe. Abajo está la capa de RPC, que le esconde a uno toda la interacción con los sockets. Más abajo todavía están los sockets, donde queda metida también la capa de transporte, y por debajo la red. Introducimos entonces una capa intermedia, y esa capa resuelve el problema de las comunicaciones.
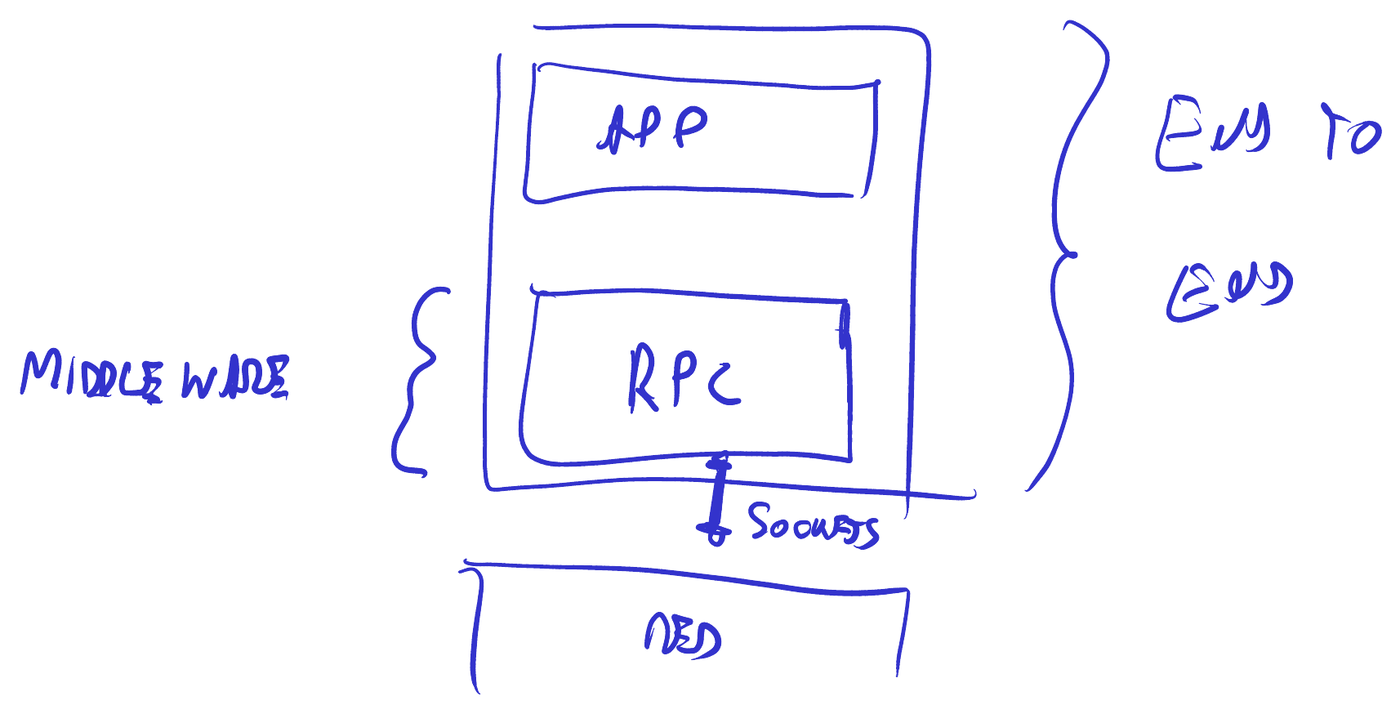
Este es uno de los tantos ejemplos de lo que se suele llamar el middleware en los sistemas distribuidos, concepto que era muy popular en los años noventa y que ya está un poco en desuso. Conviene desambiguarla, porque quienes escriben aplicaciones con Node y Express también tienen middlewares, y no son los mismos. Aquí el middleware era más bien una capa intermedia, porque resuelve exclusivamente problemas de comunicación y de acceso a un sistema distribuido, y es lo que provee transparencia hasta cierto punto. El término, de todos modos, no termina de convencer: es tan amplio que no dice nada. Resulta preferible decir directamente que vamos a usar RPC como nuestro principal paradigma de comunicacion entre componentes de nuestro sistema distribuido. Vamos a ver que en los papers que estudiaremos, la interfaz basada en RPC es practicamente estandar.
El truco de RPC fue poder generar esa parte de manera reutilizable, de modo de no tener que programar nosotros mismos esa secuencia de tres operaciones cada vez. Queremos que lo que veamos tenga la interfaz de un procedimiento común, aunque por debajo esté ocurriendo algo completamente distinto.
La forma en que típicamente se hace esto, desde los ochenta hasta la actualidad, es mediante generación automatica de código, en lo que se ha en llamar un stub. Un stub es una pieza que representa a la función, pero donde la función en realidad no está. Desde nuestro código de aplicación vamos a ver una función común, con todo el aspecto de una función común: en el ejemplo se llama GET_TIME. Pero cuando la llamemos, y siendo que la implementación real vive en el servidor remoto, no vamos a estar llamando a esa implementación sino al stub: una especie de proxy, un sustituto que está ahí en el medio. Lo que ese stub hace es el marshalling de los parámetros: toma los parámetros y el nombre de la función, y se los manda por el socket a otro stub que está del otro lado. Ese segundo stub los desarma, los extrae, y es él quien termina llamando a la implementación real. La función hace lo que tiene que hacer y devuelve algo; el stub del servidor captura ese resultado y se lo devuelve al que había llamado. Es, en definitiva, un truco: pareciera que la función está implementada de este lado, y en realidad está del otro.
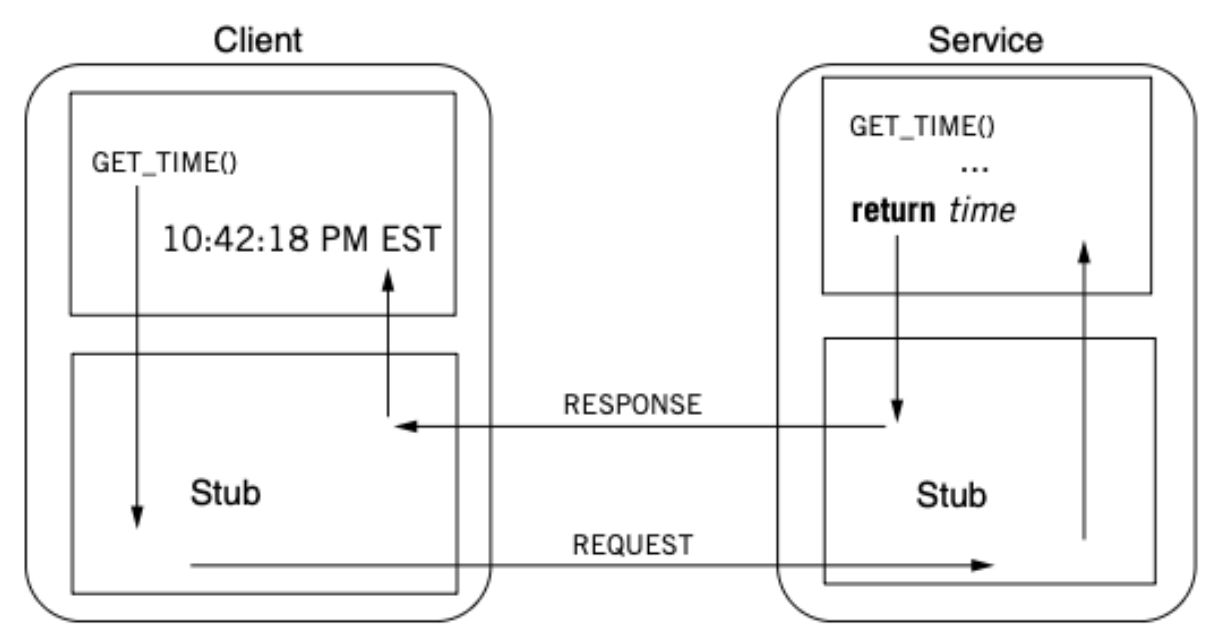
En los ochenta se enfatizaba mucho que el engaño fuera total, igual que en el caso del NFS: quien llamaba a GET_TIME no sabía que la función vivía en otro lado. El modelo se sigue usando hoy, pero el cliente (y en particular el programador que desarrollo al cliente) sabe que está llamando a algo que vive en otro lugar. Más que una forma de esconder la distribución, es una forma de acceder a un servidor remoto sin tener que programar uno mismo el socket y el marshalling, que es la parte engorrosa, repetitiva y propensa a errores.
Así termina viéndose el código, sobre el mismo ejemplo del servidor de tiempo, ahora escrito con stubs.
Client program

 1  procedure MEASURE (func)
 2      start ← GET_TIME (SECONDS)
 3      func ()                          // invoke the function
 4      end ← GET_TIME (SECONDS)
 5      return end - start
 6
 7  procedure GET_TIME (unit)            // the client stub for GET_TIME
 8      SEND_MESSAGE (NameForTimeService, {"Get time", unit})
 9      response ← RECEIVE_MESSAGE (NameForClient)
10      return CONVERT2INTERNAL (response)

Service program

 1  procedure TIME_SERVICE ()            // the service stub for GET_TIME
 2      do forever
 3          request ← RECEIVE_MESSAGE (NameForTimeService)
 4          opcode ← GET_OPCODE (request)
 5          unit ← GET_ARGUMENT (request)
 6          if opcode = "Get time" and (unit = SECONDS or unit = MINUTES) then
 7              response ← {"ok", GET_TIME (unit)}
 8          else
 9              response ← {"Bad request"}
10          SEND_MESSAGE (NameForClient, response)
Comparadas las dos versiones, lo que antes era una función que en el medio tenía que mandar, esperar y convertir ahora se ve como si fuera una llamada local. Las líneas 1 a 5 del programa cliente son una función común y corriente. Todo lo que antes estaba a la vista —el send, el receive, la conversión— quedó encapsulado en las líneas 7 a 10, que son el stub del cliente. Del otro lado ocurre lo simétrico: el programa del servicio es el stub del servicio.
Alguien tiene que escribir esos stubs, y si hubiera que escribirlos a mano para cada función, buena parte de la ganancia se perdería. La clave, y lo que hace que RPC sea usable en la práctica, es que los stubs se generan automáticamente.
Caso de estudio: gRPC
El ejemplo concreto va a ser la forma en que lo implementa Google en el lenguaje Go, y es además lo que vamos a usar en el primer trabajo práctico. La herramienta se llama gRPC. Uno tiende a leer la G como la inicial de Google, que efectivamente es quien lo inventó, pero el propio proyecto se encarga de desmentirlo: la sigla se lee como gRPC Remote Procedure Calls, en una definición recursiva, y la G cambia de significado en cada versión que publican.
El repositorio del proyecto mantiene el archivo
doc/g_stands_for.mdcon la lista completa: en la versión 1.0 la G era por gRPC, en la 1.1 por good, en la 1.2 por green, en la 1.3 por gentle, y así sucesivamente.
Tanto el programa del cliente como el del servidor tienen sus particularidades, pero lo más llamativo aparece antes que los dos. La especificación del protocolo no vive adentro del código: va en un archivo aparte, que en este ejemplo se llama time.proto. Ahí adentro se define un servicio —así se llama—, con el nombre que uno quiera, y dentro de ese servicio el nombre de cada función que se quiera poder ejecutar, junto con el tipo de lo que recibe y el tipo de lo que devuelve. En el servidor de tiempo, el pedido no lleva ningún parámetro, porque es simplemente un get; y la respuesta lleva justamente el tiempo. Ese archivo es lo que une todo con todo.
Hasta aquí no hay una sola línea de código Go. El .proto no es un programa, es una especificación, y una especificación no se ejecuta. Por eso, en algún momento hay que llamar a una herramienta especial que tome ese archivo y lo transforme en código Go propiamente dicho; en el ejemplo eso se dispara con un make gen. Y de esa herramienta hay una implementación para cada lenguaje: del mismo time.proto se puede generar código Go, código C o código Java.
Al ejecutar ese comando aparece un archivo nuevo. Lo primero que dice, en su primera línea, es que es código generado por gRPC y que no hay que modificarlo, porque cualquier cambio se pierde y puede romper el sistema. No tiene mucho sentido leer sus detalles —ni siquiera resulta cómodo navegarlo—, pero sí importa saber qué es: ese archivo es el stub, una biblioteca que generamos nosotros mismos y que implementa la especificación que definimos en el .proto.
Del lado del cliente, entonces, lo que hay que hacer es importar ese código generado, abrir una conexión con el servidor y, con esa conexión, generar un objeto cliente. Después se llama al método y con eso alcanza: a partir de ese momento uno se despreocupa del resto, el objeto responde, se conecta internamente con el remoto y resuelve el resto.
El servidor es un poco más complicado. Ahí hay que implementar esas funciones, las que declaramos en el .proto, y después pasárselas de alguna forma al código generado. Como Go no tiene clases, las implementaciones se meten en un struct, y ese struct se le pasa a RegisterTimeServiceServer, que también es código generado. Es la operación simétrica a la del cliente: al stub se le conectan las cosas implementadas por nosotros.
Lo que hay que escribir uno mismo son tres piezas: el time.proto, que define la interfaz; el código principal del cliente; y el código principal del servidor. Toda la parte tediosa —usar el socket, serializar y deserializar— la resuelve automáticamente gRPC, y ese reparto es el punto de todo esto.
Disgresión: REST
¿Por qué usaríamos RPC, con todo este aparato encima, y no REST, más allá de la diferencia de velocidad? Lo primero es desarmar la premisa, porque la velocidad no es el problema aquí: REST se podría usar tranquilamente.
La diferencia real es otra. REST es mucho más rígido, en el sentido de que no permite definir métodos propios. En REST hay básicamente cuatro o cinco métodos (GET, POST, PUT, DELETE, etc), y sobre eso hay que construir algunos paths que representen las operaciones que uno puede hacer. Eso viene bien cuando lo que tenemos está implementado sobre un servidor HTTP que no podemos modificar demasiado. Pero cuando tenemos control sobre todos los nodos del sistema resulta mucho más claro, semántica y conceptualmente, hacerlo con un frameworkd de RPC directamente, y no construir un mecanismo de RPC sobre REST.
Supongamos que queramos iniciar una máquina. En REST eso típicamente se resuelve con un POST y un path, con el método por un lado y el path por otro; con RPC uno simplemente lo diseña como si fuera una función normal, y encima la puede documentar como tal.
Hay además una ventaja técnica menor que segun el caso tendra mayor o menor peso: como gRPC es binario, tiene el beneficio de ser más compacto y en consecuencia más rápido. Pero no diríamos que la velocidad es el argumento: a menos que haya que enviar grandes volúmenes de datos por la red, no se nota. Lo importante está a nivel del programador. No hace falta pensar cómo adaptar cada operación a lo que sería una interfaz REST: directamente se escribe el servicio, se escribe la interfaz como uno la quiere escribir. Y esas son procedimientos, que son mucho más flexibles que los métodos que ofrece REST.
Mas alla de estas cuestiones con REST vamos a comprobar que se suele poder hacer lo mismo, pero forzando un poco la semántica: por ejemplo si la operación es un verbo (que no es de los que vienen en la especificación REST) vamos a tener que construirlo a partir de uno de los verbos existentes. El verbo de “encender maquina virtual” por ejemplo se va a traducir a alguna variación de POST a pesar de que no se está posteando nada.
Y sin embargo, como en la práctica hay margen para la flexibilidad, muchas veces se usa REST de todos modos, porque es más conveniente: porque ya tenemos un servidor HTTP y no queremos instalarle encima uno de gRPC. En particular se usa mucho cuando la comunicación va a través de internet. En un Chrome no podemos instalarle un stub generado por nosotros apuntando a un servidor remoto; REST es más fácil, porque el browser ya implementa directamente ese protocolo. Ahí está, dicho al revés, la dificultad de gRPC: el cliente tiene que generar la biblioteca, insertarla con los mecanismos del lenguaje y compilarla.
Límites de la transparencia en RPC
Si bien en los ochenta se pretendía que una llamada remota fuera completamente transparente, no puede serlo, y hay dos razones. Es el mismo fracaso de ambición del Network File System.
La primera es breve y casi obvia: hay más latencia. No es lo mismo llamar a un procedimiento local que a uno que está en otra máquina, y son los mismos problemas que ya enumeramos.
La segunda es la importante. Aparecen nuevas formas de falla: las cosas pueden fallar de otra manera. Normalmente, cuando uno llama a un procedimiento, si algo falla, falla en el procedimiento. Aquí, en cambio, puede fallar de una forma muy molesta.
Normalmente uno hace el request y el otro le responde. Pero pueden pasar varias cosas. Una es que el request no llegue al servidor de destino. La otra es que llegue, pero que no llegue la respuesta de vuelta. Una se rompe cuando estamos mandando; la otra se rompe cuando el otro está respondiendo.
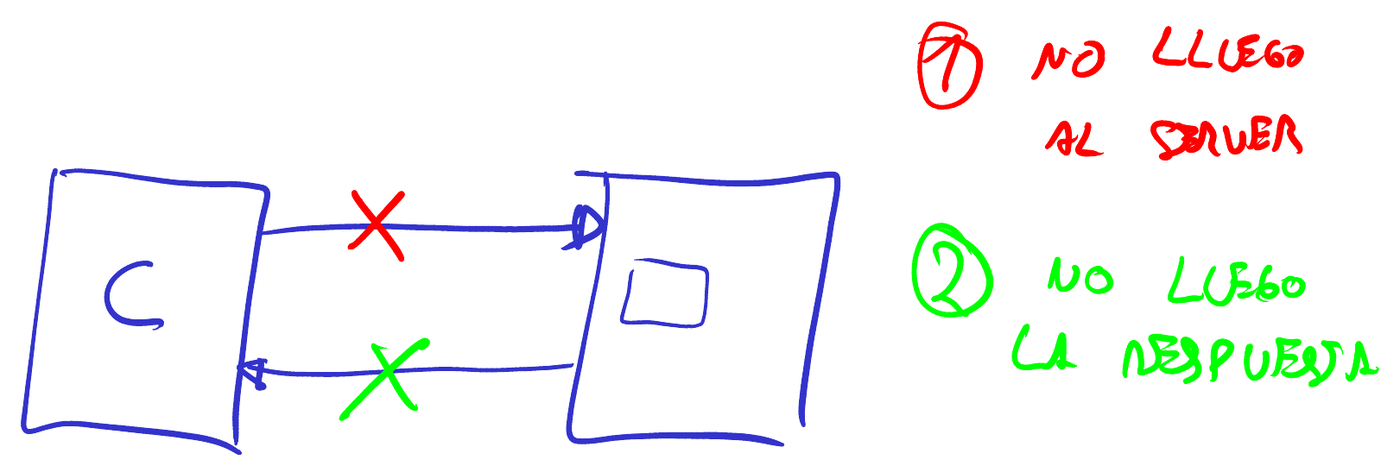
Parece una sutileza, pero no lo es, porque desde nuestro punto de vista —somos el cliente— no hay una forma fácil de diferenciar una de la otra. En los dos casos observamos exactamente lo mismo: mandamos un request y no nos llegó nada. Puede ser que nunca haya llegado al servidor; o que sí haya llegado, que se haya ejecutado allá (bien o mal, eso tampoco lo sabemos) y que lo que falló haya sido la respuesta.
Más allá de si la operación funcionó o falló del otro lado, estos son problemas del enlace, de la capa de comunicación. Y no alcanza con elegir bien la capa de transporte. Incluso con TCP, que garantiza la entrega, puede fallar la conexión, se nos puede romper el socket y desconectarse. Y entonces no sabemos si lo que queríamos hacer llegó y se terminó ejecutando, o si nunca llegó.
A esta altura uno ya estará pensando formas de solucionarlo. De eso se trata lo que viene.
Semánticas de entrega
Esa imposibilidad de distinguir un request que se perdió de una respuesta que se perdió es la que da lugar a lo que vamos a llamar semánticas de entrega. Hay tres, básicamente, y lo que las distingue es qué podemos afirmar cuando la llamada termina.
La clasificación viene de la literatura fundacional de RPC. La primera taxonomía sistemática está en la tesis doctoral de Bruce Jay Nelson, Remote Procedure Call (Carnegie Mellon, 1981; publicada también como informe de Xerox PARC, CSL-81-9), cuya sección 2.2.2 se titula justamente “Call Semantics” y enumera bastante más de tres casos: exactly-once, last-one, last-of-many, at-least-once, crash semantics. Un trabajo paralelo de Alfred Spector, Performing remote operations efficiently on a local computer network (CACM 25(4), 1982), llegaba a distinciones parecidas del lado de los mensajes. La reducción a los tres nombres que usamos acá es la que hacen Saltzer y Kaashoek en el capítulo 4 del libro que seguimos. Vale la pena notar que Nelson perseguía exactly-once por la misma ambición de transparencia que produjo el Network File System, y que la implementación real que hizo después con Andrew Birrell en Xerox —Implementing Remote Procedure Calls, ACM TOCS 2(1), 1984— terminó ofreciendo garantías más débiles.
La primera se llama at-least-once, al menos una vez. El escenario es el mismo diagrama anterior: del lado del cliente, la aplicación arriba y el stub abajo; del lado del servidor, el stub abajo y la aplicación arriba. Una forma de recuperarse ante ese tipo de problemas —siempre desde la perspectiva del cliente, que mandó algo y no está obteniendo respuesta— es hacer retry. Y lo hace el stub automáticamente: la capa de gRPC manda un request, no recibe respuesta, lo vuelve a mandar, y así insiste hasta que el otro responde.
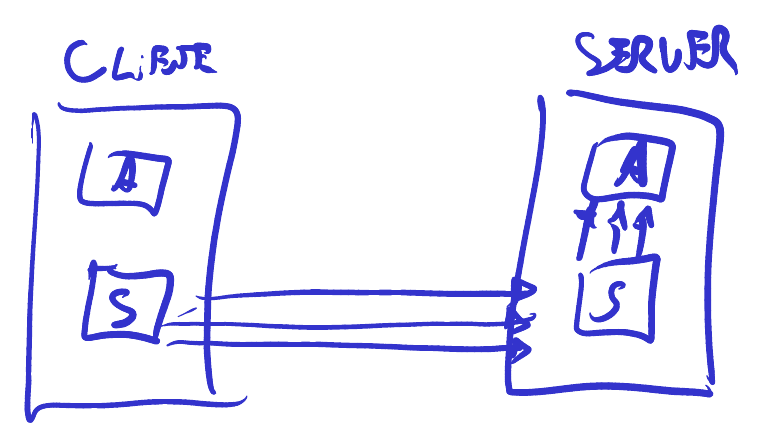
Todo esto ocurre a nivel de la capa de gRPC. Cuando uno compila la biblioteca tiene que saber qué comportamiento va a tener, si va a hacer retries o no, porque a fuerza de insistir el pedido termina pasando eventualmente. Quizá pase un tiempo y, después de un timeout, el stub desista y avise que no pudo entregar el pedido. Pero en principio, una forma de recuperarse es esa: insistir.
¿Cuál es el problema que introduce el retry? Que el servidor tiene que estar preparado para que un mensaje pensado para hacer un pedido le llegue múltiples veces. Y hay una observación fina: si bien TCP es un canal confiable, cuando hacemos retry la duplicación la estamos introduciendo nosotros, desde el lado del cliente. No es la red la que está duplicando.
El razonamiento hay que seguirlo hasta arriba de todo, hasta la aplicación, porque es ahí donde se paga la cuenta. Si le mandamos muchos requests y se van perdiendo en el camino, no llegan. Pero si lo que estaba fallando eran las respuestas, entonces todos esos retries sí le llegaron al servidor, y eso se traduce en que el stub le entrega varias veces el mismo mensaje a la aplicación que tiene arriba. Esa aplicación tiene que poder soportar que un mensaje le llegue muchas veces y seguir funcionando bien.
Eso quiere decir que la operación tiene que ser idempotente. Una operación idempotente es, básicamente, una que si se ejecuta una vez, o dos, o mil veces, da el mismo resultado.
El ejemplo típico es borrar un archivo, aunque mirado con cuidado hay que afinarlo. Si uno hace un delete de un archivo que no existe y eso devuelve un error, técnicamente no es idempotente: la primera vez funciona y la segunda devuelve error. No rompe nada, pero no es exactamente lo mismo. Ahora bien, si el delete no falla cuando no encuentra el archivo, y teniendo en cuenta que su objetivo es en definitiva que ese archivo no exista más, entonces sí tenemos una operación idempotente de verdad: un cliente puede mandar delete catorce veces y no pasa nada.
El anti-ejemplo es una transacción bancaria. Supongamos que alguien nos transfiere doscientos mil pesos y que el sistema funciona mal y reintenta la operación. Entonces, en vez de acreditarnos doscientos mil pesos, genera dinero de la nada y termina acreditándonos un millón. Ese millón, además, dice exactamente cuántas veces se ejecutó la operación: cinco. El stub reintentó cuatro veces sobre un pedido que ya había llegado, y cada reintento sumó doscientos mil pesos que nadie transfirió. Sumar a una cuenta, obviamente, no es una operación idempotente. Lo importante es que estamos ante una propiedad de la capa de gRPC, y hay que saber cuál es para poder diseñar correctamente lo que va arriba.
La segunda forma de resolver el problema se llama at-most-once, a lo sumo una vez, y es mucho más simple que su nombre. El esquema es el mismo: se manda el pedido, falla por lo que sea, no se obtiene respuesta, y no se reintenta. Es, simplemente, decir “no retry”.
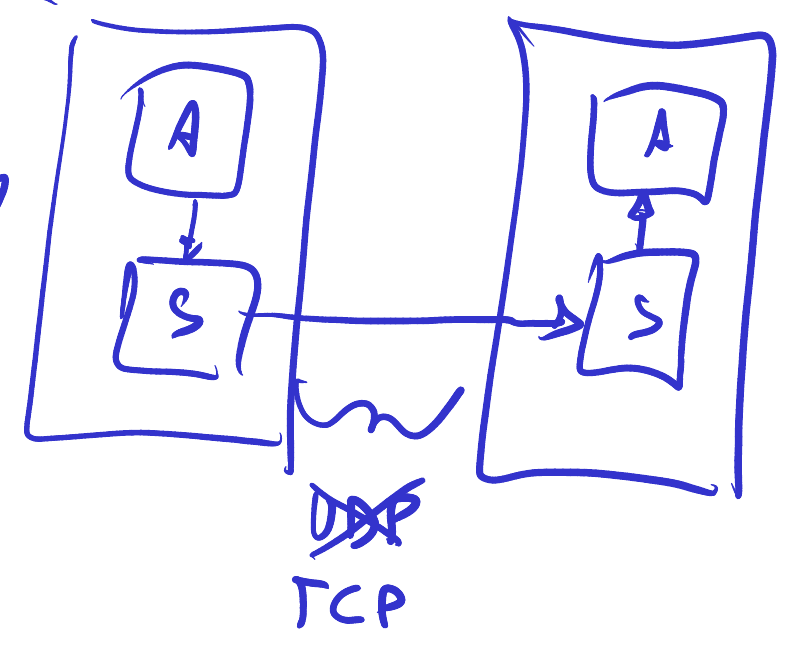
Por qué se llama así merece un poco de cuidado, porque el nombre describe lo que podemos afirmar y no lo que hacemos. Si el stub responde OK, tenemos la seguridad de que el servidor lo ejecutó una sola vez, y nada más que una vez. Si el stub responde un error de comunicación, en cambio, no podemos garantizar nada: puede que se haya ejecutado una vez, o cero veces. El error no nos dice nada; el OK sí. De ahí el “a lo sumo”: nunca más de una vez, quizá ninguna.
¿Y qué se hace entonces cuando llega un error de comunicación? Se puede hacer un retry, pero a nivel de la aplicación: la aplicación se lo vuelve a pasar al stub, y entre las dos aplicaciones se entienden en que eso es un retry y lo manejan como corresponda. La capa del stub, por su parte, no asume nada.
Todo esto en general no es tan difícil, pero tampoco es tan automático como parece, y hay aquí una sutileza. Si la comunicación de abajo fuera UDP, la red misma podría duplicar mensajes, y podría llegar varias veces el mismo mensaje y ejecutarse varias veces, sin que nadie del lado del cliente haya reintentado nada. Por eso con UDP no se puede implementar at-most-once: aquí hay que usar TCP. Es exactamente la decisión que tomábamos al principio, cuando armábamos el socket en C y elegíamos SOCK_STREAM y no SOCK_DGRAM. Ahí parecía una flag más; aquí se ve para qué servía. Es el ejemplo que habíamos prometido de por qué el diseñador de un sistema distribuido tiene que conocer la capa de transporte, y decidirla.
Sobre el gRPC que vamos a usar en el trabajo práctico, todo indica que esta es la semántica que trae por defecto: intenta mandar el pedido una vez y, a menos que uno lo configure, no hace retry automáticamente. Los retries hay que hacerlos de forma controlada. At-least-once, del otro lado, es algo que se activa.
Efectivamente, en gRPC los reintentos vienen deshabilitados y se habilitan declarando una
retryPolicyen la configuración del servicio, donde se fijan la cantidad máxima de intentos, los tiempos de espera entre uno y otro y los códigos de estado que ameritan reintentar.
Queda la tercera, exactly-once, exactamente una vez, que es la más simple de enunciar y ni siquiera necesita dibujo. Si el stub responde OK, se mandó una vez y nada más que una vez. Si el stub responde error, tenemos la seguridad de que no se mandó ninguna vez.
Exactly-once: es el caso ideal, y por lo tanto es imposible. Imposible en sentido estricto. Podemos aproximarnos bastante, y de hecho es lo que se hace en general, usando las dos semánticas anteriores y algunos trucos. Pero nunca lo vamos a poder garantizarlo en un sentido estricto. La razón es la separación física de las máquinas: uno le manda un request a la otra máquina y, en ese instante, el data center sufre una falla catastrófica. La operación se ejecutó, pero nunca vamos a obtener la respuesta, así que no podemos garantizar nada. Si el otro no responde, no hay exactly-once posible.
Por eso Martin Kleppmann, en el capítulo 11 de Designing Data-Intensive Applications, escribe que a este principio “se lo conoce como exactly-once semantics, aunque effectively-once sería un término más descriptivo”. El argumento es el mismo que estamos por hacer: reintentar significa que un pedido puede llegar y procesarse muchas veces, y lo único que se consigue que ocurra una sola vez es el efecto observable. La frase la acuñó Viktor Klang en 2016, y su formulación es casi una receta: effectively-once es lo que se obtiene combinando at-least-once con operaciones idempotentes. Es literalmente lo que hacemos en lo que sigue con el idempotency id.
Ahora bien, esos casos son poco frecuentes, así que en general se puede lograr algo suficientemente parecido. Una forma es apoyarse en at-least-once y, si la función del servidor no es idempotente por naturaleza —una transacción, por ejemplo—, introducirle la idempotencia nosotros.
El ejemplo concreto de cómo se hace eso (que es una de las tantas formas que hay) es el siguiente. A nivel de la aplicación, y sobre una capa de abajo que es at-least-once, mandamos el request con la operación (digamos, agregar dinero) y con la suma, y le agregamos un tercer campo: un número generado que se llama idempotency id.
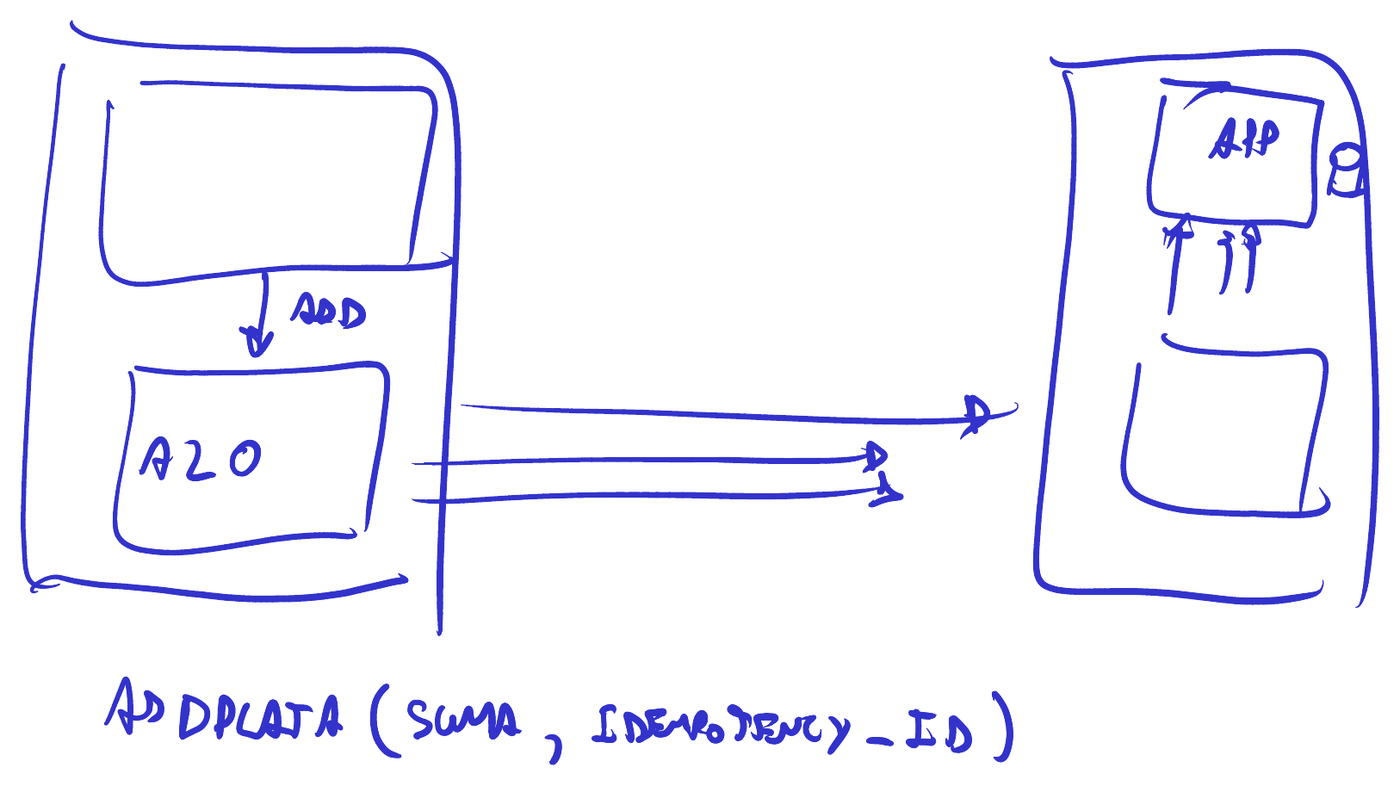
La mecánica es esta. La aplicación le manda el pedido a la capa de abajo, y esa capa se lo manda al otro las veces que quiera; hace muchísimos retries. El servidor puede recibir el mismo mensaje muchas veces, igual que antes. Pero la aplicación del servidor mantiene un storage persistente de esos idempotency ids. Entonces, si recibe varias veces un mensaje con el mismo idempotency id —y siempre va a ser el mismo, porque quien está haciendo los retries es la capa de abajo, sobre el mismo pedido original—, ejecuta uno e ignora todos los demás.
Esos retries, además, los podemos hacer nosotros mismos, mandando el mismo mensaje varias veces con el mismo idempotency id. No hace falta que la capa de abajo sea at-least-once: puede ser la otra semántica, y los retries los hace la aplicación directamente.
Eventualmente el pedido pasa. Y cuando pasa sabemos que, a pesar de haber mandado muchos requests y de no haber obtenido respuesta, si llegaron todos y se procesaron todos, la operación se ejecutó una sola vez, porque la aplicación se encargó de no ejecutar varias veces lo mismo. Es una de las técnicas que se usan para volver idempotente una operación que no lo es, valiéndose de un storage persistente. Y esta clase de técnicas es lo que vamos a ver durante el resto de la materia.