6. Programación sobre Zookeeper
En esta sección
Servicio de configuración: nodo ready
El primer ejemplo del paper de Zookeeper, y también el primero de la clase del MIT, es un servicio de configuración. Vamos a presentarlo de manera algo distinta a como lo hacen ellos, porque así se comprende mejor de dónde surge el problema.
La situación, hipotética, es la siguiente. Hay una máquina que actúa como líder, pero no en el sentido en que veníamos usando la palabra: no es el líder de un cluster de Raft, sino una máquina que mantiene la configuración del sistema y la almacena en Zookeeper para que todos puedan acceder a ella.
Para almacenarla realiza una serie de escrituras: A con el valor V1, después B con el valor V2, y supongamos que en algún momento hubo un cambio, de modo que vuelve a escribir A, esta vez con V3.
Lo que pretendemos resolver es cómo realizar una lectura transaccional: deberíamos poder leer A = V3 junto con B = V2, porque esto, en rigor, constituye una transacción. Y el problema es que Zookeeper no ofrece transacciones: cada escritura es individual y no pueden agruparse. A este tipo de agrupamiento también se lo denomina mini transacciones, pero el nombre no es lo relevante.
Con dos clientes ya se advierte qué puede fallar. El cliente uno actúa como líder y escribe la configuración; el cliente dos pretende leerla. Si realiza un read de A y después uno de B, pueden ocurrir dos cosas, según dónde esté el log del que lee: como lee de un follower y no del lugar donde se escribió, puede obtener información desactualizada. Puede ocurrir perfectamente que observe A = V1 y B = V2 y considere que esa es la configuración. Y eso difiere de lo que el escritor dejó registrado.
Para comprender por qué, hay que representar el ZXID de cada escritura, el índice dentro del log. Supongamos que A = V1 se materializó en la posición 100, B = V2 en la 101 y A = V3 en la 102. El follower del que el cliente dos está leyendo se encuentra en la 101, algo desactualizado, de modo que al leer A observa el valor vigente en la 101: V1, porque el V3 está en la 102 y esa entrada no le llegó. Y B vale V2, que también rige desde la 101. El cliente dos lee A = V1 y B = V2 y considera que esa es la configuración. Es incorrecto: se trata de media configuración anterior y media nueva.
Lo que debemos hacer es leer cuando el cliente uno ya terminó de actualizar todo. Y el mecanismo que ellos explican es un nodo auxiliar, /ready. El escritor, al concluir las tres escrituras, realiza un create de ese nodo, que en principio no contiene información: es simplemente un nodo de sincronización. Y esa operación queda en la posición 103.
Del lado del lector, antes de leer hay que invocar exists. Si el nodo todavía no existe, exists no bloquea: devuelve false. Pero tampoco hace falta un loop que lo consulte repetidamente, porque se le puede pedir un watch —la primitiva que aparece en la subsección siguiente— y la notificación avisa cuando el nodo aparece. Eventualmente va a aparecer, porque el escritor lo creó. El paper apoya en eso el ejemplo completo, y agrega un argumento: las notificaciones están ordenadas respecto de las lecturas, de modo que un cliente que está observando el nodo recibe el evento de notificación antes de poder leer el estado nuevo. Por eso el watch alcanza para no leer una configuración parcialmente actualizada.
Y cuando exists devuelve true disponemos de una garantía que antes no teníamos: estamos leyendo de un lugar cuyo ZXID es 103 como mínimo. Entonces, al solicitarle las dos lecturas a ese mismo lugar, vamos a obtener el último valor de A, que es V3, y el de B, que es V2.
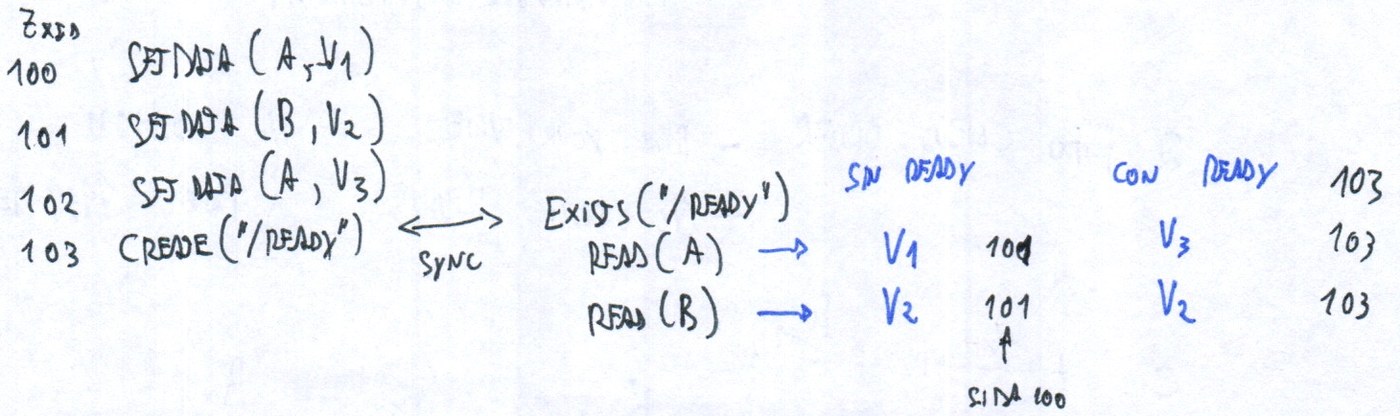
Lo que hay que advertir es que ese nodo funciona como mecanismo de sincronización de los logs. El cliente, cuando invoca exists y espera, no va a utilizar en absoluto el contenido de /ready; el nodo en sí no le interesa. Lo que consigue al esperarlo es sincronizar el log del follower con lo que él necesita.
Dicho con más precisión: aquí la configuración se escribe una sola vez en el sistema, y pretendemos leer al menos desde el punto donde ya está escrito todo. Si sabemos por definición que ready se crea cuando el escritor concluyó con toda la configuración, debemos comenzar a leer al menos desde allí. Ese exists bloquea hasta que el escritor creó el nodo, y eso determina que el ZXID desde el que leemos sea 103 como mínimo. Puede ser mayor, pero eso no es relevante.
Y si es 103, todas las lecturas posteriores van a operar sobre una versión de Zookeeper que ya nos resulta adecuada, porque cada operación con ZXID establece un concepto de versión: cada snapshot de la base de datos está asociado a uno de esos ZXID. De la 103 en adelante ya está disponible toda la información que necesitamos, con lo cual podemos leer A y B, o B y A, en el orden que prefiramos.
Quizás resulte más claro considerando cómo sería sin ese ready. Sin él, uno puede leer una versión del log como si concluyera allí: leer de un follower actualizado hasta esas dos primeras posiciones, quedarse con A = V1 y B = V2, y nunca enterarse de que después el escritor registró A = V3. Con el ready uno sabe que se encuentra al menos al final de lo que el otro escribió.
El nombre puede inducir a confusión: podría pensarse que ready es un registro que se escribe para indicar que pueden leerse los valores anteriores. No es eso. Imaginemos un file system donde se crea un archivo: si quien lee observa ese archivo, sabe que todo lo que el otro hizo previamente también debe estar presente. Es una práctica habitual en un file system convencional: un sistema escribe múltiples elementos y al final crea un centinela que indica que el proceso concluyó, y otro verifica que existe y deduce que todo el resto también.
Conviene pensarlo como un EOF que indica que el escritor terminó, y que el otro debe leer para saber que todo lo anterior ya está disponible. Si uno considera ese tipo de estructuras, la analogía funciona bien, y después puede revisarse el paper con esa idea presente: Zookeeper es bastante directo en ese aspecto.
Watches
El mecanismo del ready resulta suficiente para el caso que acabamos de plantear, pero ese caso es particular. Si se tratara de una única configuración que se escribe una sola vez, la cuestión concluiría allí. El problema aparece cuando hay que actualizarla múltiples veces.
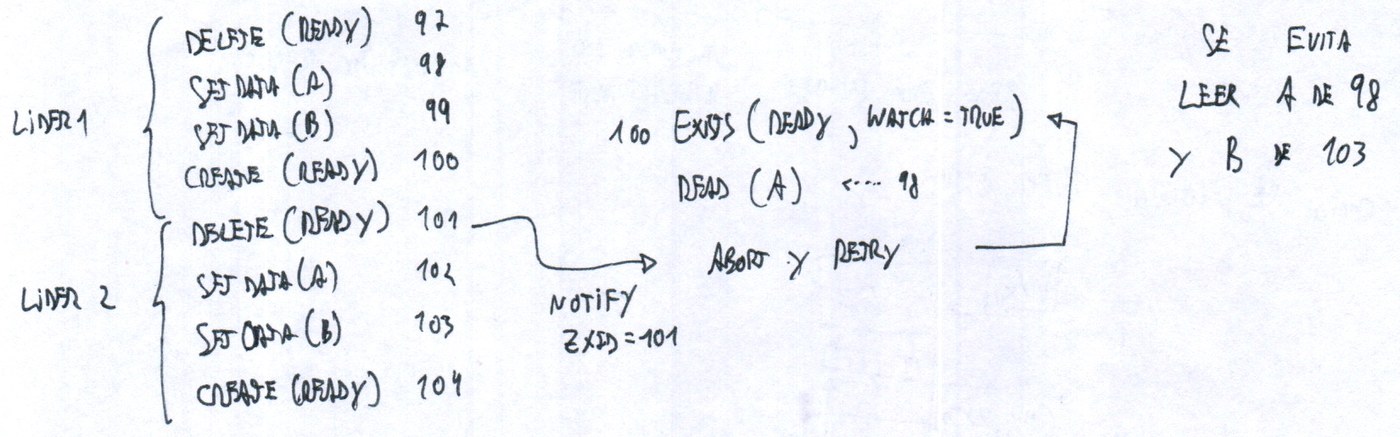
Puede haberse producido entonces una secuencia como la siguiente. Lo primero, si hubo un create anterior, es un delete del ready: para comenzar a modificar la configuración hay que retirar esa marca. Después las escrituras de A y de B, y al final el create del ready. Ahora imaginemos que el líder comenzó a escribir otra configuración: lo borra nuevamente para indicar que no está listo, escribe otra vez A, otra vez B, y realiza otro create del ready.
Y tenemos un cliente que ejecuta exists, después lee A y después B, exactamente como antes. Este es el punto donde todo puede fallar: cuando invoca exists, según dónde esté leyendo, puede haber observado el nodo en dos lugares distintos, el ready de la primera ronda o el de la segunda.
El caso problemático es el primero. Si el exists se satisfizo con el ready de la primera ronda, al leer A puede obtener A1, el valor de la primera configuración, porque el A2 se escribió después. Y aquí reside el problema: si ese follower continuó avanzando, la garantía es que lo que leamos no va a estar más desactualizado, pero perfectamente puede estar más actualizado. Así que en la lectura de B podemos obtener cualquiera de los dos valores, B1 o B2.
Y el resultado es inconsistente, porque leímos la mitad de una configuración y la mitad de la otra. Es el peor caso posible, y se aprecia al contrastarlo con los otros dos: en el caso desfavorable leíamos A1 y B1, una configuración desactualizada pero coherente; en el mejor, A2 y B2, la más actualizada.
Aquí intervienen los watches. Se pasa watch = true, y eso significa que cuando cambie el estado de lo que estamos observando —en este caso el nodo ready— Zookeeper, o más precisamente el follower al que estamos conectados, nos va a notificar. Si creamos un ready, lo leímos y eventualmente se modificó, esta operación nos va a enviar en el intervalo un notify.
Cómo gestionamos ese aviso depende de lo que estemos intentando hacer. Pero en este ejemplo, cuando se modifica el ready —si existía y se modificó, significa que alguien lo borró— hay que volver al principio: un goto start, que expresado así resulta poco elegante, pero es exactamente eso. Nos disponemos a esperar nuevamente que el nodo exista, y solo así vamos a alcanzar su existencia en la segunda ronda, y allí lo leemos otra vez. Esa es la función de los watches: enterarnos de cuándo algo se modificó, para poder actualizarnos.
Optimistic locking y verificación de versión
Antes del último ejemplo conviene retomar el optimistic locking, anunciado anteriormente como una escritura condicional y postergado hasta disponer de las piezas necesarias. Es sencillo, y el problema que resuelve ya apareció en otros contextos: concurrencia, sistemas operativos, prácticamente en todas partes. Vamos a construir un contador, con dos máquinas que pretenden actualizarlo.
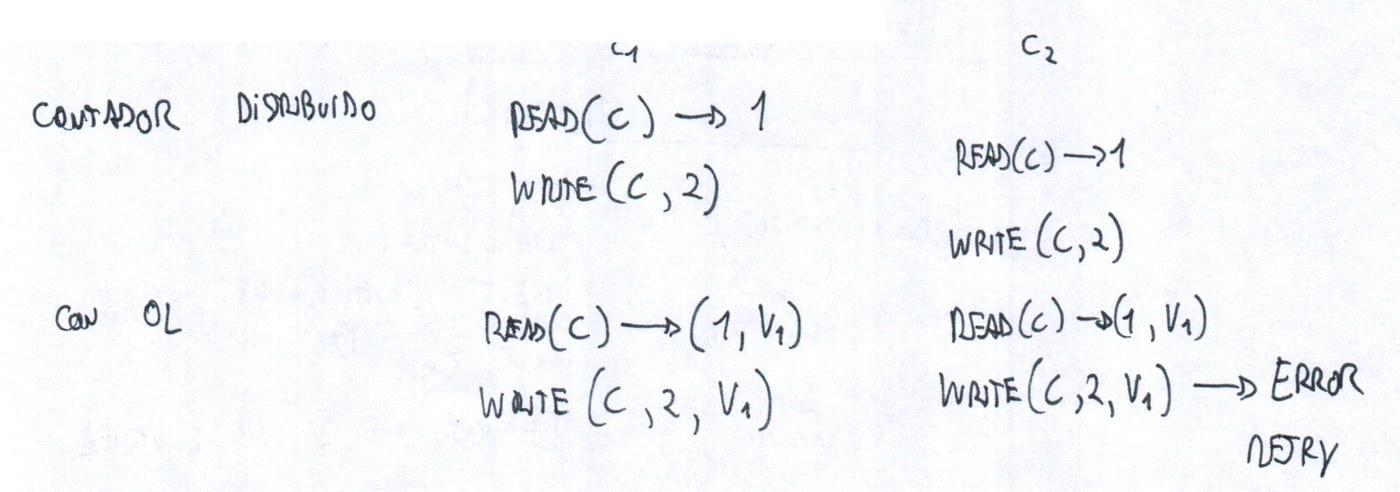
La pregunta de partida es cómo se construye un contador si no disponemos de una primitiva. Zookeeper no la ofrece, y por eso el ejemplo sirve. Sin incremento atómico hay que realizar un read del contador —supongamos que devuelve uno— y después un write de C + 1, abusando un poco de la notación. El contador queda en dos. Ese es el cliente uno.
Y simultáneamente el otro cliente hace exactamente lo mismo: lee el mismo valor, realiza un write de C + 1, y Zookeeper lo acepta. Dos clientes lo incrementaron: debería haber quedado en tres, y quedó en dos.
Una forma de resolverlo eran los mutexes del sistema operativo: se coloca un mutex, eso se convierte en una sección crítica, y el problema queda resuelto. Pero nada de eso existe en un sistema distribuido, y los locks distribuidos resultan excesivos para este caso.
Lo que emplea Zookeeper es optimistic locking. El read de C devuelve el valor y además la versión, que es más simple de lo que el nombre sugiere: un número que cambia cada vez que se ejecuta un write sobre el dato, con lo cual el próximo que lo lea va a obtener una versión distinta. Normalmente se incrementa, pero para este ejemplo eso ni siquiera importa.
Con eso, la escritura cambia: el cliente uno envía C + 1 y además, como tercer parámetro, la versión que le proporcionó el read. El resultado es el esperado: el contador queda en dos y la versión pasa a la siguiente. Es la pieza que hace funcionar todo lo demás.
Lo relevante es lo que ocurre con el otro cliente. En su lectura obtuvo el valor uno y la versión uno, y va a realizar su write con esa misma versión. Supongamos que el primero llegó antes. Zookeeper compara la versión que el escritor espera contra la que efectivamente tiene —internamente ya es la siguiente—, y si no coinciden, devuelve un error.
Eso se resuelve como siempre en el optimistic locking: reintentando. Al leerlo nuevamente va a obtener el valor dos y la versión dos, y en ese momento sí va a funcionar. Lo cual significa que todo esto debería estar dentro de un loop, iterando hasta que eventualmente resulte exitoso.
De allí proviene el nombre: se denomina optimistic locking porque se emplea cuando uno espera que la operación prospere, cuando no hay muchas operaciones concurrentes y no se requiere un lock pesimista, que sería el de los mutexes.
Pero la forma más simple de conceptualizarlo es la que ya anticipamos: esto es una escritura condicional, y está presente en la API que recorrimos. Todas las operaciones de escritura incluyen el valor de versión: delete lo incluye, y setData también. En cambio exists y la operación de obtener la data son lecturas y no lo incluyen. Esa versión es lo que nos permite implementar optimistic locking.
Y resulta coherente con la condición que planteamos al principio, la de las escrituras linealizables. Allí realizamos una lectura y una escritura de manera inmediata: leemos la versión y escribimos según sea correcta o no. Como las escrituras son fuertemente consistentes, el optimistic locking funciona.
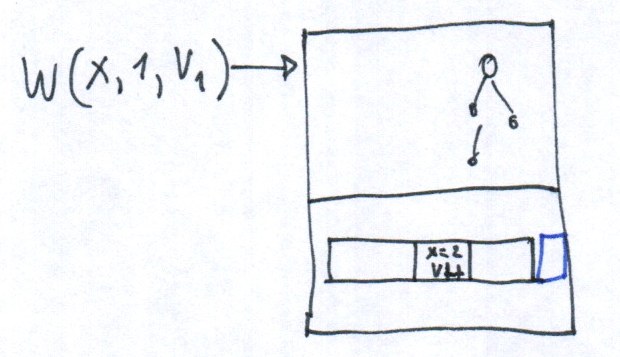
Queda un detalle de implementación, que puede aparecer o no en el TP3: cuándo se verifica la versión. Supongamos que pretendemos escribir x = 1 con la versión V1. Ese pedido llega a una máquina que tiene el árbol de nodos en la parte superior —y la versión reside allí— y el log en la inferior.
¿Cuál es el orden: se verifica la versión primero y, si resulta correcta, solo entonces lo enviamos al log y lo replicamos, o a la inversa? Aquí hay que proceder con cuidado, porque puede ocurrir que lo que está en el árbol no esté actualizado respecto del log. Supongamos que antes que nosotros llegó un x = 2 que incrementó la versión a dos. Nosotros verificamos contra el árbol, observamos que la versión es uno, concluimos que todo es correcto —porque ese x = 2 todavía no fue aplicado— y permitimos la escritura. Que es justamente lo que pretendíamos evitar.
Hay que proceder a la inversa: primero agregar al log lo que pretendemos escribir, ese x = 1 con su versión, enviarlo a todas las réplicas, y solo cuando retorna verificar la versión, porque en ese caso sí respetamos el orden del log. Allí es donde se manifiesta la linealizabilidad de las escrituras. La verificación debe ubicarse al final porque en ese momento tenemos la garantía de que la versión ya incorporó todos los cambios anteriores: si lo estamos aplicando nosotros, sabemos que lo previo ya fue aplicado. Si verificamos apenas llega el pedido, no disponemos de esa garantía.
Locks distribuidos y elección de líder
Nos queda el último ejemplo, el más interesante del paper: cómo se implementan los locks. Hay dos tipos y vamos a examinar uno solo, porque el otro es difícil de abordar completo y con uno alcanza para comprender cómo se construye un lock distribuido.
Para llegar allí hay que retomar una cuestión que quedó pendiente cuando recorrimos la API. Señalamos que a la creación de un nodo se le pasaba el path, la data y algunas flags interesantes. Hay dos que son justamente las que nos sirven: efímero y secuencial.
Un nodo efímero tampoco se vincula con ZAB ni con la forma en que se sincronizan las operaciones: lo implementa la capa de aplicación superior. Cuando un cliente se conecta y crea un nodo, Zookeeper lo va a mantener mientras el cliente conserve la conexión abierta. Hay toda una cuestión relacionada con los heartbeats, pero la idea es que el cliente debe enviarlos al servidor al que se conectó, y si dejan de llegar, se considera que falló y se elimina el nodo. Es un nodo condicionado por la conexión del cliente: esa es la primera pieza.
La otra son los nodos secuenciales. Dicho sea de paso, allí sí podría haberse utilizado la flag para implementar el contador de hace un momento. Cuando uno indica que el nodo es secuencial, lo que le transmite no es el nombre sino un prefijo: al ejecutar el create, Zookeeper crea lock-1, y si otra máquina pretende crear en el mismo lugar un nodo con el mismo prefijo, lo va a denominar lock-2. Ese número lo define Zookeeper, y puede definirlo porque, siendo un sistema distribuido, sabe cómo incrementar un contador atómico.
¿Cómo implementamos entonces un lock distribuido? Lo que ellos proponen es lo siguiente. Hay un directorio donde todo aquel que pretenda obtener el lock debe escribir un archivo con el mismo prefijo; abreviándolo como L, lo que se va formando es L1, L2, L3, L4. Ubiquémonos en la posición de alguien que pretende obtener el lock, porque una vez obtenido podemos realizar lo que necesitemos sabiendo que operamos en exclusividad, y después lo liberamos.
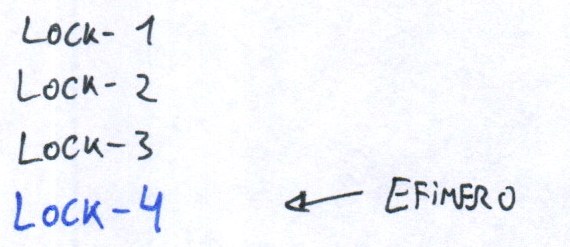
Lo primero es acceder a ese directorio y crear un archivo con ese nombre, marcado como secuencial, y Zookeeper nos va a asignar el cuatro en el ejemplo. Porque lo que se va formando admite una lectura muy concreta: el tres también pretendió obtener el lock, el dos también, y el uno también lo pretendió y probablemente lo obtuvo. Se va formando una cola de clientes a la espera. Y al crear el archivo, la operación nos devolvió el nombre asignado, que vamos a necesitar después.
El segundo paso es listar a todos los participantes, para determinar quiénes están esperando. Por ahora tenemos dos casos. El favorable: el directorio estaba vacío, ejecutamos el create, Zookeeper nos asignó el uno, listamos y el nuestro es el de número más bajo. Conceptualmente disponemos del lock y podemos realizar lo que necesitemos.
El caso más frecuente es el otro: hay varios a la espera, y debemos aguardar a que el que se encuentra inmediatamente antes que nosotros cambie. Vamos a colocar un watch en él, y lo que nos interesa es que ese nodo se elimine.
Y cuando desaparece puede deberse a dos razones, que constituyen el punto central del mecanismo. Una es el caso favorable: quien lo tenía obtuvo el lock y lo liberó, y para liberarlo simplemente elimina el nodo. Los clientes lo fueron obteniendo y liberando en orden, y cuando se libera el que se encontraba delante nuestro el wait for watch event nos devuelve true. Volvemos al paso dos, listamos los hijos, comprobamos que el nuestro es ahora el de número más bajo —puede haber otros detrás, esperando, pero ninguno delante—, y con eso obtuvimos el lock y salimos.
Pueden presentarse casos menos favorables: por ejemplo, que la máquina que tenía lock-3 haya fallado, que se haya desconectado repentinamente. Y aquí es donde adquiere relevancia la otra flag: como el nodo es efímero, si esa máquina se desconecta el nodo desaparece, y eso también activa la notificación. Volvemos al paso dos, listamos, y comprobamos que todavía hay dos antes que nosotros, de modo que permanecemos esperando nuevamente: ahora colocamos un watch en lock-2. Eventualmente puede fallar también ese y ocurre lo mismo, o pueden liberarse en orden, y entonces sí obtenemos el lock.
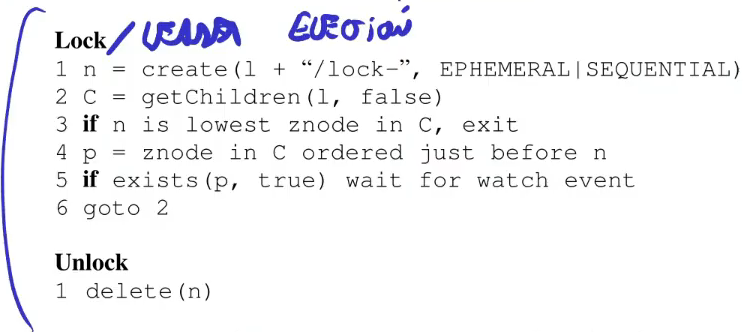
Lo que conviene retener es eso: se va formando una cola de espera para obtener el lock. El código concreto está en el paper, y conviene leerlo con esta idea presente.
Queda pendiente otra de las cuestiones prometidas, la elección de líder distribuida usando Zookeeper. Y si lo analizamos, esto que acabamos de construir también constituye una elección de líder: no hay que denominarlo lock, hay que denominarlo leader election. Quien obtiene el lock es conceptualmente el líder y puede realizar las funciones de líder. Con un solo ejemplo resolvemos ambos problemas.
Zookeeper, además, lo vamos a utilizar en el TP3 para la configuración de DynamoDB: si cambia la membresía del sistema —un nodo que se incorpora, uno que falla— van a intervenir allí los nodos efímeros y este tipo de mecanismos. Pero no hay que implementarlo: se utiliza la versión ya desarrollada.
Y la comparación es lo que sintetiza todo. ¿Cómo se implementaba la elección de líder en Raft? De forma compleja, y lo sabemos porque la estamos implementando. ¿Cómo la implementamos aquí? Con unas pocas primitivas de file system, invocándolas en orden: eso es todo lo que queda a la vista de las tres semanas de consenso que operan por debajo.