3. Transacciones read-only y external consistency
Que el two-phase commit tarde entre 10 y 100 milisegundos sería una mala noticia si todas las transacciones fueran así. Lo bueno es que no: las read-only son casi todas las transacciones del sistema, del orden del 99,7%.
Si optimizamos las read-only y dejamos donde están las de escritura, con su commit lento, optimizamos la mayor parte del sistema. Este sistema se usa principalmente para leer, y por eso todo el esfuerzo y toda la rareza está en cómo implementaron las read-only.
¿Cómo consiguen esa baja latencia? Primero, leen de la réplica local. Ese es el primer punto que resuelven, y es importante: no hay que coordinar con todo el mundo para leer, sino que se trata de leer todo de las versiones locales que están al lado. Segundo, no toman locks. Los read locks y write locks que acabamos de recorrer son solo para las de escritura. No hay two-phase locking, y la forma de resolverlo es completamente diferente.
Lo que se logra es snapshot isolation. Recordemos que las escrituras garantizan serializabilidad: aunque las transacciones no ocurran realmente una después de otra, conceptualmente es como si así fuera. Podemos imaginarnos un log imaginario de transacciones, una fila de casillas: un read, otro read, un write, otro read, y así. Entre cada una se va formando un snapshot consistente.
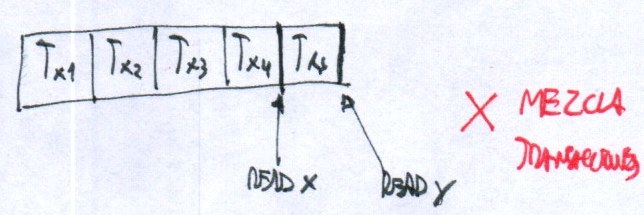
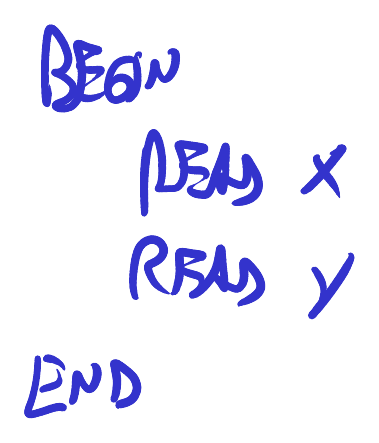
Si hacemos un begin, un read de X, un read de Y y un end, lo que no podemos hacer es leer X de un lugar del log y Y de otro. Tenemos que leer los dos del mismo snapshot. Puede ser este, el de al lado o cualquier otro, pero no una mezcla. Eso es snapshot isolation, y eso es, básicamente, una transacción read-only.
Ahora, ¿qué considera correcto Spanner, más que eso? Se autoimpusieron algo que llaman external consistency, que en lenguaje coloquial es: si la transacción T1 hace commit antes que T2, entonces T2 ve a T1.
La clave es ese “antes”: es antes en tiempo físico. No hay causalidad ni nada parecido. Si mandamos una transacción T1 que escribe X, y físicamente después mandamos T2 que lee X, esa lectura tiene que ver la escritura, simplemente porque ocurrió antes.
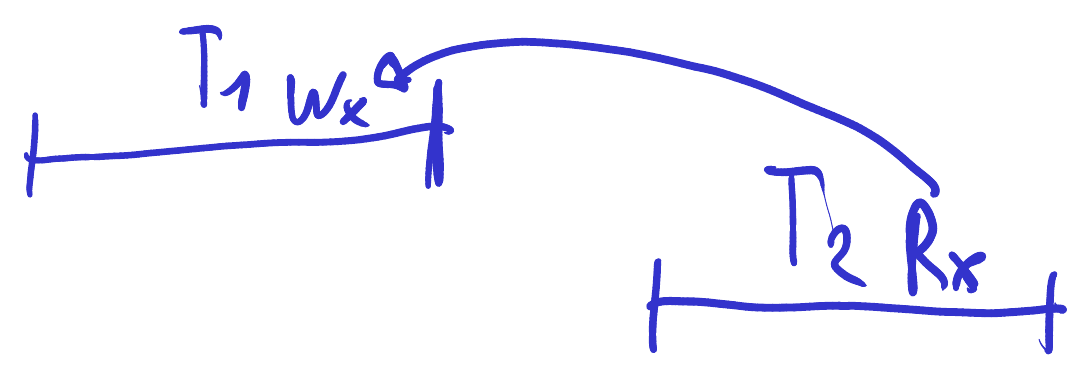
Esto debería sonarnos: es prácticamente la definición de linealizabilidad. Las transacciones tienen que respetar el tiempo físico. Y eso es un problema serio.
La external consistency es la combinación de dos cosas: serializabilidad —leer snapshots— más el requerimiento de tiempo físico, que es la linealizabilidad. Son dos requerimientos distintos, porque la serializabilidad no tiene ningún componente de tiempo real: lo que le importa es que las lecturas sean consistentes.
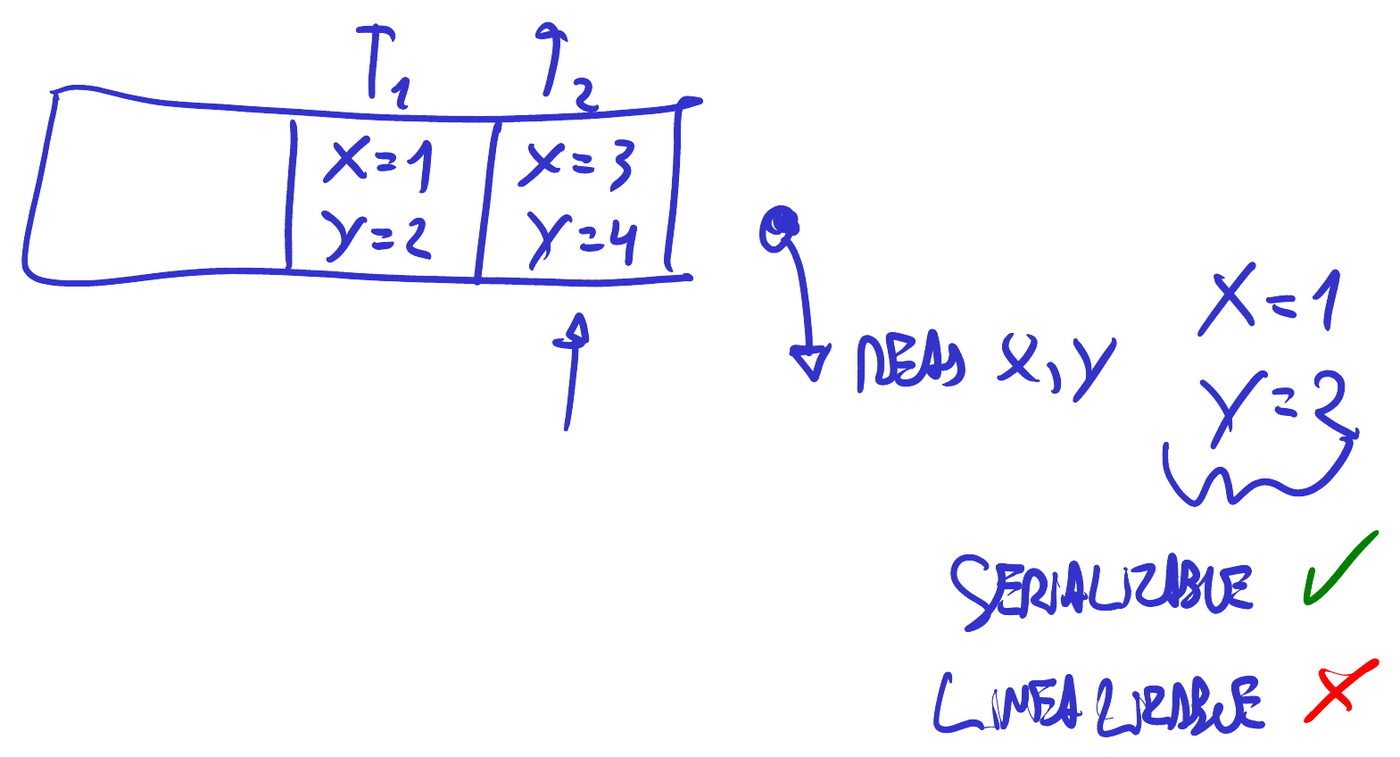
Veámoslo con un ejemplo. La transacción uno setea x = 1, y = 2, y la dos hace x = 3, y = 4. En un momento posterior a las dos hacemos un read de x y de y. Uno de los resultados posibles es x = 1, y = 2.
Debería parecernos raro que eso sea aceptable. Pero no viola la serializabilidad: es como si esa lectura hubiera caído en el pasado. Estamos leyendo un snapshot, y por lo tanto es una lectura serializable.
Lo que vamos a decir nosotros es que sí, que es serializable, pero que estamos leyendo algo del pasado y que no quisiéramos leer eso. Es justamente lo que debían decir los ingenieros que usaban el sistema: no quiero lecturas del pasado; si mandé x = 3, y = 4, y después leo, quiero ver x = 3, y = 4. Ese segundo requerimiento, el temporal, es la linealizabilidad. El caso dibujado es serializable y no es linealizable, porque leyó algo del pasado.
Algo más sobre la linealizabilidad. Aunque los ejercicios de esa clase eran siempre cosas superpuestas donde había que encontrar el punto de linealización, su propiedad fundamental es la más intuitiva: si envío un request, recibo la confirmación, y después leo lo que escribí, tengo que verlo. Linealizabilidad es otra forma de decir consistencia fuerte.
Queremos, entonces, que esto sea serializable y fuertemente consistente, y las dos cosas sin usar locks. Porque si usáramos locking pesimista las dos se lograrían automáticamente —no es inmediato explicarlo, pero pensándolo con detenimiento se ve—; el problema es que los locks pesimistas justamente bloquean, y nosotros queremos alta concurrencia. Eso es lo que queremos lograr: esas dos cosas, sin usar locks.