7. Limitaciones de GFS
El punto sensible es el coordinador, el mismo que ya nos había aparecido en MapReduce: es una única máquina física, y si falla, falla todo.
Emplea dos técnicas para evitar ese desenlace. La primera ya la vimos: escribir en disco el log y los snapshots, para poder restaurar a partir de ellos.
La segunda es que también implementa un esquema de primary-backup, igual que los réplica groups de los chunks, pero con una diferencia importante: es fijo, no dinámico. No hay roles que se reconfiguren sobre la marcha según qué máquinas sigan en funcionamiento. Hay un coordinador y un coordinador backup, y son siempre esos dos. El backup tiene todas las estructuras que acabamos de recorrer y también el log; y lo que hace el principal es enviarle ese log por la red, para que del otro lado se aplique lo mismo.
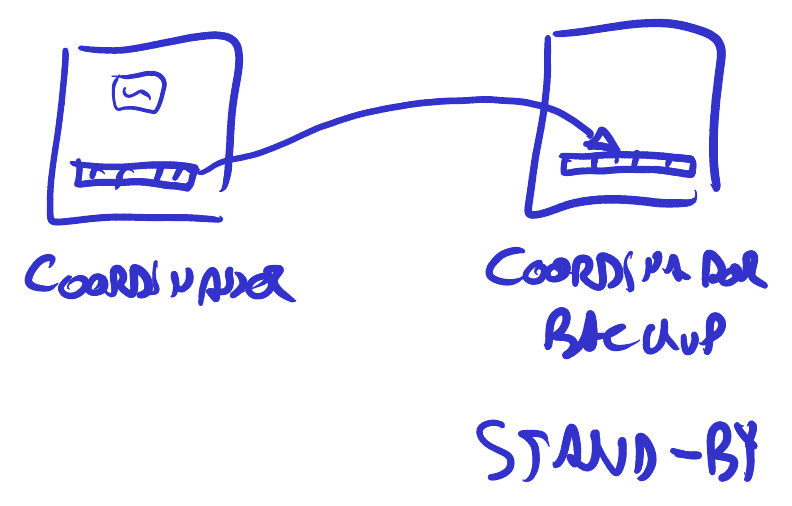
El backup, mientras tanto, no hace nada. Es lo que se suele llamar un standby: una máquina que consume recursos sin atender un solo pedido y que existe únicamente para el caso en que el principal falle. Cuando eso ocurre se la promueve a coordinador pleno y el sistema sigue adelante; después, cuando la máquina averiada se restablece, quizá sea esa la que pase a ser backup, y así van alternando. No tiene rol activo salvo en el failover. Es otra versión del primary-backup, pero rígida, sin la reconfiguración dinámica de los grupos de réplicas: la forma de mitigar el punto único de falla que en estos sistemas es siempre el coordinador.
Con el log en disco y el standby, el coordinador queda razonablemente cubierto. Pero eso no vuelve confiable al conjunto: ¿es apenas la base, y por encima hay protocolos ya implementados que se ocupan del resto, o habría que rehacer todo manualmente cada vez que se quiera construir algo encima?
La respuesta honesta es que el sistema se hizo así y quienes lo usaban conocían estos problemas. Podía fallar por muchos frentes; cuando fallan las máquinas se producen comportamientos inesperados y el sistema tarda en recomponerse, pero eventualmente lo hace.
El problema principal, sin embargo, no era el que uno esperaría. No era el split brain: es relativamente fácil de evitar, alcanza con esperar, porque el mecanismo se sincroniza por tiempo. El problema real era la falla parcial: cuando la máquina no deja de funcionar por completo sino que falla una escritura —se satura, por ejemplo—, y como no hay write atómico queda información distinta en cada réplica.
Ese es el punto que merece un juicio y no solamente una descripción. En el resto de los sistemas que vamos a ver es raro que las réplicas no sean exactamente réplicas. Lo que hace que este no parezca confiable es eso: que sean casi réplicas, copias bastante similares, y que sea el cliente el que deba detectar duplicados y huecos y convivir con esa situación. En Raft eso directamente no puede pasar, porque el sistema mismo lo evita.
Hay una entrevista de 2009 en la que Kirk McKusick conversa con Sean Quinlan, que fue el responsable técnico del Google File System, y ahí Quinlan dice justamente eso: que la consistencia del append se diseñó deliberadamente muy laxa y que, en retrospectiva, «resultó bastante más doloroso de lo que cualquiera esperaba». Lo que quedó tampoco es consistencia eventual: ese término, algo informal, se basa en que eventualmente el estado se restaura, y aquí nunca se restaura. Queda un registro repetido en un caso, un hueco en el otro, y así permanecen indefinidamente. Esto es, si se quiere, débilmente consistente, o casi consistente.
Y sin embargo —este es el contrapeso que no hay que perder de vista— es un buen ejemplo de ingeniería. Desde una mirada estrictamente formal puede resultar insatisfactorio; a Google le alcanzó, durante años, para indexar toda la web, ejecutar MapReduces y construir encima todo lo demás. Funcionó.
¿Por qué lo hicieron así? Porque era fácil. Y el contraste con Raft ilumina las dos mitades del asunto: el paper de Raft es más difícil de entender e implementarlo es notoriamente trabajoso, pero es más sólido porque cierra por todos lados: tienen el algoritmo exacto, contempla todos los casos y está demostrado matemáticamente que funciona. En el del GFS hay cosas que ellos seguramente resolvieron pero no publicaron.
Podemos hacer entonces el inventario de lo que quedó mal, y conviene hacerlo en pasado, porque hasta donde se sabe este sistema ya no se usa: fue superado por Colossus, que resuelve en parte algunos de estos problemas.
El primero ya lo tenemos: el coordinador centralizado. Si falla ese, falla todo, y la tolerancia a fallas del log y el standby es poca.
El segundo es más prosaico: se quedaban sin memoria. Como todas esas estructuras vivían en RAM, el coordinador resultaba poco escalable, y en esa época no había tanta memoria disponible; llegaba un punto en que no entraba una tabla más y el sistema dejaba de funcionar. En Colossus, aparentemente, el coordinador está shardeado: probablemente el file system entero esté particionado en regiones de archivos, cada una con su propio coordinador, de manera que también él escale horizontalmente.
El tercero es la consistencia débil que ya nombramos, la de no tener write atómico. Para procesos batch se puede convivir con eso, con los IDs únicos y los checksums. Pero apenas se quiere construir encima algo más sofisticado, una base de datos, un key-value store, resulta mucho más costoso no poder confiar en si un write se duplicó o no.
El cuarto es consecuencia de lo anterior, aunque en rigor es un problema aparte, y también lo evita Raft: los stale secondaries, las réplicas desactualizadas. Se particiona la red y queda un secondary suelto de un lado, con un cliente que lo tiene cacheado y sigue leyendo de él. Aunque no haya split brain, el resto del sistema siguió avanzando y ese cliente está leyendo de un secondary viejo, sin los últimos updates, y desde esa subred aislada no hay una forma sencilla de detectarlo. Es un problema breve, que eventualmente se resuelve por sí solo, pero mientras dura es realmente serio.
Todos esos problemas de consistencia débil —el coordinador centralizado ya es otro tema— los resuelve Raft, corriendo la carga de lugar. Raft nos provee, en principio, consistencia fuerte: writes atómicos y una forma de leer sabiendo que lo que leímos es lo más actualizado que hay, además de variaciones que permiten leer información no tan actualizada a cambio de más performance. Pero lo que cambia de fondo es que todo aquello de lo que aquí tenía que ocuparse el cliente —detectar los duplicados, saltear los agujeros, desconfiar de la réplica que le corresponda— pasa a estar del lado del sistema. Esa es la diferencia entre consistencia débil y consistencia fuerte: no cuántas garantías se ofrecen, sino de qué lado de la interfaz queda quien debe hacerse cargo del desorden.