1. Lecturas desde los followers
Hoy vamos a hablar de consistencia y, en particular, de la conocida consistencia eventual, un término que ganó difusión a partir de la aparición de las bases NoSQL. La razón de traerlo ahora es que no constituye un tema separado de lo que venimos viendo: se manifiesta de manera muy concreta si uno lee de cierta forma en un cluster de Raft, y también en Zookeeper, el tema principal de esta clase.
El punto de partida ya está asentado: después de unas tres horas dedicadas a la importancia de escribir siempre en el líder, sabemos que una escritura no tiene sentido en un nodo que no lo es. Lo que no discutimos tanto, aunque el paper lo menciona, es qué ocurre si de todos modos le enviamos un request de escritura a un follower. El paper es preciso: el nodo lo rechaza y le devuelve al cliente la información del líder más reciente del que tenga noticias, y el cliente reintenta contra ese. No reenvía el pedido; indica a quién había que dirigirse. Eso explica por qué consultar a cualquier follower es una buena forma de averiguar quién es el líder: la dirección del líder viaja en cada AppendEntries. Y si hay una partición y estamos del lado de la minoría, la operación no va a funcionar: el escritor siempre tiene que alcanzar al líder, de modo que obtendremos un error y lo intentaremos nuevamente cuando la red se restablezca.
Con las lecturas la situación es distinta. O, más precisamente: en principio no era distinta, porque también deberían pasar por el líder, pero existe la tentación de leer de los followers. ¿Por qué? Porque hay varios sistemas —y Zookeeper es uno de ellos— donde las lecturas y las escrituras no están balanceadas: casi siempre hay muchas más lecturas. Y si tenemos un cluster de cinco máquinas, o de siete, sería deseable aprovechar la capacidad de todas; no solamente obtener más disponibilidad, sino más throughput de lecturas. Con todo el tráfico pasando por el líder no ganamos nada al agregar máquinas, porque siempre persiste el mismo cuello de botella. Pero podríamos leer de los followers: veamos qué ocurriría.
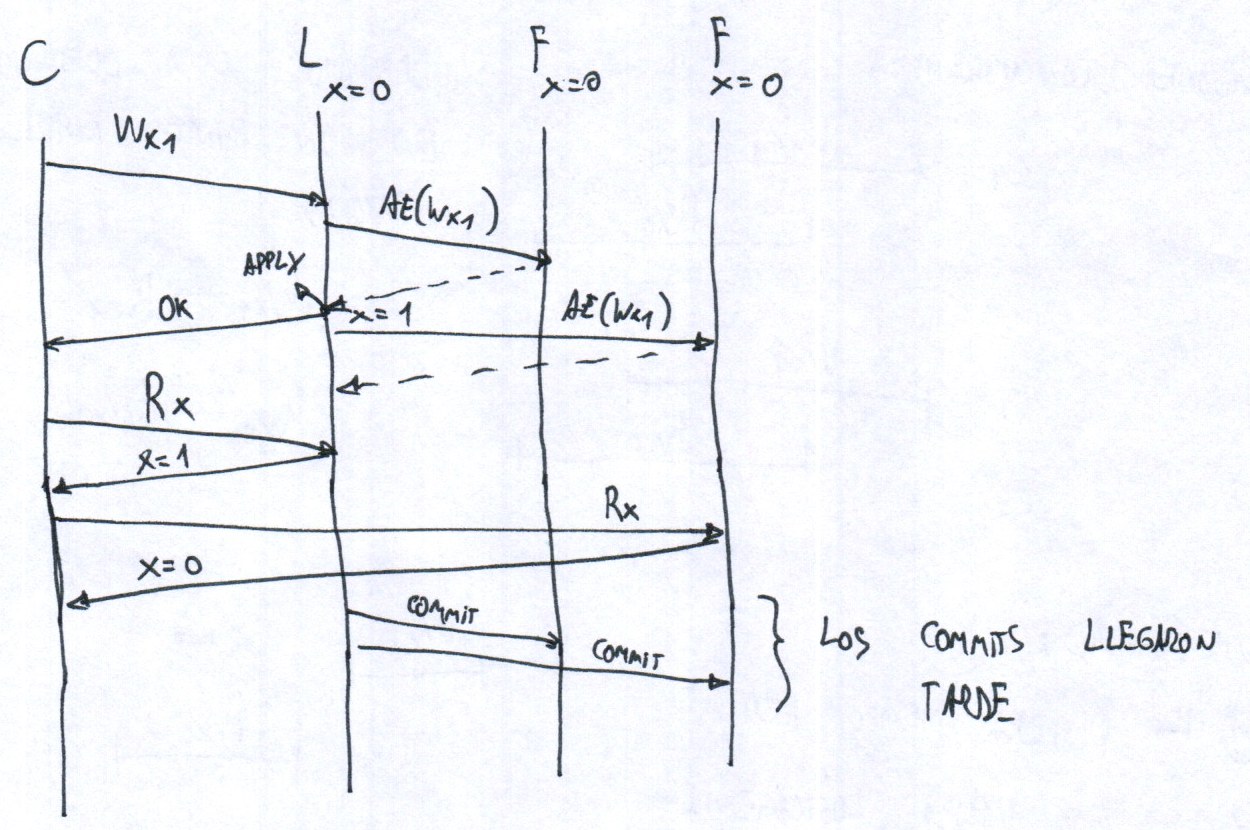
Hagamos algunos diagramas. Supongamos un cliente, un líder y dos followers, los tres servidores comenzando con x = 0. El cliente envía una escritura, que necesariamente llega al líder: la anotamos como siempre, Wx1. El líder realiza —y sirve de repaso— un AppendEntries con ese comando a un follower y también al otro. Supongamos que el primero ya respondió, y que luego el líder le envía el otro AppendEntries al segundo, que eventualmente también responde.
Allí ocurren varias cosas. En cuanto le responde un follower, el líder ya puede responderle al cliente, porque con eso tiene mayoría: lo comiteó localmente. Ese x = 1 está comiteado y visible en el líder, y en los dos followers todavía no. Eso es lo importante del diagrama y resulta fácil de pasar por alto: no ocurrieron los commits en los followers.
Si el cliente hiciera ahora una lectura dirigida al líder, obtendría la información correcta, x = 1: no hay nada anómalo, porque consultamos al líder.
Extendamos el diagrama, aclarando que estamos retrasando los commits intencionalmente. El problema ocurre cuando el cliente lee dirigiéndose directamente a un follower: le envía un Rx y el follower le responde el valor anterior, x = 0, porque nunca vio la escritura previa. No la vio porque el aviso de commit llega tarde: solo cuando el líder, en otra operación posterior, le envía una escritura nueva, aprovecha ese AppendEntries para informarle el commit del anterior. A partir de ese momento cada follower ve la escritura que le faltaba. El riesgo de leer de los nodos que no son líderes es ese: podemos ver información desactualizada porque los commits llegaron tarde.
Hay otro tipo de diagrama que vamos a usar durante toda la clase: el que muestra qué observa el cliente, y se llama historia de ejecución. La historia del cliente uno comienza con esa escritura, y el segmento que la representa significa algo preciso: el extremo izquierdo es el momento en que envió el request y el derecho aquel en que recibió el response. Equivale a mirar el diagrama anterior en horizontal. Siguiendo la misma línea de tiempo, después vino la lectura dirigida al líder, que resultó correcta: Rx1. Y luego la tercera operación, donde la situación se complica: otra lectura que recibió Rx0. No solamente escribió un valor y al final obtuvo el anterior: primero obtuvo el correcto y después el incorrecto.
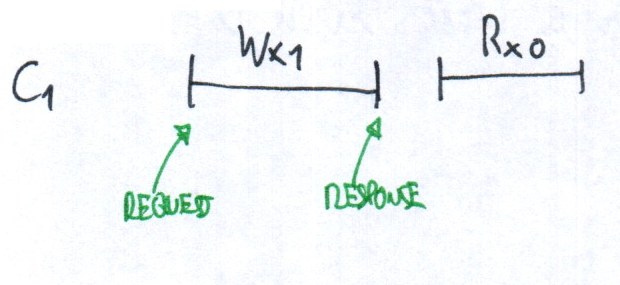
Eso ocurre, como sabemos por el funcionamiento de Raft, porque hay múltiples réplicas: si dos lecturas dieron resultados diferentes, es porque nos dirigimos a máquinas distintas. Y si el sistema continúa funcionando correctamente, eventualmente la situación se restablece: si leyéramos más adelante, obtendríamos siempre el valor que corresponde, y a partir de ahí se estabiliza.
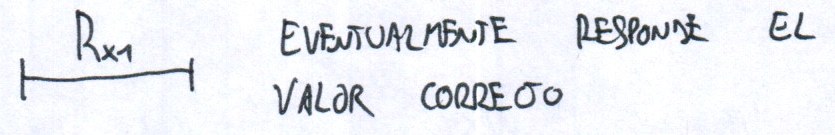
Eso es lo que se denomina, informalmente, consistencia eventual. Y si lo razonamos ahora que conocemos Raft, se advierte que no es una feature ni algo que uno elija: es una consecuencia de la replicación y de querer relajar los accesos para obtener más performance. El cliente se dirige a un follower porque queremos aprovechar que están menos cargados: hacemos balanceo de carga y leemos valores distintos.
Algunos sistemas pueden tolerar eso y otros no. Por eso ganó tanta difusión: son sistemas resilientes, que funcionan bien y no se caen, y en los que podemos admitirla. El ejemplo típico es un posteo en Instagram: como máximo se pretende que, al hacer refresh, aparezca el propio; el resto de los usuarios no sabe en qué momento se publicó, y basta con que eventualmente aparezca.
¿Y cuánto significa “eventual”? Tampoco existe un límite formal, pero implícitamente debería tratarse de segundos; una consistencia eventual de un día carece de utilidad. La de Raft, DynamoDB, Cassandra y sistemas similares es, en el peor de los casos, de segundos. Puede presentar demoras cuando la red funciona mal o hubo particiones, pero en funcionamiento normal tarda un instante y el valor aparece.
Nos va a afectar principalmente porque vamos a encontrar estas historias inconsistentes: escribimos, leemos enseguida un valor y después otro, y obtenemos resultados diferentes. Cuando un algoritmo realiza todo eso a la velocidad de una computadora, puede quedar incorrecto, porque leyó valores en distinto orden. En general la eventualidad no representa un problema por demorar mucho, sino porque el orden en que ocurren las cosas es impredecible.
Consistencia eventual significa, entonces, que eventualmente el sistema responde el valor que corresponde. Pero más interesante que definir eso es definir con precisión lo contrario.