4. Multiversion concurrency control
En esta sección
Timestamp ordering y MVCC
Para ver cómo lo lograron conviene arrancar por un repaso de una técnica que ya conocemos: timestamp ordering, la que usaba DynamoDB. Esta es, básicamente, la parte interesante del paper.
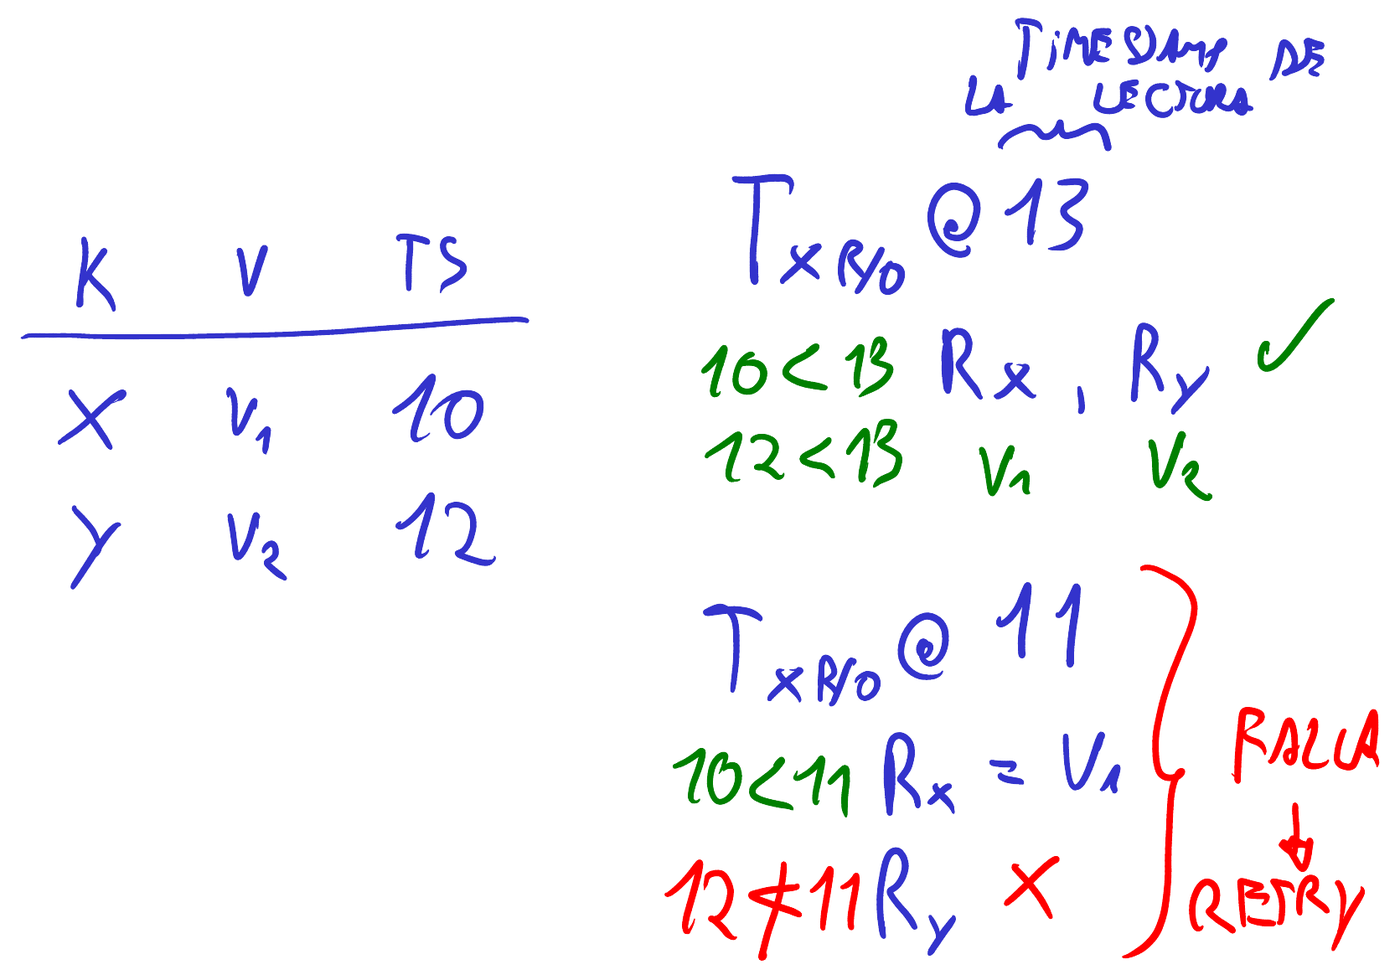
Imaginemos la tabla. Tiene claves, valores, y además, en cada fila, el time: el momento en que se escribió ese valor. Llamemos a los valores valor uno y valor dos. Tenemos la clave x, con el valor uno, escrito en el 10; y la clave y, con el valor dos, escrito en el 12.
Nos llega una lectura: transacción read-only at 13. Esa notación con el at la vamos a usar de aquí en adelante, e indica el timestamp de la lectura. Eso es lo propio de timestamp ordering: cuando mandamos una lectura, le ponemos su timestamp.
El mecanismo es leer lo que queremos —un read de x, después un read de y— y, en cada caso, fijarnos si esos valores están en el pasado respecto del timestamp de la lectura. Leemos en el 13, y las escrituras ocurrieron en el 10 y el 12, así que está todo bien: el read de x da el valor uno y el de y el valor dos.
El problema, en timestamp ordering, aparecía cuando la lectura caía en el medio. Pongamos una read-only at 11, entre las dos escrituras. Leemos x: el 10 está en el pasado, así que nos da el valor uno. Pero después leemos y, y ese valor está en el futuro: no lo podemos leer. Y no falla solo esa lectura: falla la transacción entera. Hay que abortarla y hacer un retry más en el futuro, quizás ya en el timestamp 18, porque el tiempo sigue avanzando, y ahí sí se puede leer correctamente.
Una pregunta natural: ¿cómo sabe el retry qué timestamp pedir? No hay misterio: el cliente manda la nueva transacción con el timestamp actual, y por eso el retry ocurre en el 18, porque su reloj sigue funcionando. La única forma de no conseguirlo es que estén constantemente escribiendo esos mismos valores, metiéndose siempre en el medio; pero eventualmente vamos a estar lo suficientemente en el futuro como para que esas escrituras queden viejas.
Y se cuela una segunda pregunta, que de entrada suena sospechosa: ¿leer cosas anteriores al timestamp propio no trae problemas? No, ninguno; es justamente el objetivo. Lo que no podemos hacer es leer cosas en el futuro.
¿Por qué no se pudo leer el segundo valor? Por la comparación de los números, y la aritmética merece quedar escrita, porque es toda la regla. En el primer caso, 10 es menor que 13, y 12 es menor que 13, y por eso funcionó. En el segundo, 10 es menor que 11, pero 12 no es menor que 11, y ahí viene el problema.
En ese caso trasladamos el problema al cliente: lo obligamos a reintentar. Pero se le puede ahorrar el problema, y ahí entra multiversion concurrency control, MVCC.
La idea clave es esta. Antes teníamos clave, valor y timestamp. Ahora vamos a poner la clave y el timestamp juntos, como índice, y el valor aparte. Y ahí vamos a guardar todas las versiones —no necesariamente todas, pero imaginemos por ahora que sí.
Imaginemos que x, en el time 10, tenía un cierto valor; que y, en el 9, valía el valor dos; y que y, en el 12, valía otra cosa. Multiversion, justamente, porque guardamos varias versiones del row.
Nos llega una read-only en el tiempo 11, que lee x y lee y. Lo interesante es y, porque tenemos dos versiones: una está en el futuro respecto del timestamp de la lectura, y la otra en el pasado. La que queremos leer es la del pasado.
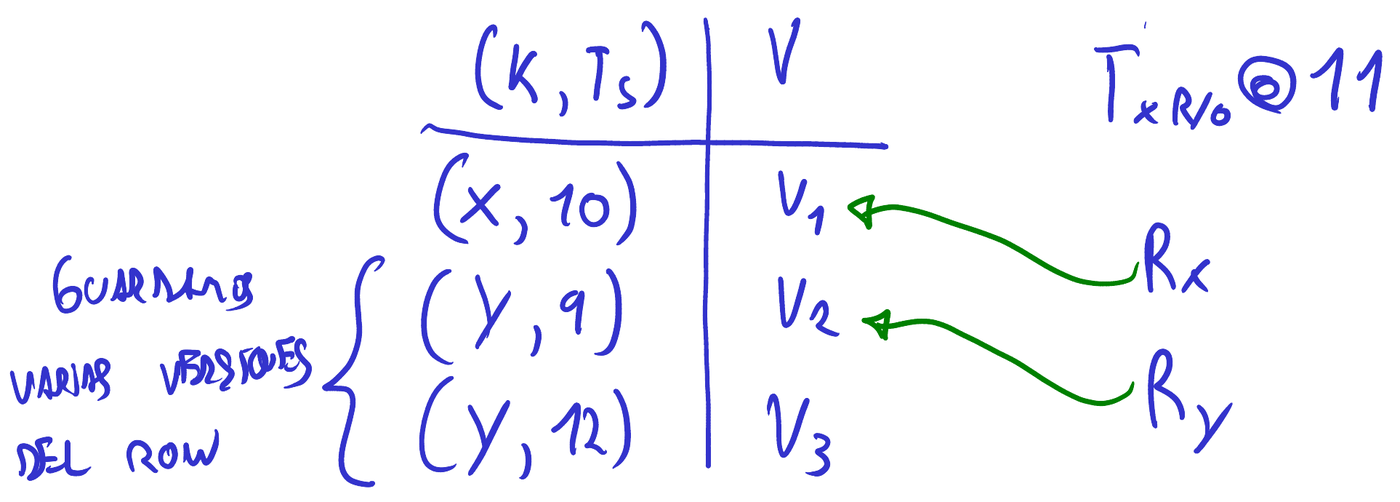
Esa es toda la diferencia: en vez de abortar la transacción y hacer un retry, como hacíamos antes, siempre vamos a poder leer. Si guardamos las versiones del pasado, siempre podemos viajar hacia atrás y encontrar el snapshot que queremos. Si una escritura ocurrió en el 10 y la otra en el 9, un snapshot en el 11 lee esos dos valores, y así funciona.
Y lo importante es lo que no pasó: en ningún momento tuvimos que tomar ningún lock. Vamos, buscamos la versión que corresponde y la leemos. Este método no usa locks, y es una idea fácil de entender, sobre todo comparada con el aparato de locking del otro lado.
Esto mismo se usa en las bases relacionales, en Postgres o MySQL. Esas bases no guardan todas las versiones del pasado: pueden tener muchas transacciones a la vez, y mientras estas modifican rows, van guardando las versiones viejas. Cuando una transacción termina, se puede liberar un valor viejo que ya no se va a usar. Se usa muchísimo en la vida real.
No resuelve todo, eso sí: para las escrituras se siguen necesitando locks. Pero para las de solo lectura funciona.
Y aquí está la diferencia de Spanner. Postgres guarda la mínima cantidad de versiones necesarias, porque si no se le acumularían muchísimas; Spanner las conserva mucho más allá, bastante atrás en el tiempo. Eso le permite, además del snapshot consistente, algo que el paper llama snapshot read: uno le dice directamente el timestamp en el que quiere leer. Puede rebobinar en el tiempo: en vez del timestamp actual le pone el de ayer, y ve el estado de la base de ayer, lo cual es bastante poderoso. Con suficientes discos para guardar las versiones, funciona directamente.
Réplicas desactualizadas y safe time
El problema de todo esto van a ser los relojes, pero antes hay una cuestión que quizás a alguno ya se le ocurrió, porque lo difícil de este sistema es que combina muchas piezas entre sí.
Todas estas versiones funcionan sobre Paxos —o Raft, si ayuda pensarlo así—. Y si siempre leemos la copia local, sin ir al líder, puede que esa copia esté desactualizada.
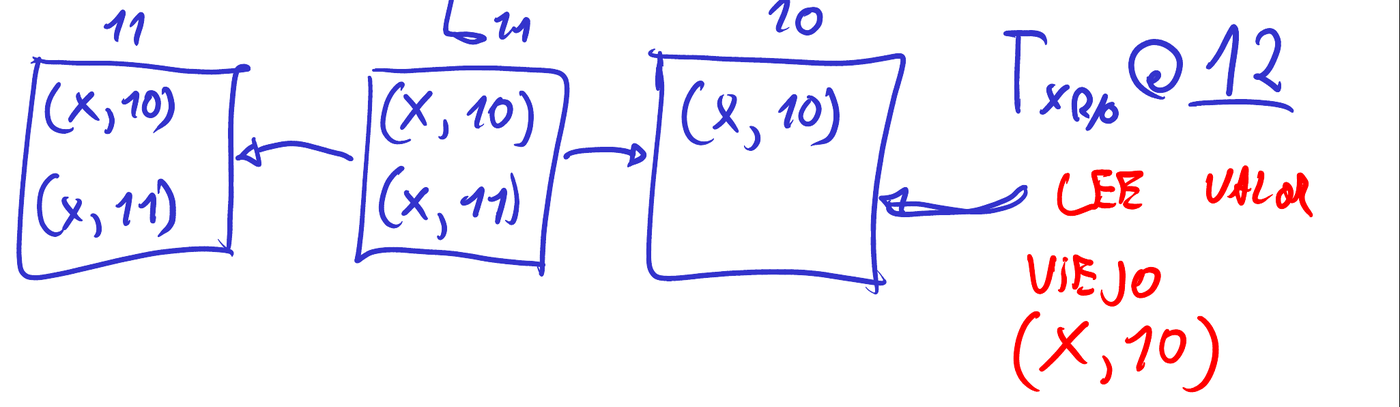
Bajemos al nivel de las réplicas. Tenemos las tres réplicas del grupo, una es el líder. Imaginemos que tienen x en el 10 y también una versión de x en un timestamp posterior. El primer valor está en todas, porque está actualizado. El otro falta en una de ellas, porque todavía no se terminó de propagar: con que haya respondido un quórum, el sistema ya dio la escritura por confirmada.
Hagamos el ejemplo con una read-only en el timestamp 12. Si leemos de la réplica atrasada, vamos a leer el valor viejo cuando tendríamos que leer el otro, simplemente porque Paxos no lo mandó todavía. Vamos a hacer, sin querer, una lectura del pasado, violando la linealizabilidad en un sistema en el que buscábamos la consistencia más fuerte posible.
Eso hay que solucionarlo, porque nosotros mismos dijimos que no puede pasar.
Para eso Google agregó un concepto llamado safe time, un mecanismo que se parece bastante a cómo se hacían los deletes en DynamoDB.
Parte de la observación de que los timestamps son siempre ascendentes. Cada réplica puede guardar el valor más reciente de lo que le llegó: 11 una, 11 otra, 10 la tercera. Y el safe time consiste en esperar: si queremos leer en el 12, esperamos a que llegue algo más grande que 12, porque eso garantiza que no nos va a llegar ninguna información del pasado.
En el caso concreto, la réplica tiene safe time 10: tiene todo actualizado hasta el 10. La transacción se queda esperando hasta que llegue algo mayor que 12. Eventualmente ocurren otras escrituras y llega, por ejemplo, un 13, porque se actualizó otra clave: y = 13. La réplica pasa a tener todo hasta el 13, y ya podemos leer, porque cuando llegó eso también tenía que haber llegado el x = 11.
Dicho todo junto, el mecanismo agrega una espera hasta que se actualiza la réplica. Si nos llegó una transacción con timestamp mayor que 12, tenemos la garantía de tener todo lo anterior al 12.
Conviene repetirlo desde otro ángulo, porque puede no quedar claro en una primera lectura. Primero: Paxos garantiza que los timestamps con que se guardan las cosas sean siempre ascendentes. No puede aparecer un y = 9 en una réplica que ya guardó el 10 y el 11, y no porque Paxos lo rechace al llegar: ese write ni siquiera se propone. Los timestamps de los writes los asigna el líder del grupo, y los asigna siempre crecientes, incluso cuando el liderazgo pasa de una réplica a otra. Los timestamps de lo que se escribe tienen que ser siempre una función monótona ascendente.
Segundo, la consecuencia. Si en esta réplica el timestamp más grande es 10, probablemente esté desactualizada y le falten cosas. Pero si encuentro cualquier otra clave con timestamp 20, por ejemplo, quiere decir que Paxos ya mandó el log que contiene el 20 y con él todo lo anterior. Es una garantía que da Paxos a nivel de la replicación.
El paper define el safe time en su sección 4.1.3 como el mínimo entre dos componentes. El que se explica aquí es el de Paxos, que es el timestamp del write aplicado más alto; el otro corresponde al transaction manager y tiene que ver con las transacciones que ya pasaron por el prepare y todavía no hicieron commit, porque una transacción en ese estado impide que el safe time avance. La condición para servir una lectura es que su timestamp sea menor o igual al safe time.
La lectura espera, entonces, que llegue cualquier cosa con un número mayor al que queremos leer, porque eso garantiza que todo lo del medio ya está, incluido el valor más actualizado. Es introducir una espera adicional: si lo que queremos leer todavía no tiene un valor más grande que ese timestamp, esperamos a que llegue uno, y eso nos garantiza que la réplica está actualizada. Requiere pensarlo con cuidado, pero dicho de la forma más directa: la lectura no se resuelve hasta que entre algo mayor a 12, de cualquier clave, y en ese momento funciona.
Normalmente no hay que esperar mucho, porque llegan escrituras constantemente y las réplicas se actualizan rápido. En el caso típico la espera es corta.
Pero hay un detalle que nos lleva al tema siguiente. Si una máquina genera mal el timestamp y en vez de 12 pone, digamos, 400, esa transacción se queda esperando larguísimo hasta que avance el log: tiene un reloj en el futuro, mientras todo el mundo sabe que estamos por el 10, 11 o 12. (Los números chicos son para ejemplificar; los timestamps reales son muchísimos dígitos.) En teoría la lectura queda colgada hasta que lleguen los datos.
Por eso se hace un gran esfuerzo para que los relojes de todas las máquinas estén lo más sincronizados posible, y es una de las innovaciones de Google. Si hay diferencias, son de milisegundos. Eso hace que el safe time —esperar alguna transacción con timestamp mayor al de la lectura— sea barato: se espera unos pocos milisegundos, no un minuto, que indicaría relojes muy desincronizados.