3. Quórums
En esta sección
Intersección de quórums
Todo lo que venimos mirando es casi un caso particular de algo más general: los quórums. La palabra viene del latín, igual que el quórum del Senado: tomamos prestado el nombre y nada más. Los quórums distribuidos son una generalización del concepto de mayoría, y en qué sentido lo son se entiende mejor mirando la propiedad que justifica la palabra.
Volvamos a los cinco nodos de siempre, con el quórum de lectura y el de escritura valiendo tres —el quórum de este sistema es tres, aunque bien podría ser otro número—. Digamos que el quórum es igual que la mayoría, y dejemos de lado las particiones por un momento, porque la particularidad interesante de esa configuración es otra.
Si encerramos tres de esos nodos en un círculo, eso es un quórum, por definición. Elijamos ahora otro cualquiera, también de tres. La propiedad principal es esta: dos quórums tienen al menos un elemento en común. Asociando quórum a mayoría: dos mayorías siempre contienen un nodo en común. Es casi evidente, y aun así vale la pena detenerse en ello. No hace falta que sean grupos dibujados cerca uno del otro: podemos comparar el primer grupo de tres contra cualquier otro elegido lo más lejos posible, y también van a compartir un elemento. Con cinco nodos y grupos de tres no hay lugar para construir dos que no se solapen.
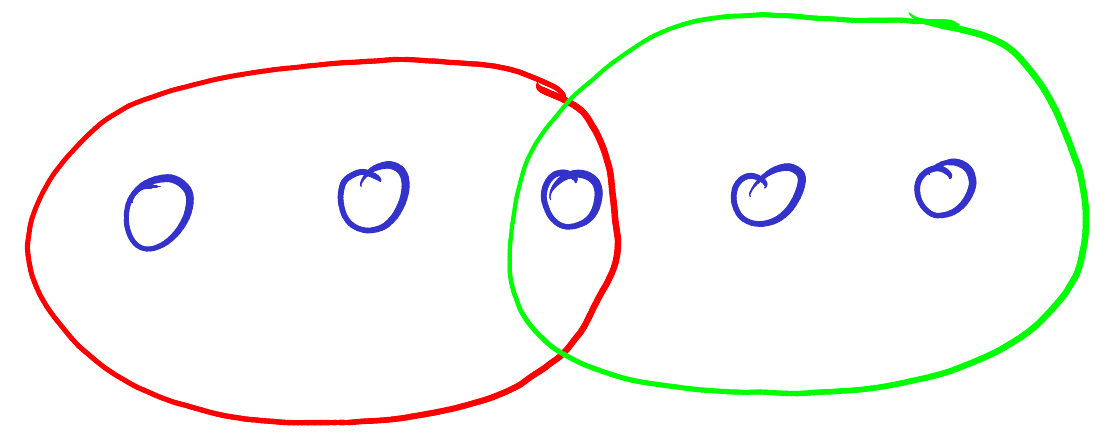
De ahí sale el corolario que nos interesa: toda mayoría tiene un servidor actualizado, si la escritura fue en mayoría. Se desarma mejor con la misma escena vista desde el lado de los clientes.
Tenemos los cinco nodos y un cliente, C1, que le envía la escritura Wx1 a tres de ellos; le respondió OK una mayoría, no las cinco. Después viene otro cliente, C2, que quiere leer. Le envía Rx a un nodo, y de ahí puede obtener cualquier valor, porque nada garantiza que esté actualizado: bien puede ser uno de los dos que quedaron fuera de la escritura. Le envía Rx a otro, y a un tercero, y entre esos tres va a obtener el valor que corresponde. Si leyó tres nodos, tiene la garantía de que uno le va a devolver un valor actualizado, y esa garantía no depende de la suerte: sale de la propiedad de la intersección.
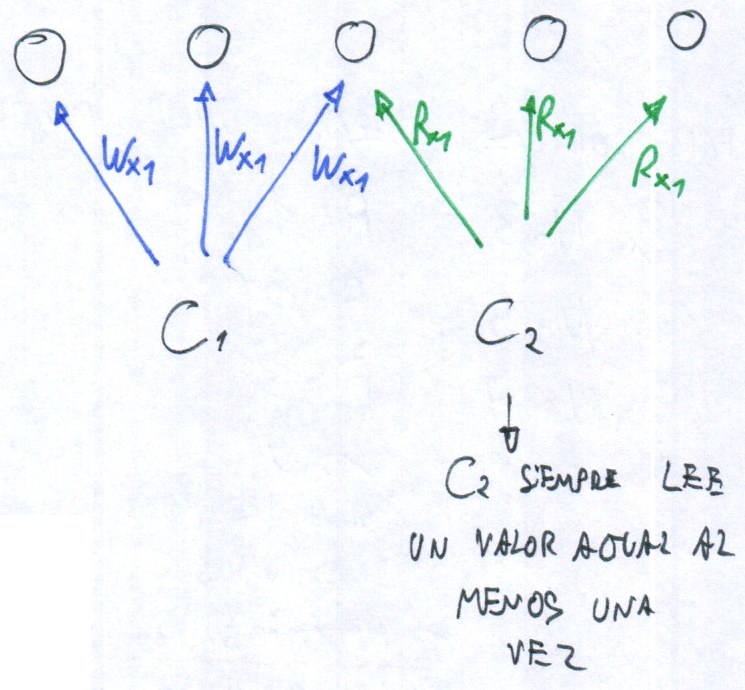
Queda abierta otra cuestión, que Raft resuelve de una forma particular: cómo sabe C2 cuál de esos tres es el actualizado. Hace falta algún mecanismo de versión, y ese es un tema aparte. Lo importante es que entre las tres lecturas, sin importar cómo elija los nodos, al menos una tenía la versión más actualizada, simplemente porque la escritura fue a tres.
Pongámosle nombres: el quórum de lectura —anotado R— es tres, el de escritura —W— también, y N sigue siendo cinco, la cantidad de nodos que tenemos.
Ahora la generalización, que no vamos a usar en Raft pero conviene tener vista: los quorum systems. Esos tres valores tienen que respetar una fórmula, W + R > N, que en el ejemplo de arriba se cumple: 3 + 3 es 6, y N es 5. Eso permite diseñar sistemas más flexibles. Si quisiéramos leer de dos máquinas, escribir en tres ya no alcanza: puede pasar que las dos que leímos no tengan la versión actualizada. Y la fórmula lo dice antes de que lo veamos en el dibujo, porque 3 más 2 es 5, y 5 no es mayor que 5. Va a haber que escribir en una máquina más: R = 2, W = 4, N igual a cinco, y ahora la suma da 6.
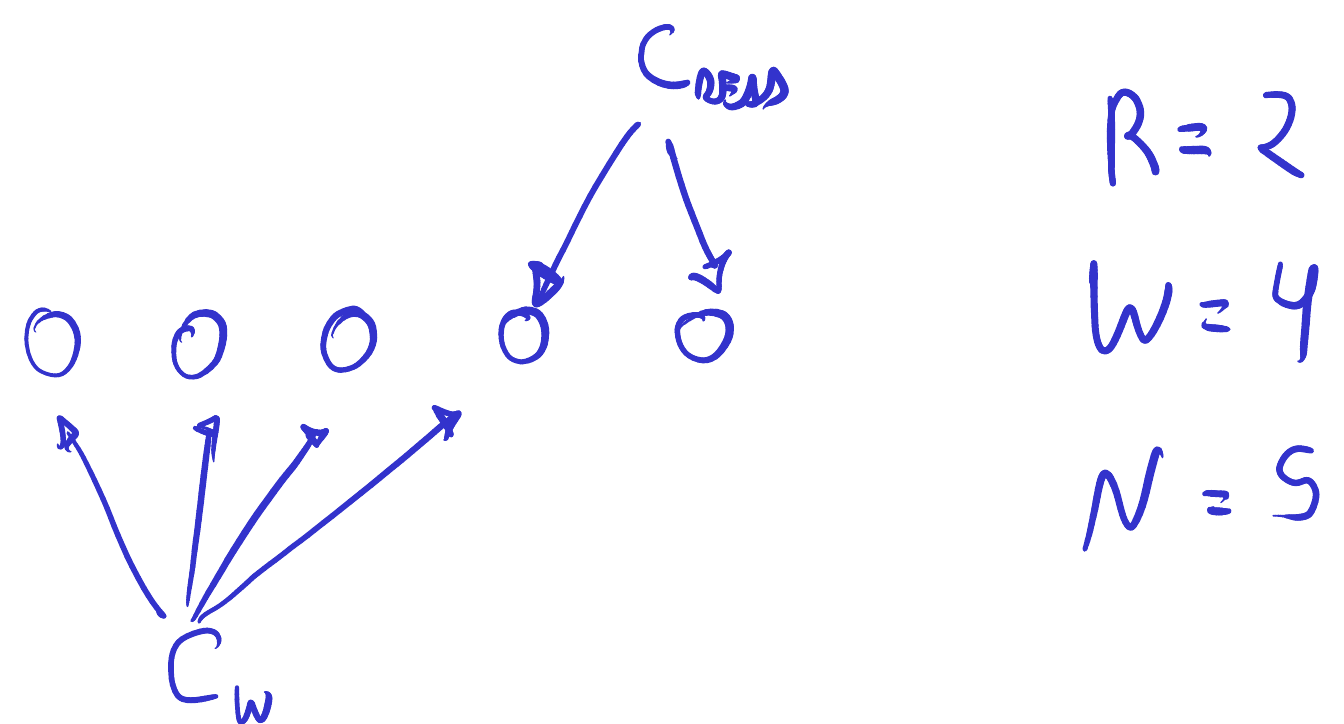
El caso extremo cierra la escala. Si solo queremos leer de una máquina y saber que está actualizada, la escritura tiene que ser en los cinco nodos: con R = 1, el único W que hace pasar la suma de cinco es cinco. Y eso coincide con la intuición: si quiero leer de un solo lugar y que lo que lea esté actualizado, escribo en todos, y si no pude escribir en todos, la operación falla, porque siempre puede aparecer alguien que lea justamente el nodo que quedó fuera.
W + R > Nes la condición que garantiza que toda lectura toque al menos un nodo actualizado, que es el corolario que nos interesa aquí. El paper que originó estos sistemas —Weighted Voting for Replicated Data, de David Gifford, SOSP 1979— enuncia dos condiciones y no una: además pide que2W > N, que es la que hace que dos escrituras concurrentes se intersequen y queden ordenadas. Sin ella, un sistema conW = 1yR = 5cumpliría la primera fórmula y aun así admitiría escrituras simultáneas sin orden entre sí. Los tres casos de arriba cumplen las dos condiciones, y el que usa Raft,W = R = M, las cumple siempre.
Esto es también una forma de replicación de la que no habíamos hablado y que está embebida dentro del protocolo de Raft, aunque no aparezca con ese nombre: la replicación por quórum.
En el caso de Raft no vamos a usar nada inusual: vamos a usar mayoría. Tenemos el caso particular en que W = R = M, con M la mayoría. Y hace falta una consideración adicional para que todo funcione bien: N impar. Con esos tres elementos podemos construir un sistema sólido, que combina dos propiedades.
Principio de funcionamiento de los algoritmos de consenso
Las dos propiedades valen cada una por separado. La primera: frente a fallas de nodos o a particiones de red —si fallan todos, el sistema no puede operar— siempre queda una partición con mayoría, y eso viene simplemente de que la cantidad de nodos es impar.
Lo que no dijimos es el contraejemplo, que vuelve evidente la necesidad de ese número impar. Con N = 4 la mayoría es tres, y la red se puede particionar justo por el medio, dejando dos nodos de cada lado: ahí no sirve ninguna de las dos mitades.
Y el número impar no es una superstición de ingenieros: la cuarta máquina no aporta nada. Con tres nodos la mayoría es dos y el sistema tolera que se caiga uno. Con cuatro, la mayoría pasa a ser tres, así que sigue tolerando que se caiga uno solo. Se paga un 33 % más de hardware por exactamente cero tolerancia adicional, y además se abre el corte 2-2 que antes no existía.
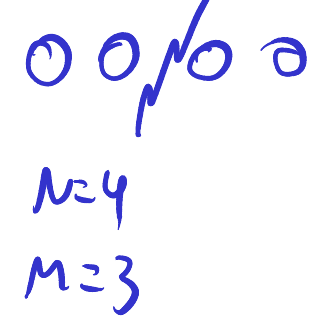
¿Puede pasar que haya más de una partición y que no quede ninguna mayoría? Puede, y eso Raft no lo toleraría; aunque depende de cómo se particione la red. Con cinco nodos, si los dos cortes dejan a un grupo con mayoría, ese grupo va a poder seguir operando; si caen de otra forma, ninguno va a poder, y el sistema se bloquea hasta que se restablezca la conectividad. Lo importante es que Raft no va a comportarse incorrectamente: ninguno de los tres grupos va a poder elegir líder ni avanzar. Una partición está garantizado que la tolera; dos, depende.
Y hay un caso todavía más incómodo, aunque sea al margen. En todo esto asumimos que la partición es bidireccional. Imaginemos que un cliente puede enviarle un mensaje a una máquina pero la respuesta no puede volver. Ahí la situación es ambigua, y esos casos se asumen inexistentes en Raft: una partición es siempre, y en los dos sentidos, “yo no puedo comunicarme con el otro y el otro no puede comunicarse conmigo”. Si fuera en un solo sentido, el caso es dudoso, y probablemente Raft no funcione.
La segunda propiedad es igual de interesante, y es lo que van a resolver todos los algoritmos de consenso: la partición mayoritaria tiene al menos un nodo actualizado. En la combinación de esas dos propiedades se basa Raft.
Volvamos al ejemplo de la elección de líder. Si son tres nodos y la red se particiona por la mitad, y además de elegir líder hacemos las escrituras esperando que nos avise una mayoría, entonces no solo esa mitad pudo elegir líder: además algún nodo dentro de ella está actualizado.
Y eso no es menor: ese nodo es el que vamos a usar para restaurar todo el sistema. Lo problemático sería lo contrario, haber podido elegir líder en la mitad grande y que el nodo más actualizado —aquel por el cual ya le dijimos OK al cliente— haya quedado del otro lado del corte. Estos algoritmos funcionan si la mitad que sigue funcionando tiene la información que necesitamos.
De ahí que la mayoría aparezca en dos lugares distintos: cuando se eligen los líderes y cuando se escriben datos. En ambos casos vamos a requerir mayoría de respuestas, por razones distintas, y todo se combina muy elegantemente.
Esa manera de encajar es también la razón por la que los algoritmos distribuidos son difíciles. Son un rompecabezas que se entiende entero cuando todas las piezas encajan, y de ahí surgen todas las propiedades. Uno plantea un escenario problemático, y la respuesta es que el algoritmo prevé otra acción que vuelve ese caso imposible; después plantea otro, y aparece otra parte del algoritmo que también lo evita. Por eso conviene subrayar este paper y leerlo varias veces: es, en ese sentido, el más difícil de todos. Va a haber muchos momentos en que uno piense que el algoritmo está mal, y después entienda por qué sí funciona. El caso feliz, que viene ahora, es muy sencillo; los de falla son los complicados.
Cantidad de fallas tolerables
Todo esto es para tolerar fallas, así que corresponde preguntarse cuál es la tolerancia que obtenemos. Pensando en nodos individuales que fallan, lo que vamos a tolerar es que falle a lo sumo una minoría.
Los números son directos. Con N = 3 puede fallar a lo sumo un nodo: la mayoría es dos, entonces la minoría es uno. Si de tres fallan dos, ya no podemos avanzar, y la situación es parecida a una partición de red. Con cinco toleramos dos fallas; con siete, tres.
La cantidad de fallas que queremos tolerar define, entonces, cuántos nodos queremos. Y cuantas más queramos tolerar, más costosa se vuelve la solución por dos lados. Por un lado hay que disponer siete máquinas para tolerar tres fallas: un 133 % más de hardware que las tres con las que se tolera una. Por el otro, con siete el algoritmo tiene que intercambiar muchos más mensajes: la mayoría es cuatro, así que cada escritura pasa de esperar dos respuestas sobre tres a esperar cuatro sobre siete. Se duplica el hardware y se duplica la cantidad de máquinas que deben participar de cada operación, todo para pasar de tolerar una falla a tolerar tres.
Lo que más se ve en la práctica es N = 3, y N = 5 en algunos casos muy importantes. Sistemas con siete nodos prácticamente no se ven.