2. Consistent hashing
En esta sección
put, get y orden parcial por clave
Si no hay SQL, la pregunta inmediata es cuál es la interfaz con Dynamo. En una versión simplificada —la real es un poco más complicada— las operaciones son dos: put(key, value) y get(key). Se escribe un valor bajo una clave, y se lee el valor de una clave. Eso es todo.
De ahí sale que Dynamo, y muchas de estas bases NoSQL aunque no todas, tienen semántica de key-value store: semántica de hash: una clave y un valor. No hay más estructura que esa.
La atomicidad está garantizada al nivel de cada par de clave y valor: cuando se escribe el valor, el sistema no lo va a escribir por la mitad. El value puede ser una cadena de bytes; esos bytes van a estar ahí y van a ser durables, y con eso el sistema cumple. Pero la garantía termina justo en ese borde. Si dentro de un mismo request —el que hace el usuario contra el servidor web, por ejemplo— se quieren hacer varios put a la vez, por ejemplo modificar el carrito y el saldo al mismo tiempo, cada uno de esos put es individual. No hay nada que los agrupe: pueden fallar algunos y no otros, y es responsabilidad de quien programa reintentar los que fallaron.
Una semántica tan limitada es lo que facilita la distribución, y el que hace el trabajo es ese borde. Hay un par de propiedades que se vuelven mucho más simples si uno saca de la cabeza todo el modelo relacional.
La primera ventaja es que resulta fácil de particionar, porque por definición del sistema no existe ninguna relación entre claves. Dynamo ni siquiera tenía el concepto de tablas adentro: era una bolsa de claves. Nunca hay que hacer joins, nunca hay que combinar lo que está en una partición con lo que está en otra. Y ahí es donde están las cosas difíciles: combinar datos que viven en particiones distintas es exactamente donde se complica el asunto. Con esta interfaz, las operaciones nunca tienen que cruzar shards: va a haber muchos shards, cada uno con algunas claves adentro, y nunca va a hacer falta una operación que le pregunte claves a otro para combinarlas con las propias. Cada shard se transforma en una pequeña base de datos independiente.
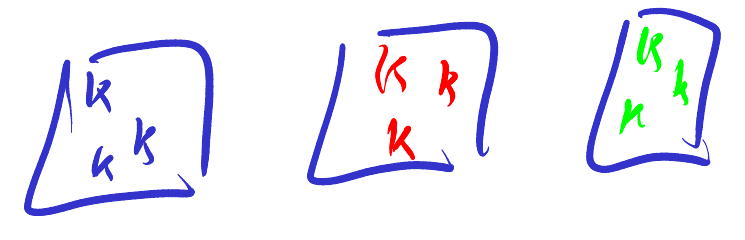
Nada de esto es tan obvio como suena. Si quisiéramos hacer un join, ahí sí habría que tomar una cantidad grande de claves y combinarlas con otra igual de grande, y las máquinas se tendrían que pasar información entre sí. Y eso es, precisamente, lo que se hace con MapReduce: el sistema le traslada ese problema al programador. Quien necesite ese tipo de combinaciones puede usar MapReduce para armarlas, pero la base no se las va a resolver. A cambio, particionar se vuelve muchísimo más fácil.
La otra ventaja es la que va a ser el tema grande de esta clase. Si cada clave es una entidad independiente de todo el resto, ya no estamos tan interesados en tener un orden total en el sistema. Raft se basa en que hay un log de las operaciones, ese log se replica en todos lados, todo el mundo ve el mismo log y termina aplicando las mismas operaciones en el mismo orden. Pero si cada clave no se va a relacionar con otras, lo que importa no es el orden total sino el orden de cada clave individual: que se la cree antes de modificarla y antes de eliminarla, y que esas tres operaciones lleguen en el mismo orden a todo el mundo. El orden respecto del resto de las operaciones no importa.
Así el requisito se reduce muchísimo. Raft mantiene un log, que es un orden total; esto lo simplifica a un orden parcial, el orden de las operaciones sobre cada clave individual. Y eso repercute en que no hace falta coordinar tanto entre los distintos shards: no hay que hacer un Raft entre ellos.
Consistent hashing y nodos virtuales
El mecanismo con el que Dynamo reparte las claves entre los nodos es consistent hashing, y vale tratarlo como repaso: suele verse en otras materias, en programación concurrente por ejemplo, y lo que importa recordar es sobre todo qué problema resuelve. Para eso hay que empezar por el hashing estándar, el que no es consistent.
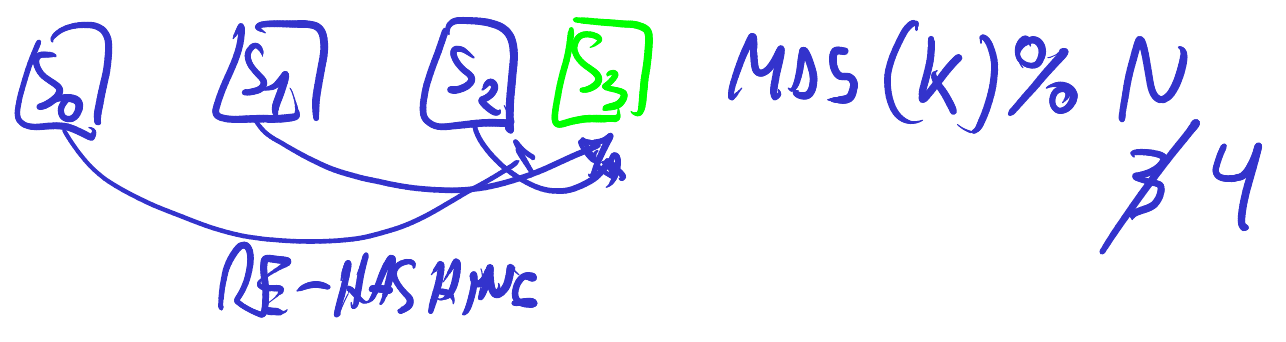
El hashing común es exactamente lo que se hace en el trabajo práctico de MapReduce. Supongamos tres nodos, S0, S1 y S2. Para decidir cuál guarda una clave, a la clave se le calcula un MD5 y a ese número se le toma el módulo N, donde N es la cantidad de servidores, tres en este caso. El resultado —cero, uno o dos— dice a qué servidor le toca. Es simple, rápido y reparte razonablemente bien. ¿Por qué recurrir a algo más elaborado?
El problema venía al agregar un servidor nuevo. Supongamos que aparece S3: ese tres de la fórmula ahora tiene que ser un cuatro. La consecuencia es que a todas las claves guardadas les cambia el destino, y hay que hacer el proceso que se suele llamar rehashing: recalcular a dónde va cada una y moverla. Aquí está el punto que la intuición pasa por alto, porque uno tiende a imaginar que el servidor nuevo se lleva una porción y los demás se quedan quietos. No es así: todos se tienen que mandar claves entre sí, porque el módulo cambió para todas y no solamente para las que van a parar al recién llegado.
Con tres servidores el costo es tolerable. En las escalas de Amazon, que tenía miles, sí lo es. Agregar uno solo hace que mil servidores empiecen a mandarse información de un lugar a otro y que se mueva casi todo lo guardado: al pasar de mil servidores a mil uno, una clave conserva su destino solamente si su hash da el mismo resto con los dos módulos, y eso ocurre en aproximadamente una de cada mil. El otro 99,9 % cambia de dueño.
Consistent hashing es un truco más inteligente. La representación típica es un anillo: un círculo que representa todos los números desde el cero hasta el tamaño del hash. Con MD5 el hash es de 128 bits, así que en el corte de arriba del círculo está el 2^128 − 1 de un lado y el 0 del otro. Cada hash de clave termina cayendo en algún lugar de esa circunferencia, y cada servidor también está asignado a un valor dentro del círculo, inicialmente random. La idea central es la regla que une las dos cosas: si el elemento cayó en algún lugar del anillo, hay que seguir avanzando por el círculo hasta llegar al primer servidor que aparezca, y ese es el que le toca.
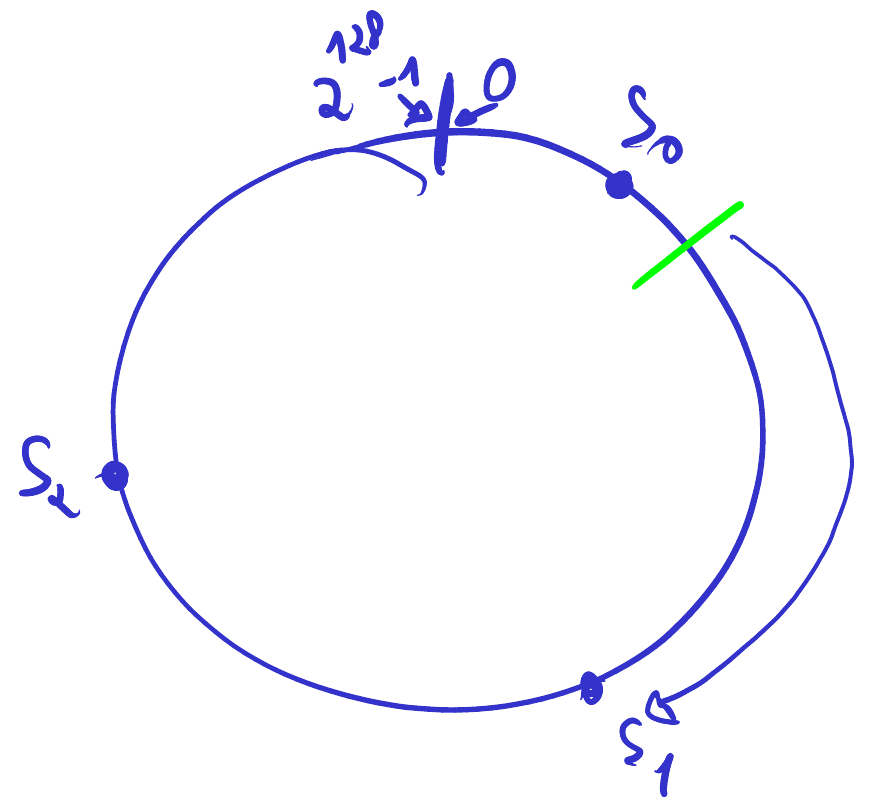
Con esa regla, agregar un nodo deja de ser un problema grave. Partamos de tres servidores sobre el anillo y agreguemos uno nuevo en cualquier lugar. Antes, todo ese tramo del círculo iba a parar a un mismo servidor, el primero avanzando. Al meter el nodo nuevo en el medio, el tramo queda partido en dos: los del tramo de un lado van al nuevo, y los del otro siguen yendo al de antes. En la práctica, solamente ese servidor le tiene que mandar parte de sus claves al que le apareció antes en el círculo. Hay rehashing, sí, pero uno que afecta a un solo servidor y no a los mil: se mueven las claves de un arco, del orden del uno por mil del total, en lugar del 99,9 % de recién. Para eso sirve consistent hashing: para poder agregar y quitar cosas fácilmente.
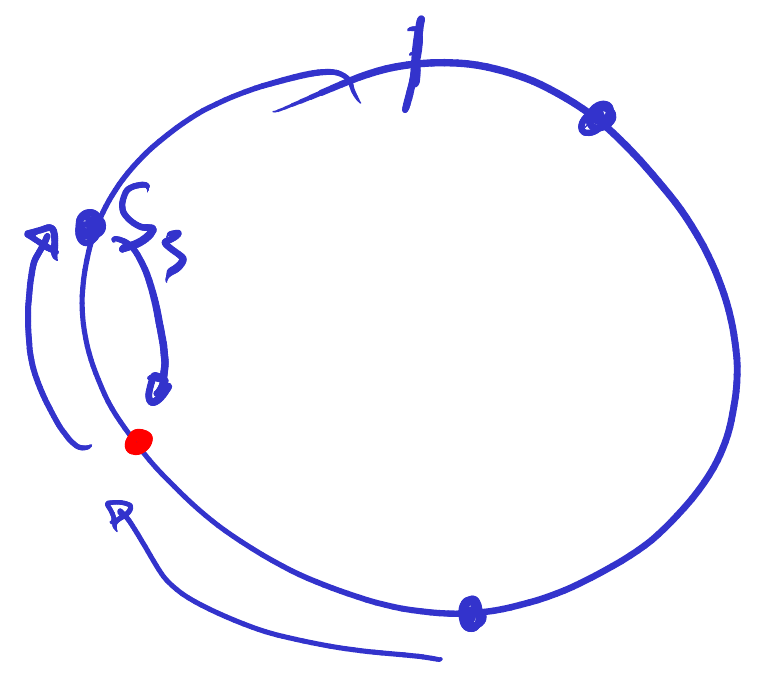
Sobre esa base, lo que el paper de Dynamo agrega para distribuir mejor la carga son los virtual nodes. Cada servidor físico no aparece una sola vez en el círculo: genera muchos puntos repartidos sobre el anillo, y todos esos puntos lo representan.
Los efectos son tres. El primero es que, al agregar un servidor nuevo, ya no hay un único servidor que le tenga que pasar la mitad de su carga: el que entra también entra con muchos puntos, y los servidores adyacentes a cada uno de ellos, que son muchos y distintos, le pueden mandar la carga en paralelo. Agregar uno se vuelve más rápido. El segundo es que la distribución mejora: con muchos puntos por servidor, las porciones del anillo que le tocan a cada uno se promedian entre sí y la carga queda más uniforme, lo que en otros términos quiere decir que se reduce la varianza. El tercero es que aparece una manera natural de contemplar hardware heterogéneo: un servidor más grande puede generar más puntos y uno más chico, menos, así la carga se reparte según la capacidad de cada máquina y no en partes iguales.
¿Cuántos puntos por servidor? El paper no fija esa cantidad: la deja como parámetro de configuración. El orden de magnitud es el de los cientos —Cassandra, que hereda este diseño, arrancó con doscientos cincuenta y seis por nodo—, y parece excesivo hasta que uno hace la cuenta del espacio de direcciones. Los 128 bits del MD5 dan 3,4 × 10³⁸ posiciones distintas sobre el anillo. Mil servidores con doscientos puntos cada uno ponen doscientas mil marcas ahí adentro, y entre dos marcas consecutivas quedan, en promedio, del orden de 10³³ posiciones libres. Doscientos puntos ocupan una fracción ínfima del anillo: apenas alcanzan para que los arcos no queden demasiado desparejos.
Nada de esto es demasiado profundo: es un detalle de implementación. Pero es la parte que resuelve el particionado, el sharding.
Replicación sin líder: preference list y orden por clave
El consistent hashing resuelve el particionado: dada una clave, ya sabemos qué nodo se hace cargo de ella. Falta cómo se le agrega la replicación. Tomemos el anillo con unos cuantos nodos y una clave que cae en un punto cualquiera: con lo visto hasta ahora esa clave iría al nodo que le sigue, y ahí terminaría la historia, un nodo y una copia.
La forma de replicar consiste en cambiar esa última parte por definición. El grupo de replicación no va a ser un solo nodo, sino típicamente tres, o un N configurable por quien use el sistema. Si N es 3, se toma ese nodo que le seguía a la clave y los dos que siguen a ese sobre el anillo. La clave termina guardada en los tres, y a ese conjunto se lo llama preference list.
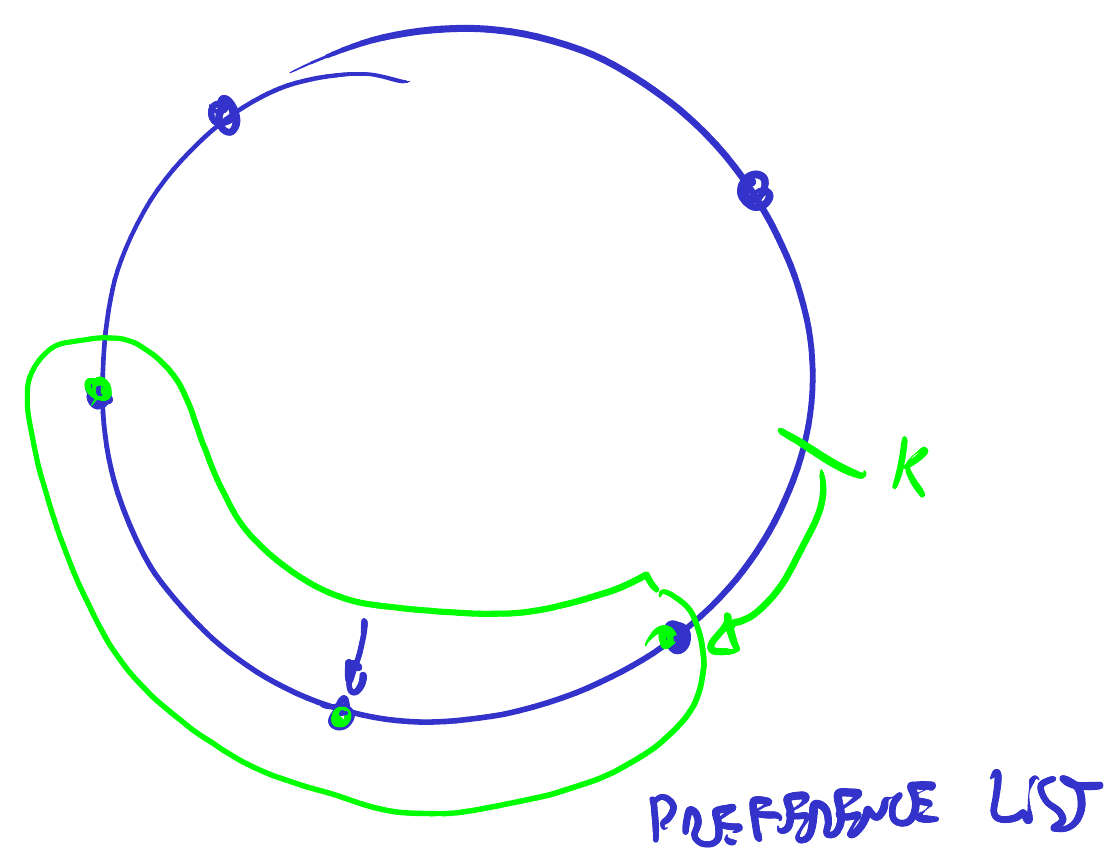
Hay un detalle que rompe con la intuición de todo lo anterior: ninguno de esos tres es un primary fijo. Cualquiera puede atender la escritura, y al que la atiende el paper lo llama el coordinador. El primero de la lista tiene, eso sí, una precedencia por defecto: es el que normalmente coordina, y si el pedido aterriza en un nodo del anillo que no está entre los tres, ese nodo se lo reenvía al primero. Pero esa precedencia es una convención de ruteo, no un rol: el grupo se define tomando el primero y contando dos más hacia adelante, y la clave queda guardada en los tres.
Y esa convención se afloja, que es donde el esquema se separa de todo lo anterior. Serializar todas las escrituras en el primer nodo terminaba desbalanceando la carga —el tráfico no se reparte parejo entre las claves—, así que se habilitó a cualquiera de los tres a coordinar. El elegido tampoco es uno al azar: es el nodo que respondió más rápido a la lectura inmediatamente anterior, un dato que viaja en el request. Tiene además una ventaja adicional, y es que ese nodo es justamente el que ya tenía el valor que se leyó, con lo cual sube la probabilidad de que uno lea sus propias escrituras. El coordinador va cambiando de escritura en escritura, y el que recibe una la reenvía a sus dos vecinos en la preference list.
Hay algo de lo que no vamos a hablar, y conviene señalarlo para no confundirlo con una omisión: cómo hace cada nodo para conocer la configuración del anillo. Cuántos nodos hay, cuántos virtual nodes genera cada uno y cómo se mantiene ese estado en todo el sistema. Es un problema real, con su propia solución, pero es un tema aparte. Por ahora asumimos que cada nodo conoce la configuración y que, por lo tanto, sabe cuáles son sus vecinos: si le llega una clave, a partir de ella puede deducir en qué otros dos nodos tiene que escribirla.
La lista de lo que este esquema no hace es sorprendente. Dynamo no usa Raft, ni Paxos, ni ningún sistema de consenso de esa familia. No usa log. No tiene un primary fijo: cualquiera de los tres puede coordinar, y el que coordina cambia de una escritura a la siguiente. Y soporta split brain: si hay una partición, se puede seguir escribiendo de los dos lados y el sistema, sorprendentemente, sigue funcionando.
¿Cómo se logra eso? Es el gran tema del resto de la clase, y la respuesta en una línea es: controlando el orden en el que se escriben las cosas. Si tenemos alguna forma de definir en qué orden ocurrieron las escrituras, después se las puede reconciliar. La idea conviene anotarla tal cual: controlar el orden de los writes de las claves.
Dicho así todavía no dice nada, porque falta justamente la maquinaria que permite definir ese orden sin un reloj común. Vamos a llegar ahí de manera gradual.
Lo que importa para preservar la consistencia se aprecia con un ejemplo mínimo: un add de una clave, después un update de esa misma clave y después un delete. Lo importante es que exista una precedencia entre esas tres operaciones y que podamos reconstruirla. Porque cuando hablamos de orden, hablamos exactamente de eso: de qué cosa ocurre antes que otra cosa.