3. Replicación y tipos de falla
Toda generalización de este tipo probablemente sea imprecisa, pero tomemos igual esta: en general la replicación es más difícil que el sharding. No es que el sharding sea fácil —también es complicado—, sino que la replicación lo es por varias razones que van a ir apareciendo.
Qué significa que un sistema esté replicado se explica mejor por contraste. En el sharding hay muchas máquinas y en cada una hay datos distintos: el dataset está partido y cada fragmento vive en un lugar. En la replicación también hay muchas máquinas, pero tomamos el mismo dato y ponemos copias en varias: si el dato es x = 1, ese x = 1 lo vamos a tener en varias máquinas a la vez.
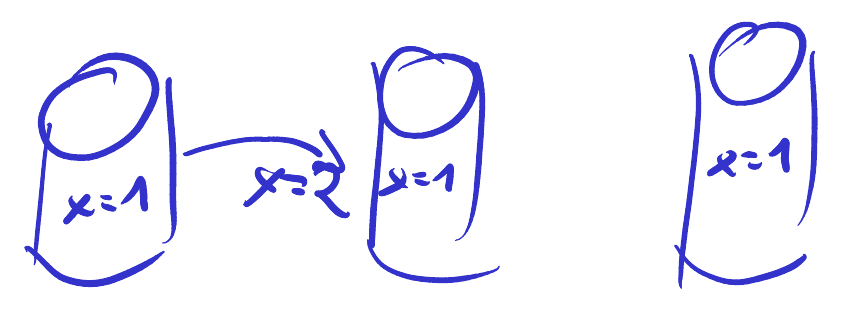
El beneficio inmediato es evidente: si se pierde una de esas máquinas, quedan otras dos de las cuales obtener el dato. Sobre esa base se pueden construir estrategias interesantes: que esas tres réplicas estén en data centers distintos, distribuidos en distintos lugares del mundo, de manera tal que si un desastre natural destruye un data center entero —un terremoto, un huracán— no se pierdan todos los datos.
En el caso más básico, el de casi todos los sistemas que vamos a ver, la replicación es una copia del dato en cada lugar. Vale un paréntesis, porque no es la única forma. Quien conozca RAID —redundant array of inexpensive disks— habrá visto que ahí no siempre hay copia directa: uno de sus modos es mirror, pero había también modos con códigos de recuperación de errores, códigos de Hamming, donde no se guarda una copia. La ventaja está en el espacio, y la aritmética es contundente: guardar un terabyte con tres réplicas cuesta tres terabytes y dos se desperdician; con esos mecanismos se podía tener cinco máquinas guardando el equivalente a tres, un sobrecosto del 67 % en lugar del 200 %. No vamos a profundizar ahí: para nosotros siempre van a ser copias.
Y hay un giro importante: el problema, de aquí en adelante, no va a ser que el dato ocupe mucho espacio, sino que esas máquinas estén sincronizadas con el mismo dato. Ese tipo de problema va a aparecer constantemente.
¿De qué tipo de falla nos protege tener el dato en varios lugares? Hay dos grandes clases, y solo una nos va a ocupar.
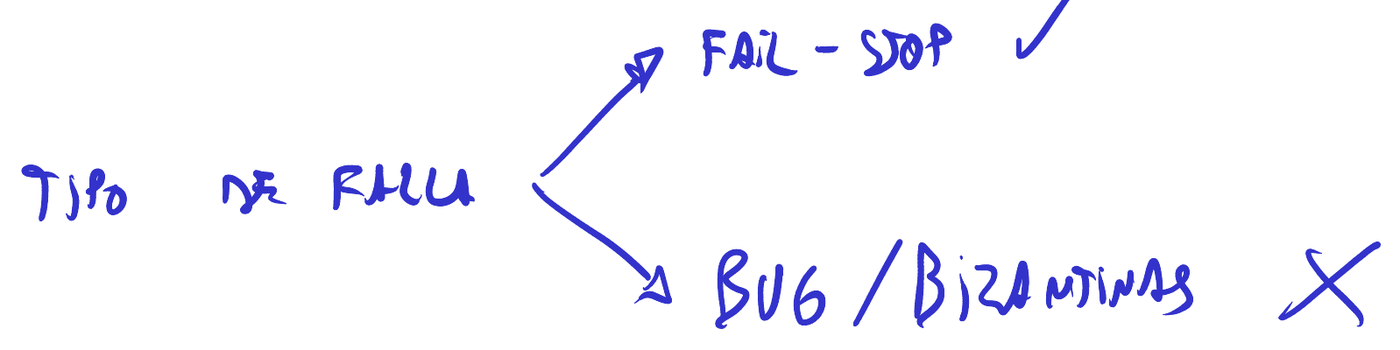
La primera es parecida a lo que vimos con RPC. Cuando uno envía un request y la otra máquina no responde, no sabemos qué ocurrió: puede que recibiera el request y fallara el response, que lo recibiera y se interrumpiera, o que nunca lo recibiera. Es incertidumbre total. Toda esa categoría —incluida la partición de red, que va a ser importante en todo lo que sigue— la vamos a generalizar como fail-stop: los problemas que se manifiestan como no obtener respuesta.
Hay algo que se le parece y no es lo mismo. Si el sistema nos responde con un error —intentamos escribir y nos indica que el registro está duplicado—, eso ya es un error de la capa de negocios. Fail-stop es lo otro: enviamos y no obtenemos respuesta, porque la máquina dejó de funcionar o porque el sistema está particionado.
Que la máquina deje de funcionar es fácil de imaginar: se quemó el disco o se cortó la luz, y en el dibujo queda una cruz encima. La partición de red es lo verdaderamente problemático. Supongamos que se rompe la conexión con un data center: un cable, un switch. Desde un cliente de este lado no hay forma de saber si lo que falló es la red o la máquina. Por eso agrupamos ambos casos: el otro no respondió, y tenemos que hacer algo.
El problema que queda planteado, entonces, es cómo mantenemos réplicas si no sabemos si el otro está operativo. Es el problema interesante, y le vamos a dar mucha atención cuando lleguemos a Raft, que existe justamente para eso. Hay un caso todavía más incómodo, incluso teniendo un heartbeat: que una parte de la red se desincronice y la otra no.
Todo esto es en oposición al otro tipo de problemas. Si hay bugs en las implementaciones —si una máquina, al replicar, en vez de x = 1 guarda x = 2—, ahí no podemos hacer mucho. Son máquinas que no respetan el protocolo, o incluso una máquina maliciosa que busca engañarnos, porque no todas tienen que ser nuestras. A eso se le llama fallas bizantinas, y hay otras técnicas para eso que se ven en una clase aparte.
Raft, cuando lleguemos a él, va a apoyarse fuertemente en que todas las máquinas implementen correctamente el algoritmo: si alguna se aparta del protocolo, o si está mal implementado, todas sus garantías dejan de funcionar. Y eso se va a experimentar con el trabajo práctico, porque un bug propio cae en esta categoría y ahí Raft no nos va a proteger.
La definición sencilla es la que vamos a usar de aquí en adelante: fail-stop es cuando no podemos comunicarnos con una máquina. No sabemos por qué, pero los mensajes no llegan. Lo que queda por ver es con qué mecanismos se consigue la replicación.