3. Escrituras
En esta sección
Replicación de chunks
Hay un supuesto que quedó implícito: las réplicas de un chunk, las copias que residen en cada chunkserver, son todas iguales. Vamos a ver que no lo son necesariamente, pero por ahora quedémonos con la versión simple.
De ese supuesto se desprende algo que ya usamos sin decirlo: si las tres copias son iguales, no necesitamos ningún chunkserver especial ni privilegiado, leemos de cualquiera de los tres. Por eso la lectura resultó tan directa de contar.
Para escribir la situación es distinta. Empecemos por el enfoque equivocado, por la forma de hacerlo mal, porque entender por qué falla es lo que justifica todo el mecanismo que viene después.
Imaginemos dos réplicas —el chunkserver 1 y el 2— y dos clientes que quieren escribir. Una opción mala sería que cada cliente le mande la escritura a todos los chunkservers: la lectura calcada, pero al revés. Le pedimos al coordinador las réplicas, nos devuelve la lista completa y, en vez de leer de una sola, escribimos en todas; el cliente actualiza el valor en cada copia y se ocupa por su cuenta de que queden sincronizadas.
Al principio funcionaría. El cliente 1 quiere escribir el valor 1 en la posición x, lo que vamos a anotar write(x, 1), y le envía esa operación a los dos chunkservers. Después el cliente 2 hace lo mismo con el valor 2. Cuatro mensajes, dos por cliente, y aparentemente todo en orden.
Lo que importa es el orden en el que llegan las operaciones. Estamos modificando el mismo valor en dos servidores distintos, y ese orden sí cambia el producto. Al chunkserver 1 puede haberle llegado primero write(x, 1) y después write(x, 2), con lo cual termina con x valiendo 2; al chunkserver 2 puede haberle llegado al revés, y termina con x valiendo 1. Y quedamos con dos réplicas que deberían ser copias idénticas del mismo chunk y guardan valores distintos. La premisa con la que veníamos trabajando —que da igual de qué réplica leamos— se derrumba.
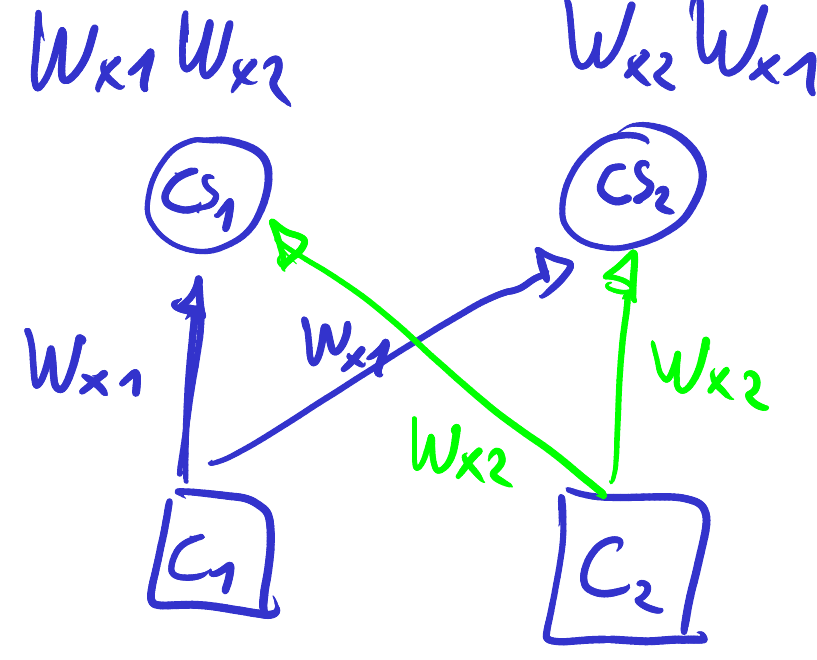
El orden es importante, y de ahí salieron los logs de los que hablamos la clase pasada. Pero para este caso hay una solución más fácil, que es la que usan: un modo de replicación llamado primary-backup. El GFS usa una versión de primary-backup.
Volvamos a las réplicas, e imaginemos para simplificar que dentro de cada una hay un único chunk. Hay que elegir a uno de los tres como primary; los otros dos van a ser secondaries, o backups.
¿Quién lo decide? Ahí reaparece el coordinador: es él quien designa a uno como primary y a los otros dos como secondaries. Y a su vez hay un mecanismo permanente de monitoreo: cada chunkserver le envía heartbeats, latidos que señalan que sigue en funcionamiento. O quizás sea al revés, quizás sea el coordinador el que consulta; el sentido no es determinante.
El coordinador está resolviendo dos problemas distintos con eso. Por un lado, elegir un líder: es una variación del problema de elección de líder. Por otro, la detección de fallas, porque monitorea a cada miembro de ese conjunto, al que vamos a llamar réplica group o grupo de réplicas: varias réplicas, una de ellas privilegiada, el primary. También hay que garantizar que haya una y no más de una, porque si hubiera dos volveríamos al split brain que vimos la clase pasada. Eso también lo va a resolver el coordinador.
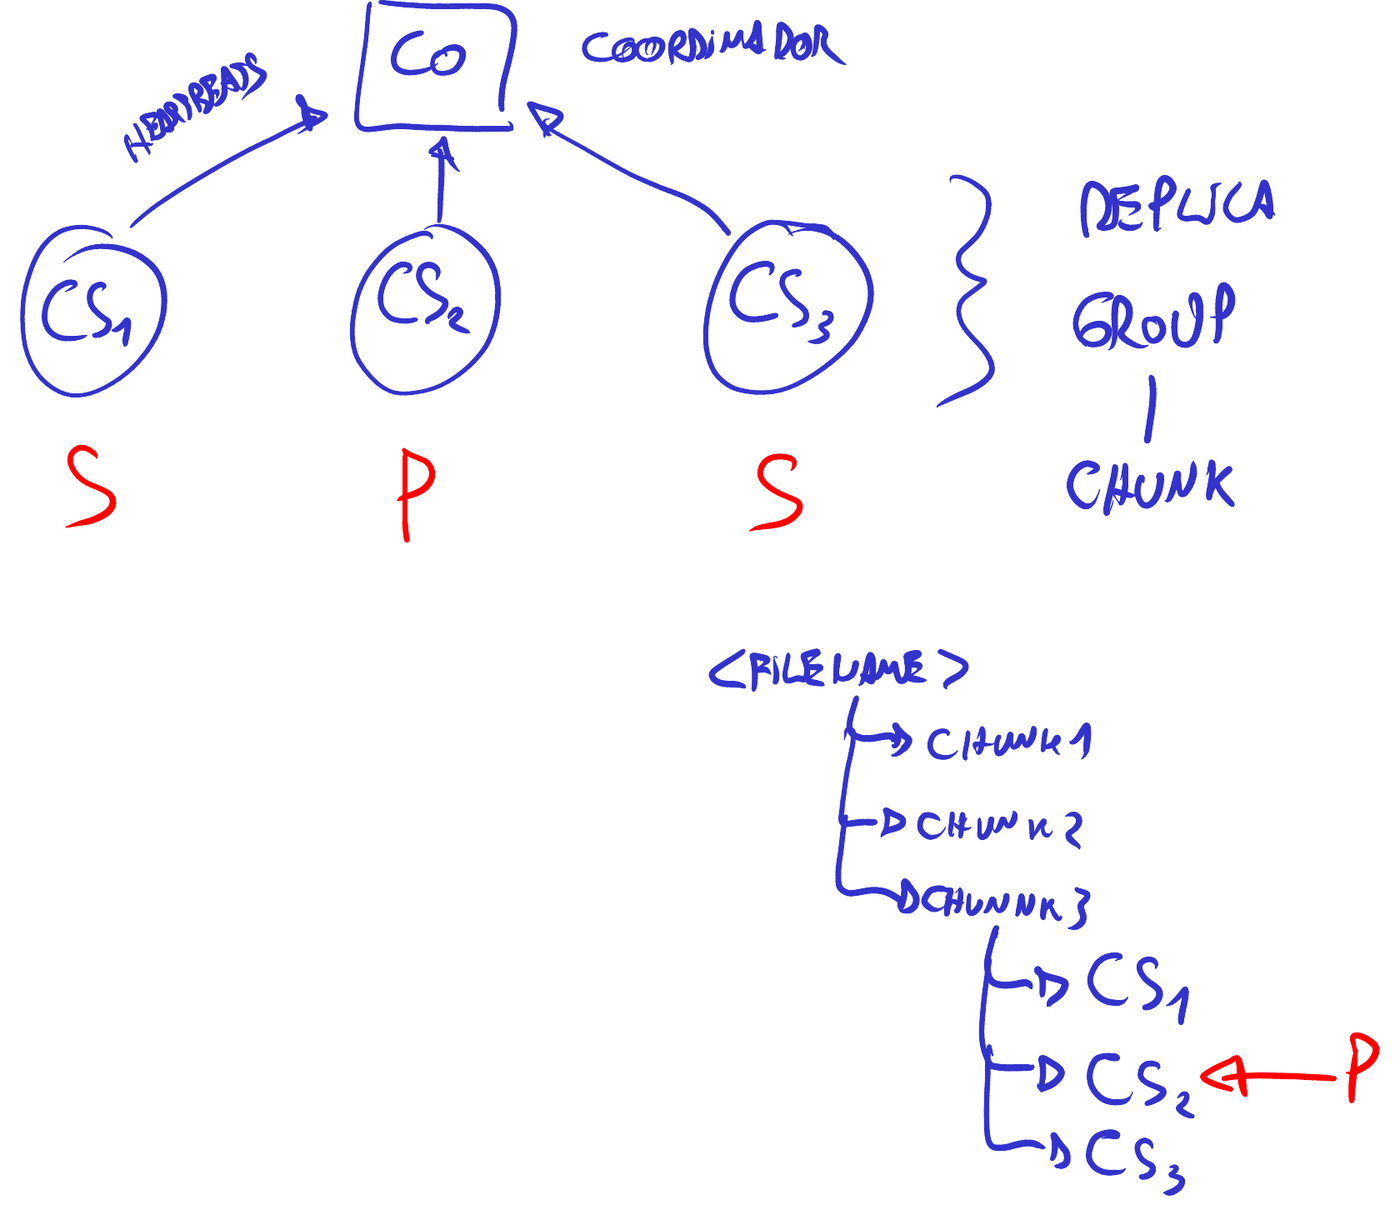
Con esta estructura armada, las escrituras empiezan por el primary y desde ahí van a las secundarias.
El coordinador cumple tres funciones en todo esto, y las tres van a aparecer una y otra vez. La primera es ser un servicio de nombres, en el sentido amplio: internamente tiene una estructura con toda la configuración del sistema. Para un archivo cualquiera sabe todos los chunks que lo componen —chunk 1, chunk 2, chunk 3— y para cada chunk, en qué máquinas físicas está: el chunk 3, por ejemplo, en los chunkservers 1, 2 y 3. Averiguar dónde se encuentra algo consiste en consultar esa base de datos interna.
La segunda función, que no es exactamente lo mismo, es elegir el líder: no alcanza con saber que el chunk 3 está en esas tres máquinas: además hay que señalar cuál de ellas cumple ese rol. La tercera es el monitoreo, la detección de fallas. Y las tres están enlazadas, porque cuando el monitoreo detecte una falla habrá que elegir un nuevo líder para cada chunk que se quedó sin primary.
La granularidad es fácil de pasar por alto. Esta estructura de un primary y n secondaries es por réplica group, y cada réplica group está asociado a un chunk, no a un archivo: la estructura importante, la que aparece una y otra vez, es el chunk.
La consecuencia es que los chunks de un mismo archivo pueden estar distribuidos en réplicas distintas. Un archivo de 100 o 1000 chunks —6,4 GB en un caso, 64 GB en el otro— no va a estar entero en las mismas tres máquinas, y no sería deseable que lo estuviera: si falla una, se ve afectado el archivo completo y perdemos la propiedad de que las fallas sean parciales. Con mil máquinas, esos chunks van a estar dispersos por todo el sistema, siempre en grupos de tres, y de cada tres una está seleccionada como primary: la que va a coordinar todo el proceso de las escrituras.
Flujo de escritura
Vamos a lo que une todo: la figura 2 del paper, la que dice cómo se realiza una escritura. Ahí el cliente y la aplicación aparecen combinados en la misma caja —lo cual no es relevante— y los números indican el orden de los pasos.
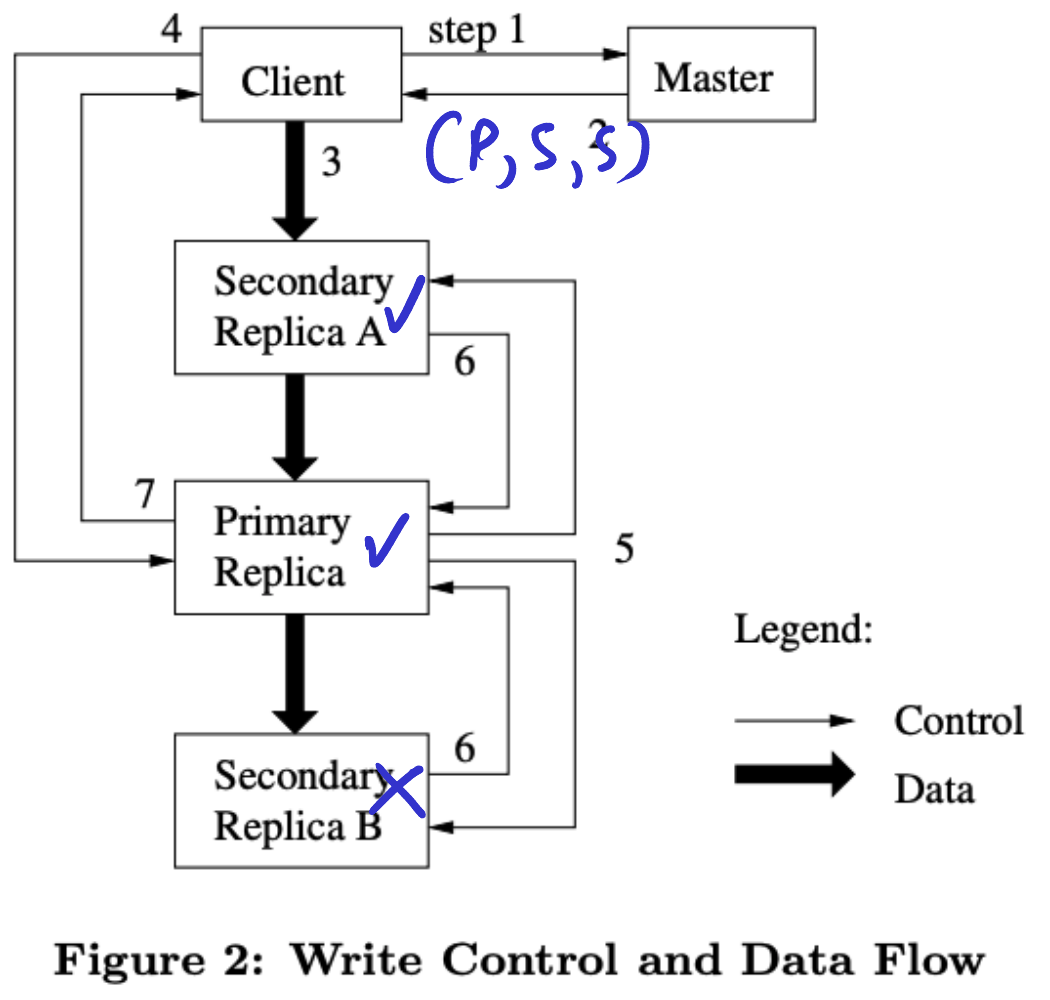
Los dos primeros pasos ya nos resultan familiares por la lectura: el cliente le pide metadata al master para ese archivo y ese chunk, y el master le devuelve el chunk handle. Pero lo más interesante que devuelve ahora es quién es el primary y quiénes son los secondaries para ese chunk en particular.
El tercer paso es curioso, y es una optimización: no hay que pensarlo como algo esencial dentro del algoritmo de escrituras, sino como el recurso que hace que el commit sea muy rápido. El GFS pide que se envíen los datos primero y solo después la orden de escribir.
En el paso tres el cliente manda todos los datos que quiere escribir a una réplica cualquiera, por ejemplo a un secondary. Esa réplica no los va a escribir: los guarda en memoria, en un buffer LRU —least recently used—, y los conserva ahí hasta que el cliente le indique que ya puede escribirlos.
Lo interesante es cómo se propagan esos datos. Para que el cliente no tenga que enviárselos a todas, se construye algo parecido en esencia al chain replication de la clase pasada. No lo es, porque le faltan muchas cosas, principalmente que no está escribiendo los datos en sí; pero el mecanismo es el mismo: se le envía a la réplica más cercana, esa se lo envía a otra, y esa a la tercera. En esta etapa no importa quién es primary y quién secondary; lo único que importa es que todas terminen teniendo, en memoria o en un archivo temporal en disco, los datos que vamos a escribir después.
Cómo se entera el cliente de que eso ya ocurrió es algo que el paper tampoco explica bien. Presumiblemente cada réplica le responde a la que le pasó los datos y, cuando las respuestas empiezan a volver, el cliente sabe que ya todos los tienen.
Lo primero interesante de la escritura es que el master no tiene nada que ver: el master era metadata. El cliente habla directamente con el primary, y sabe quién es porque el master se lo dijo en el paso dos. En el paso cuatro le manda un write request.
El primary hace dos cosas, en este orden: primero aplica el cambio localmente, después se lo envía a los secondaries, a uno y al otro. Los secondaries confirman, y solo entonces el cliente recibe la respuesta definitiva: ese es el caso feliz.
Conviene detenerse en un rol del primary que la figura no dibuja. Potencialmente está recibiendo requests de muchos clientes para el mismo chunk: el sistema está diseñado para que pueda haber varios. Y lo más importante que hace es secuenciarlos, o serializarlos: decir qué request vino primero y cuál después, justamente lo que no podíamos hacer con el esquema de flechas cruzadas.
El orden que elija no importa tanto; lo que importa es que sea un orden bien definido, decidido en un único lugar. A cada request le asigna un número de serie y se lo envía a los secondaries, que aplican todo en el mismo orden que el primary. Ahí queda resuelto el problema de consistencia del anti-patrón.
El paso seis, el de las respuestas, tiene dos desenlaces: si todas las réplicas responden okay, se le responde okay al cliente; si alguna responde error, se le responde error. Con ese error empieza lo que sigue.