5. Elección de líder en Raft
En esta sección
Términos y estados de un nodo
Queda la otra fase: cómo funciona la elección de líder. La primera cuestión es fácil: cuando el algoritmo inicia no hay ningún líder y se tiene que elegir uno.
Lo segundo no es tan obvio. En Raft el líder no es fijo: puede ir cambiando, y no por capricho ni por turnos, sino cuando hay fallas de red, cuando el líder muere, o cuando queda del lado de una partición minoritaria. A lo largo de la vida de Raft hay una secuencia de líderes sucediéndose. Y lo difícil no es el reemplazo en sí, sino hacer que sea consistente con todo lo demás, que en el camino no se pierda información.
Para hablar de esa secuencia hace falta un nombre: término —term, tal como aparece en el paper—. Cada vez que se elige un nuevo líder empieza un nuevo término, identificado con un número que va aumentando. La analogía más cómoda es la de los mandatos de un presidente, numerados uno detrás del otro, con una particularidad que la analogía política no captura: hay términos donde no se termina eligiendo a nadie. El contador lo lleva todo el sistema de manera implícita, y la idea conviene retenerla porque es la que ordena todo lo demás.
En la elección los nodos pasan por distintos estados, y aparece un mecanismo nuevo: el election timer, la tolerancia que tiene cualquier nodo a no recibir heartbeats del líder actual. En un sistema que funciona bien hay un líder enviando constantemente AppendEntries, que no sirven solamente para appendear: sirven también para avisar el commit y para avisar que el líder está vivo. Si un nodo no recibe uno por mucho tiempo, va a iniciar una elección.
Cuánto es ese tiempo es lo que se llama el election timeout. Cuando pasa esa cantidad de milisegundos sin que llegue nada del líder, ese nodo se pone en modo candidato y va a tratar de transformarse en el nuevo líder.
Todo esto se ordena mejor como un diagrama de estados, que es como lo presenta el paper en su figura 4. Cuando un nodo inicia, está en modo follower. Hay detalles que se terminan de entender al leer el algoritmo completo, pero lo esencial es simple: si un follower recibe un heartbeat de un líder, automáticamente lo acepta. La transición interesante es la otra: si se le expira el election timeout, pasa al estado candidato. Decide, sin consultar a nadie, que quiere ser el nuevo líder.
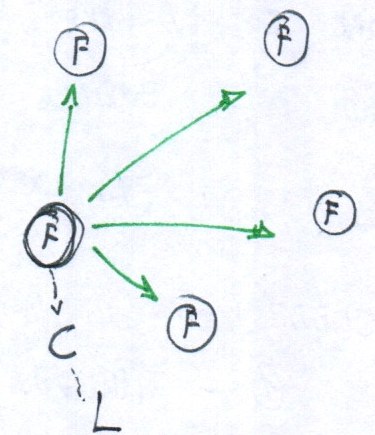
Y cuando quiere ser líder, lo primero que hace es pedir votos, igual que en el ejemplo rápido que ya vimos: se vota a sí mismo y envía un RequestVote a todos los nodos; está haciendo campaña, si se quiere. Si una mayoría de peers le responde que sí, se transforma en el nuevo líder. Bajo qué condiciones responden una cosa o la otra lo vamos a ver más adelante.
Ciclo completo de una elección
Existe una animación muy buena en raft.github.io, donde se ve Raft funcionando con los nodos, los contadores y los mensajes en vuelo. Conviene dedicarle un tiempo: es una de las mejores herramientas de estudio que hay. Lo que sigue es el ciclo completo de principio a fin, con cinco nodos.
Al inicio los cinco son followers, todos en el término uno, y cada nodo tiene en todo momento dos atributos que lo describen: un estado —follower, candidato o líder— y una cuenta regresiva propia, el election timeout. Esos timeouts están randomizados justamente para que siempre haya uno que dispare primero.
El nodo cuyo timeout expira primero aumenta el término y envía un RequestVote a todos los nodos. El orden importa: se pone en modo candidato y al hacerlo aumenta el término, de manera que el pedido de voto sale ya con el término nuevo. Los votos que van llegando se le acumulan hasta alcanzar la mayoría: si de esos cuatro dos le responden que sí, esos dos sumados al propio lo transforman en líder. Ese es el caso fácil y feliz.
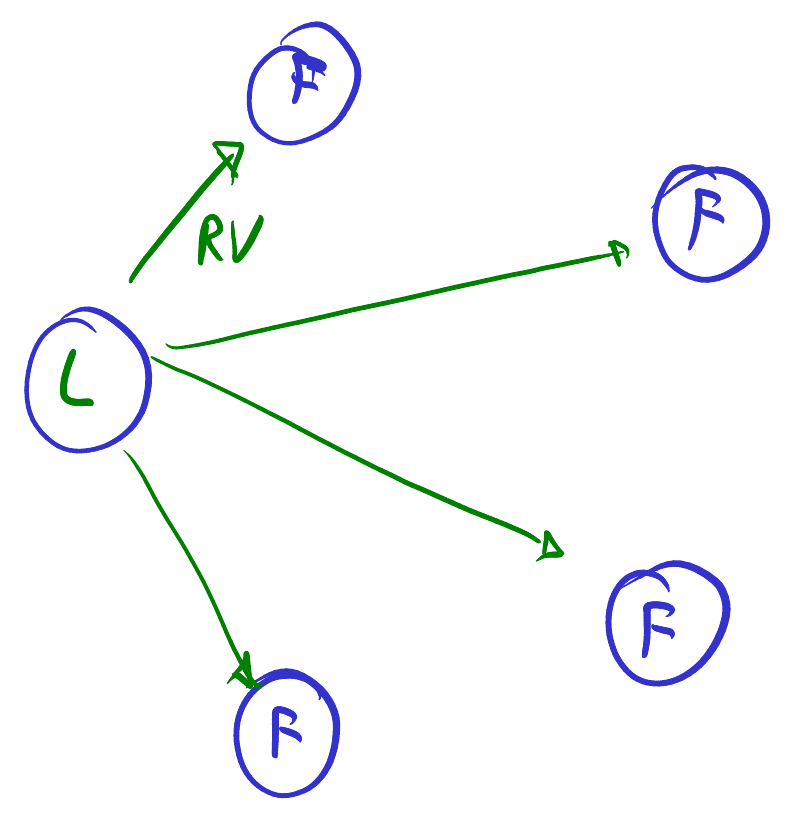
Ahora el caso interesante: que dos nodos se pongan en modo candidato casi al mismo tiempo y los dos pidan que los voten. Ahí queda una de dos cosas: o se elige uno, o no se elige ninguno, y lo que decide es el orden de llegada de los mensajes. El nodo que recibe primero un pedido lo acepta, vota que sí, se transforma en follower y responde granted: true.
El candidato que reúne la mayoría se transforma en líder y empieza a enviar AppendEntries a modo de heartbeat. El otro candidato, al recibirlo, reconoce que ese es el líder y se subordina a él. Los contadores del election timeout siguen corriendo —nunca se apagan—, pero el líder envía eventualmente un AppendEntries vacío, y eso alcanza como heartbeat. Cuando lo reciben, todos renuevan su contador, y no todos por el mismo valor, precisamente a causa de la randomización. Mientras esos mensajes lleguen con regularidad, ningún follower llega a expirar y nadie se postula: el liderazgo se sostiene solo, sin ninguna ceremonia de renovación.
Con el líder en su lugar, miremos una escritura. Cuando la aplicación le envía un request a Raft, el líder agrega esa entrada a su log. Y aquí hay una convención del paper que desconcierta: el número que lleva la entrada no es el dato, es el término en que se escribió. Eso va a tener más sentido en la clase siguiente.
Con la entrada en su log, el líder les envía a todos un AppendEntries con esa entrada para ese término. Todos la aceptan, la ponen en su log y responden success: true. Podría ser también success: false, y en qué casos ocurre es tema de la clase que viene. Cuando el líder reúne una mayoría de esas respuestas, la entrada queda comiteada. Después envía otro heartbeat, y en ese heartbeat viaja el commit index; al recibirlo, todos comitean y aplican la entrada a la capa superior. Si se agregan más requests, el número de las entradas nuevas no cambia, porque son del mismo término. Así el sistema avanza y eventualmente todos quedan al día.
Hasta aquí no falló nada. Si el líder falla, lo que ocurre es que no ocurre nada: deja de enviar heartbeats y nada más. Es la ausencia de mensajes lo que dispara todo lo demás. Uno de los otros cuatro expira primero, aumenta el término, pide que lo voten, todos votan que sí, y el sistema vuelve a funcionar con un líder nuevo. Si mientras tanto entran requests, todos avanzan menos el que quedó atrás, que se queda con el log más corto.
El caso que sigue es el que más intriga: qué pasa cuando el nodo caído revive. Sigue creyendo que está en el término anterior, el término en el que murió. Pero el otro se adelanta: le envía un AppendEntries, un simple heartbeat, y como ese mensaje trae un término más grande que el propio, el nodo sabe automáticamente que tiene que dejar de ser líder y aceptar al nuevo, y él mismo actualiza su término. No hace falta que nadie le informe que fue destituido: la comparación de términos alcanza. A partir de ahí se va poniendo al día con las entradas que se perdió, hasta que su log queda igual al del líder. El detalle de ese intercambio es también de la clase que viene.
Aparece una pregunta natural: si el nodo se durmió creyendo que era líder, ¿cómo dejó de creerlo? La respuesta es un detalle del algoritmo que hay que tener presente: cuando una máquina muere y revive, revive como follower, no en el estado en que estaba. Con eso el problema desaparece casi antes de plantearse: lo único que le falta al nodo que vuelve es enterarse de cuál es el término actual y quién ejerce el liderazgo.
Y queda el caso interesante de verdad: que en vez de morirse, al líder se le corte la red. Ahí se bloquean los mensajes que salen hacia todos los demás. El líder está vivo, sigue recibiendo requests, los va poniendo en su log, y no puede enviárselos a nadie: ninguna de esas entradas va a reunir mayoría. Del otro lado, mientras tanto, a uno de los nodos se le vence primero el timeout, se postula, y aparece un término nuevo, más grande que el del líder aislado.
Lo que ocurre después es lo que hace que todo encaje. El nodo que tenía entradas sin comitear, al recibir un pedido de voto con un término más grande, lo acepta. Y cuando el líder anterior envía algo con su término ya superado, ese paquete se rechaza: nadie lo acepta, porque el término que trae quedó atrás. El nuevo líder anuncia a todos los nodos que ahora es él, y ahí empieza el trabajo de restaurar los logs: las entradas que no estaban comiteadas se terminan borrando. Con el primer request que entra después del cambio, esos logs se reordenan y el sistema queda otra vez con todas las réplicas coincidiendo. Cómo se hace exactamente eso es el tema de la clase que viene.
Casos como estos hay miles, y todos funcionan. Eso es lo notable del algoritmo: es matemáticamente consistente en todos sus frentes, y por más combinaciones de fallas, reinicios y particiones que uno construya, el sistema converge a un único líder y a un único log. Uno puede pasar un tiempo considerable tratando de romperlo —matando el líder en el momento más incómodo, dejando entradas a medio replicar, cortando la red justo cuando salían los mensajes— y el resultado es siempre el mismo: aparece un término nuevo, alguien reúne la mayoría, y el log converge. De ahí la recomendación de experimentar con la animación.
Voto dividido y randomización del timeout
Con el ciclo completo ya visto podemos volver sobre el detalle pendiente: por qué los timeouts son ligeramente distintos entre sí. Lo que se quiere evitar tiene nombre propio: el voto dividido.
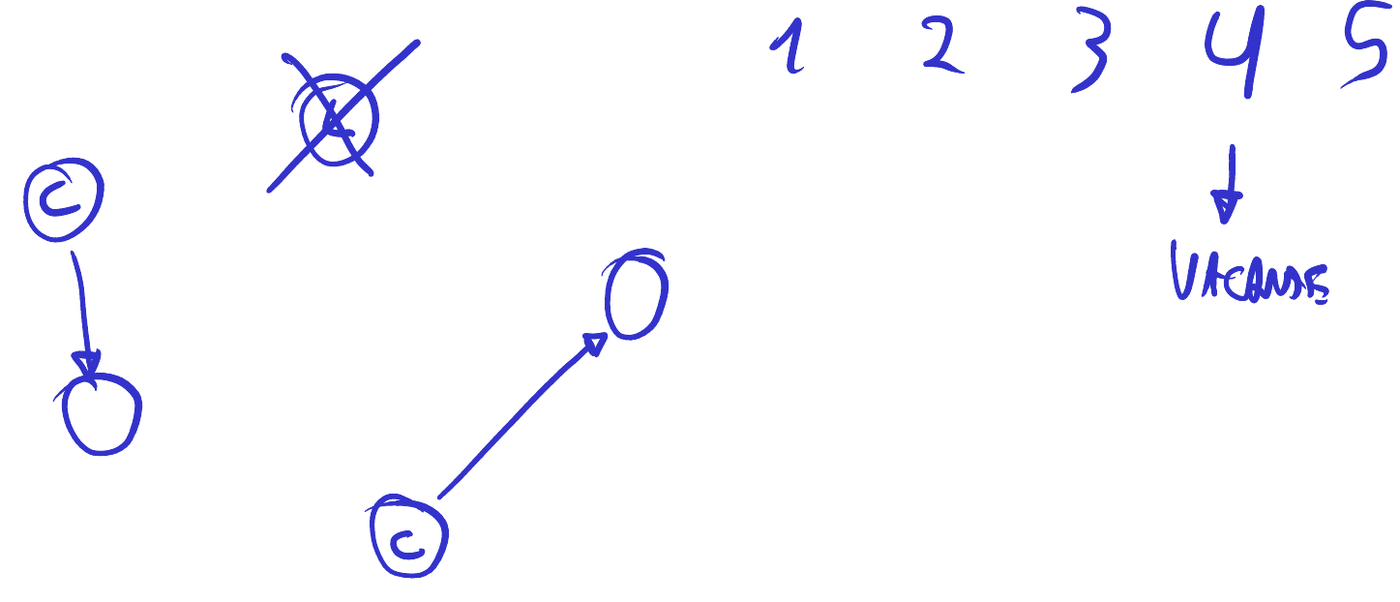
Con todos esos timers perfectamente sincronizados pasaría lo siguiente. Tenemos los cinco nodos de siempre y un líder entre ellos. Ese líder muere, y como los demás están sincronizados, o casi, sus timeouts expiran prácticamente juntos: pueden aparecer dos candidatos simultáneos. Uno le envía un RequestVote a un vecino y el otro a otro, al mismo tiempo. Y una vez que esos vecinos ya votaron, si el otro candidato les pide el voto se lo niegan —viaja de vuelta con granted: false—, porque el voto de ese término ya lo emitieron.
El resultado es previsible: cada candidato obtuvo un voto y el sistema quedó bloqueado. Ninguno reúne la mayoría de tres, así que el liderazgo queda vacante durante ese término. Es una situación que también se puede provocar en la animación, sincronizando los nodos manualmente, y no es un caso patológico infrecuente: es lo que ocurriría por defecto si nadie hubiera desincronizado los timers.
La situación se desbloquea sola, aunque con demora. Los election timers siguen corriendo, y en algún momento el ciclo comienza nuevamente. Si los términos venían uno, dos, tres, puede ocurrir que el cuatro quede vacante y que todos empiecen una nueva elección en el cinco. Lo que se va a ver en los logs es que ese término quedó omitido: un término sin líder es un término sin entradas.
Para evitar que eso pase constantemente se agrega randomización, que es lo que se ve en la animación con las cuentas regresivas desparejas. Cada nodo maneja dos valores: un election timeout mínimo, y un valor random —el jitter— que se le suma para determinar su timeout real. No hay nada más sofisticado: ET = ET_MIN + random(0, jitter máximo). Ese cálculo lo hace cada servidor por su cuenta; el mínimo es el mismo para todos, y lo que difiere de nodo a nodo es el número random.
El resultado es el que buscábamos: cada servidor cae en un momento distinto, a uno se le va a vencer el timeout primero, y ese inicia la elección. Los demás lo reconocen como candidato antes de que sus propios timeouts expiren, de manera que el segundo en la fila nunca llega a postularse.
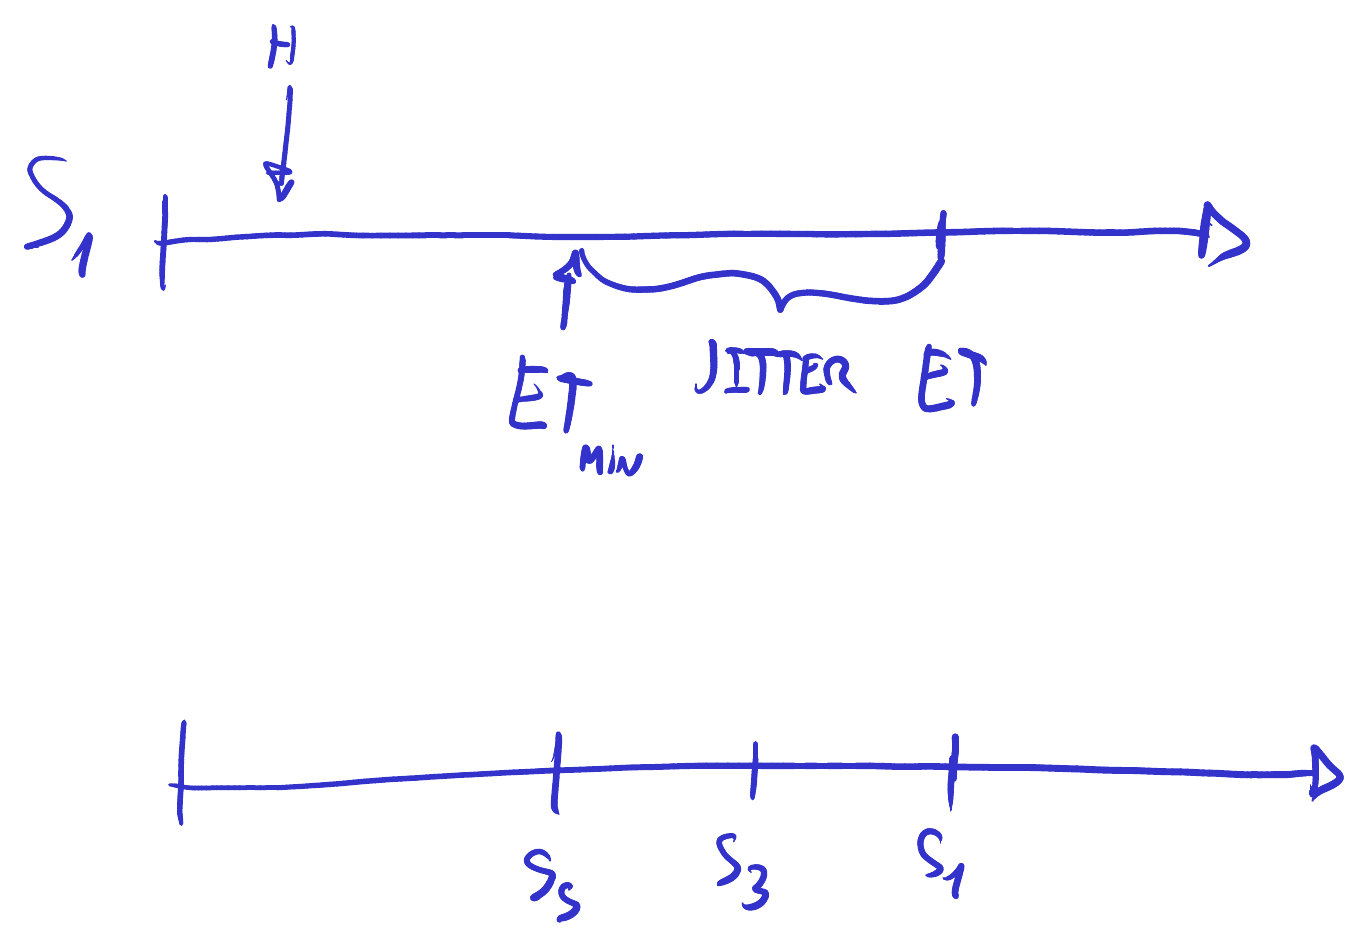
Ese mínimo tiene una restricción de diseño: tiene que fijarse de manera tal que el heartbeat caiga bastante antes que él. Con los valores del trabajo práctico el líder envía diez heartbeats por segundo, uno cada cien milisegundos, y el election timeout mínimo es de trescientos: un follower tiene que perderse tres heartbeats seguidos antes de animarse a postularse, y con un mínimo de seiscientos, seis. Ese margen de tres a seis heartbeats es la holgura, y se advierte qué ocurre si se la reduce: si el heartbeat más demorado cae sobre el timeout, el sistema va a estar todo el tiempo suponiendo que algo falló y tratando de elegir un nuevo líder. Va a funcionar, pero no va a poder avanzar, ocupado permanentemente en elegir. En la animación se ve bien: los mensajes eran claramente más frecuentes que el timeout, y hacía falta bloquear varios seguidos para que expirara el más corto.
El paper recomienda election timeouts de 150 a 300 ms. El lab del MIT en el que se basa el trabajo práctico pide explícitamente valores mayores que esos, porque su tester limita los heartbeats a diez por segundo, y de ahí salen los trescientos a seiscientos milisegundos.
Con esto tiene bastante más sentido la figura 5 del paper, la de los términos, que hasta ahora era solo un dibujo de rectángulos. Muestra la sucesión de términos, y dentro de cada uno dos tramos de distinto color: uno de elección y uno de operación normal. Si el sistema funciona bien para siempre, se queda en operación normal indefinidamente: no hay ningún mandato que se venza. Pero si el líder muere o se particiona, se produce una nueva elección y el sistema sigue avanzando en el término siguiente. Y hay ahí un término donde no surgió ningún líder, así que se omite y la elección se rehace en el que sigue.
Aparece una pregunta natural sobre el costo: si el timeout tiene que ser corto, ¿no resulta muy costoso en términos de red, sobre todo con servidores como los de Amazon, que no están en una red local?
El encuadre es lo que induce al error, porque no se trata de una red de internet. Esos nodos están dentro de la propia red de Amazon, en data centers conectados por fibra óptica de Amazon mismo: una red privada —aunque distante— de varios gigabits por segundo. Y además los AppendEntries, especialmente los heartbeats, son mensajes de un par de bytes. La red es muy rápida, y eso es lo que permite que el sistema se restaure con rapidez.
El compromiso del parámetro es directo: cuanto más largo el election timeout, más tarda el sistema en restaurarse. Si el timeout fuera de diez segundos, el sistema quedaría diez segundos caído; contra eso, los trescientos a seiscientos milisegundos de la práctica son un factor de más de treinta. Bajo una carga muy alta de requests puede que en los gráficos se vea un pequeño pico, pero enseguida se restaura. Y hay una razón adicional para que todo sea corto: cuanto más divergen los logs, más difícil es después reconciliarlos.
Reglas de votación del follower
Los followers responden a un pedido de voto a veces que sí y a veces que no. En el caso feliz que sí, pero hay dos condiciones que el votante tiene que cumplir antes de conceder el voto.
La primera es de la mayor importancia: un voto por término. Igual que en una elección, quien ya votó no puede volver a votar a otra persona. Y la razón es la de siempre: si uno de esos followers emitiera dos votos distintos a dos candidatos, toda la construcción de las mayorías se rompe, porque deja de cerrar matemáticamente: dos candidatos distintos podrían reunir una mayoría en el mismo término.
Es tan importante que tiene una consecuencia directa de implementación: hay que persistirlo en disco. En la clase siguiente vamos a ver qué cosas se persisten y cuáles no; casi nada, pero el log sí, y también por quién votó cada nodo. Antes de responderle al candidato, el votante tiene que guardar en disco a quién le dio el voto. De lo contrario podría morir, revivir, no acordarse de por quién votó, y terminar votando dos veces en el mismo término solo porque en el medio murió. El voto emitido es, junto con el log, uno de los muy pocos elementos que Raft escribe en disco.
La segunda condición es solo votar candidatos actualizados, y “actualizado” quiere decir que su log sea más nuevo que el propio. Tiene que ver con los quórums: si alguien nos pide el voto, es probable que estemos en la mitad con mayoría y que ese candidato esté más actualizado que nosotros. Si lo está, le votamos que sí; si nosotros tenemos información que él no tiene, le decimos que no.
Esto conviene tomarlo con cautela, porque es complicado y hay numerosos subcasos. Por ahora alcanza con la idea general: solo votar a alguien que esté actualizado. La regla completa, con todos sus subcasos, es de la clase siguiente.