4. Transacciones en DynamoDB
En esta sección
Transacciones entre grupos de replicación
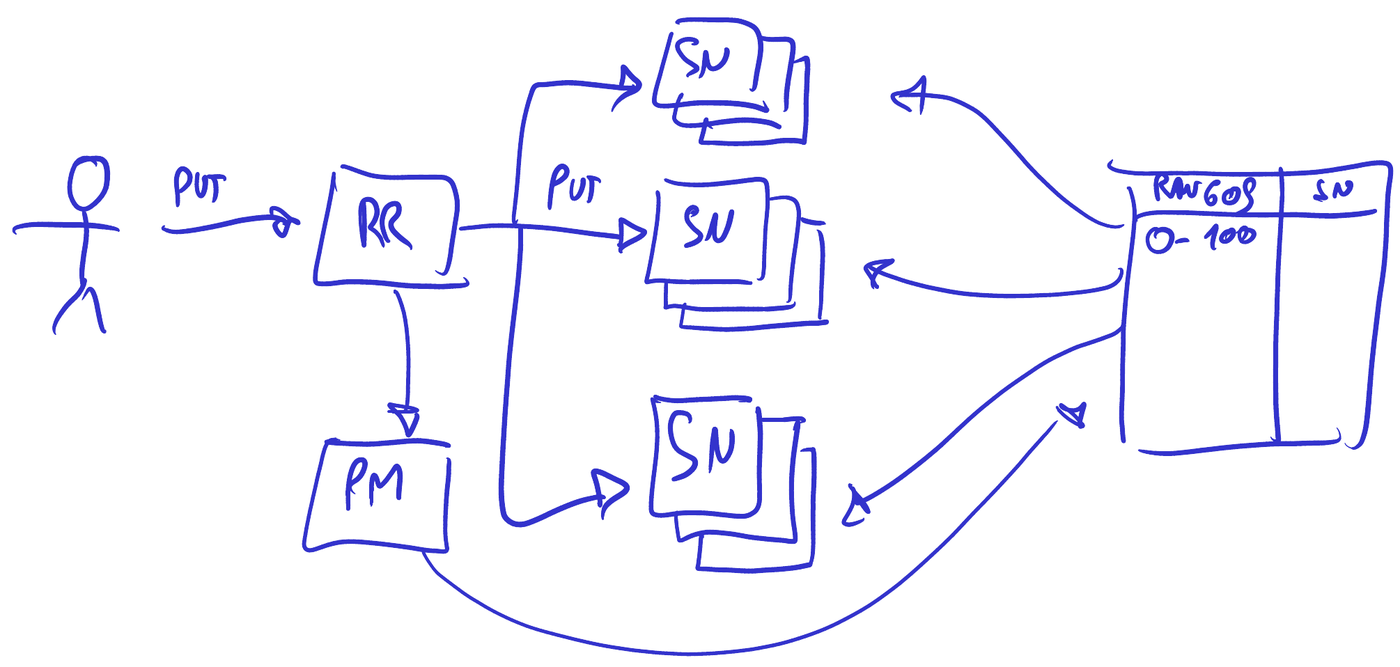
La estructura de DynamoDB la vimos la clase pasada, y repasarla deja claro qué queremos resolver. El cliente le manda el pedido a un request router, que tiene colgado un partition metadata que le dice dónde están las particiones. El router le manda un put a un grupo de storage nodes, típicamente tres, con lo cual el put del cliente termina en un put sobre el grupo de replicación que corresponda.
Con ese cuadro, una transacción en DynamoDB es una que hace puts en distintos lugares. Si todos caen en el mismo grupo de replicación, el problema es fácil: se le mandan todos los puts juntos a ese storage node y los aplica ahí adentro. Lo interesante aparece cuando hay varios storage nodes involucrados.
Así como antes teníamos el sistema de tickets y el de asientos, en DynamoDB los sistemas a coordinar son los distintos grupos de replicación. Ese put queremos que llegue a los tres juntos o a ninguno.
Y no es un caso rebuscado, porque las claves están repartidas por todos lados. El sistema tenía una tabla de rangos y storage nodes —un rango del cero al mil, por ejemplo, y así sucesivamente—, y distintas claves van a parar a distintas entradas. Queremos escribir atómicamente en todas o en ninguna.
Durante muchísimo tiempo DynamoDB no tuvo nada de esto: quien quería una escritura así, sencillamente no la hacía. Existía un repositorio semioficial de Amazon que explicaba cómo armar transacciones sobre DynamoDB con las técnicas que venimos viendo. Hoy está deprecado: lo archivaron en 2024. Vale la pena revisarlo de todos modos, porque explica cómo implementarlas manualmente y es un buen sistema distribuido para estudiar. Pero eventualmente las hicieron oficiales, dentro de DynamoDB, y ese es el paper de hoy.
El repositorio es awslabs/dynamodb-transactions, una biblioteca Java que resolvía las transacciones del lado del cliente; se archivó el 6 de septiembre de 2024 y su README remite a las APIs transaccionales nativas, disponibles desde noviembre de 2018. El paper es Distributed Transactions at Scale in Amazon DynamoDB, de Idziorek, Keyes, Lazier, Perianayagam, Ramanathan, Sorenson III, Terry y Vig (USENIX ATC 2023); de ahí salen los listings y las figuras que la clase recorre en pantalla.
API transaccional y two-phase commit en DynamoDB
La interfaz define el problema. Las operaciones de DynamoDB son pocas y básicas: put, update, delete y get. Hoy tiene alguna más, pero esas son las unitarias, no transaccionales. Lo que agregaron fue TransactGetItems, TransactWriteItems y una operación de verificación, CheckItem.
TransactGetItemses la transacción de solo lectura yTransactWriteItemsla de escritura, y no se pueden mezclar entre sí;CheckItemsí se puede mezclar conTransactWriteItems. Esos son los nombres del paper: en la API pública de AWS la verificación aparece como una acciónConditionCheckdentro del propioTransactWriteItems, junto aPut,UpdateyDelete.
Para quien conozca las transacciones de SQL, lo de DynamoDB es muchísimo más limitado. No se pueden encadenar operaciones. Uno dice “quiero escribir este, este y este, y leer este, este y este”, y las manda todas juntas. No se pueden leer valores, hacer una cuenta y escribir en función del resultado. No está la versatilidad de SQL. La interfaz es, en una palabra, one-shot: una bolsa de updates, puts, deletes y checks que se manda de una sola vez, sin begin ni commit explícitos.
El paper tiene muchos ejemplos en código: toma una operación que actualiza un item, otra que hace un put, y las pone una al lado de la otra en la misma transacción. También está la operación de verificación, que es como una lectura que verifica algo y en base a eso escribe o no; también entra en la bolsa. Es, básicamente, una bolsa de operaciones con la instrucción de ejecutar todo o nada. Eso es lo primero que hay que entender, y notar que es mucho más fácil que resolver una transacción general como las de SQL.
//Check if customer exists
Check checkItem = new Check()
        .withTableName("Customers")
        .withKey("CustomerUniqueId")
        .withConditionExpression("attribute_exists(CustomerId)");

//Update status of the item in Products
Update updateItem = new Update()
        .withTableName("Products")
        .withKey("BookUniqueId")
        .withConditionExpression("expected_status" = "IN_STOCK")
        .withUpdateExpression("SET ProductStatus = SOLD");

//Insert the order item in the orders table
Put putItem = new Put()
        .withTableName("Orders")
        .withItem("{"OrderId": "OrderUniqueId", "ProductId": "BookUniqueId", "CustomerId": "CustomerUniqueId", "OrderStatus": "CONFIRMED", "OrderCost": 100}")
        .withConditionExpression("attribute_not_exists(OrderId)")

TransactWriteItemsRequest twiReq = new TransactWriteItemsRequest()
        .withTransactItems([checkItem, putItem, updateItem]);

//Single transaction call to DynamoDB
DynamoDBclient.transactWriteItems(twiReq);
Listing 1 de Distributed Transactions at Scale in Amazon DynamoDB: una compra que en una sola llamada a TransactWriteItems verifica que el cliente exista, marca el libro como vendido y crea la orden.
¿Cómo se resuelve? Con dos técnicas: un two-phase commit con algunas particularidades, y optimistic locking. Antes del two-phase commit conviene mirar la figura de arquitectura del paper. El authentication system y el metadata system ya los conocemos. Lo que hicieron fue agregar un componente nuevo: el transaction coordinator.
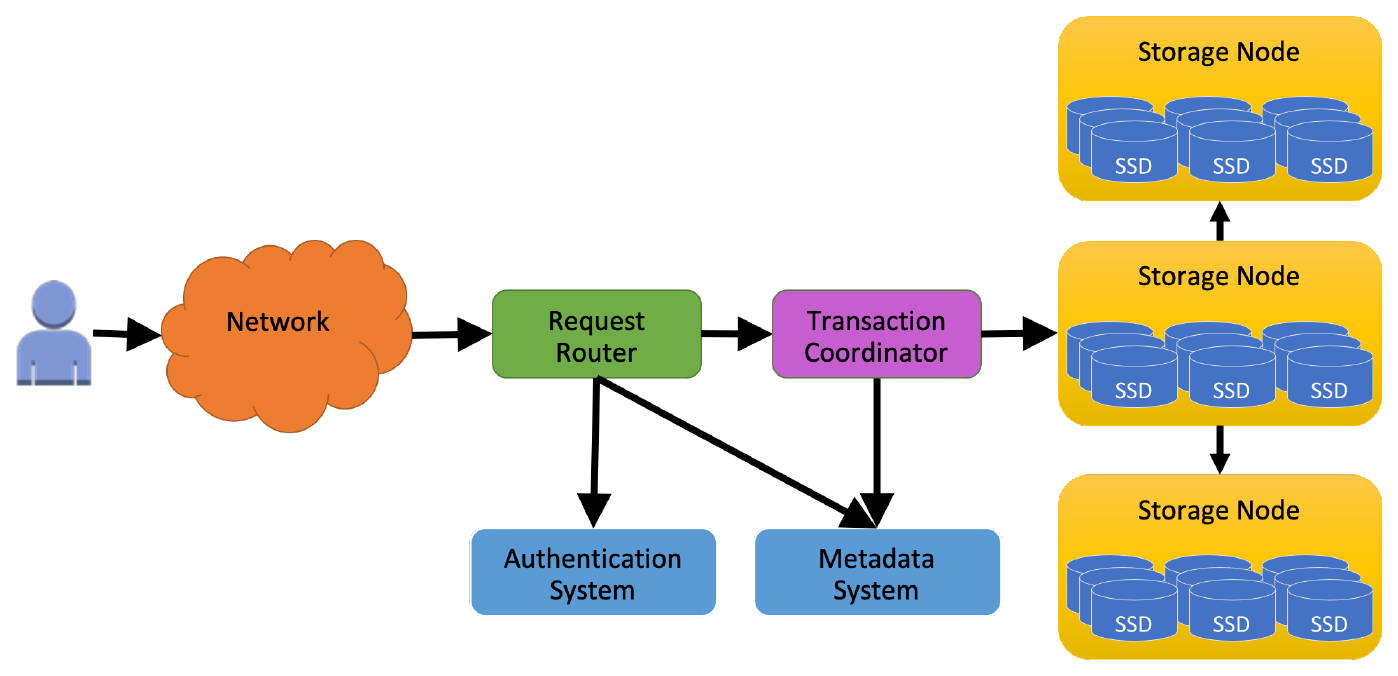
El request router es lo suficientemente inteligente para distinguir los casos. Un put común va directo al storage node, y la diferencia en mensajes es grande: un put suelto es un viaje de ida y vuelta, mientras que una transacción sobre tres grupos de replicación son doce mensajes —tres prepares, tres respuestas, tres commits y tres respuestas— más las escrituras al ledger entre una fase y otra. Pasar por el coordinador un put que no lo necesita costaría un orden de magnitud de más. Si es una de las operaciones Transact…, el router la manda al transaction coordinator, que coordina toda la transacción.
¿Y qué hace el transaction coordinator? Un two-phase commit casi igual al que vimos. Lo que falta es la primera fase, en la que el coordinador mandaba operaciones sueltas. En su lugar usa el propio prepare para mandarlas, que es lo interesante del diseño: adentro del prepare van los puts, deletes o lo que sea, junto con un timestamp —del que nos ocupamos cuando veamos el control de concurrencia optimista—. El storage node evalúa si podría aplicar esas operaciones y responde OK, o no.
¿Por qué así, y no un sistema general al estilo SQL? Según ellos, porque los tiempos tienen que ser predecibles. Si se puede ejecutar cualquier operación rara, la latencia puede ser cualquier cosa. Mandando el paquete entero de operaciones, la latencia es predecible. Por eso ni siquiera hay una fase para mandar operaciones custom: va el prepare con todas las operaciones adentro.
El resto es igual. Le manda el prepare al otro participante con sus operaciones, el otro dice OK, y eventualmente les manda el commit a los dos.
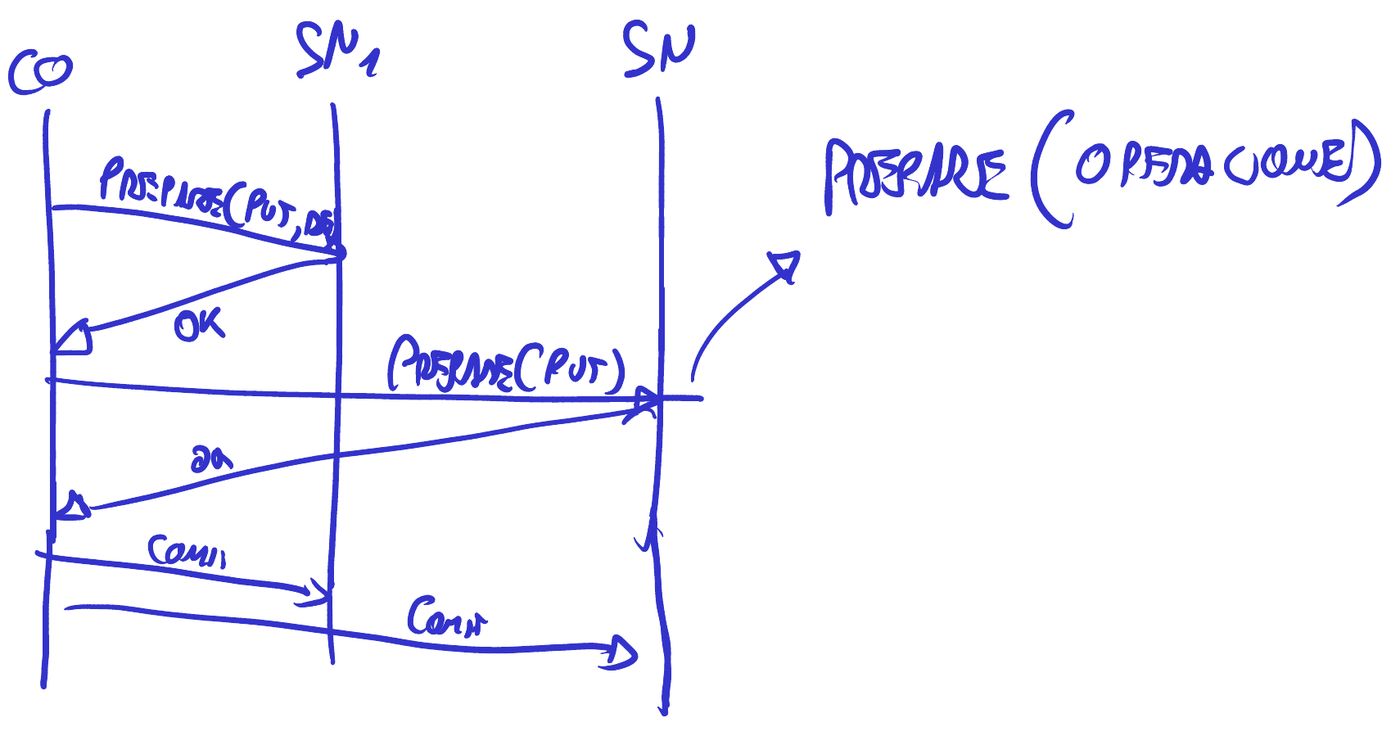
Más allá de usar el prepare para llevar también las operaciones, es un two-phase commit común, con una particularidad más en los locks: el coordinador no obtiene locks pesimistas sino optimistas, que es lo que veremos en la última parte.
Recuperación del coordinador: ledger y recovery manager
El paper también muestra cómo resolvieron la tolerancia a fallas del transaction coordinator, y cómo escribieron el código: incluye un listing con la implementación, dentro del coordinador, de una operación de write items.
TransactWriteItem(TransactWriteItems input):
  #Prepare all items
  TransactionState = PREPARING
  for operation in input:
      sendPrepareAsyncToSN(operation)

  waitForAllPreparesToComplete()

  #Evaluate whether to commit or cancel the transaction
  if all prepares succeeded:
     TransactionState = COMMITTING
     for operation in input:
         sendCommitAsyncToSN(operation)
     waitForAllCommitsToComplete()
     TransactionState = COMPLETED
     return SUCCESS
  else:
     TransactionState = CANCELLING
     for operation in input:
         sendCancellationAsyncToSN(operation)
     waitForAllCancellationsToComplete()
     TransactionState = COMPLETED
     return ReasonForCancellation
Listing 2 de Distributed Transactions at Scale in Amazon DynamoDB: el protocolo de TransactWriteItem en el transaction coordinator.
Lo primero que salta a la vista es una máquina de estados: PREPARING, COMMITTING, CANCELLING. El coordinador, para esa transacción, va pasando por distintos estados. Arranca en PREPARING, y con un for les envía el prepare a todos; después espera las respuestas.
Ahí se decide el destino de la transacción: si todos respondieron OK, va a ser un commit; si alguno no, cancela. Si todo está en orden, pasa a COMMITTING y le manda el commit a cada participante. Espera los OK de todos, pasa a COMPLETED y devuelve success. Es, en código, exactamente lo del diagrama.
El énfasis está en esas etapas y en quién respondió qué. Pero incluso ese detalle se puede reconstruir: lo que hay que recordar sí o sí es en qué etapa estamos, preparing, committing o canceling.
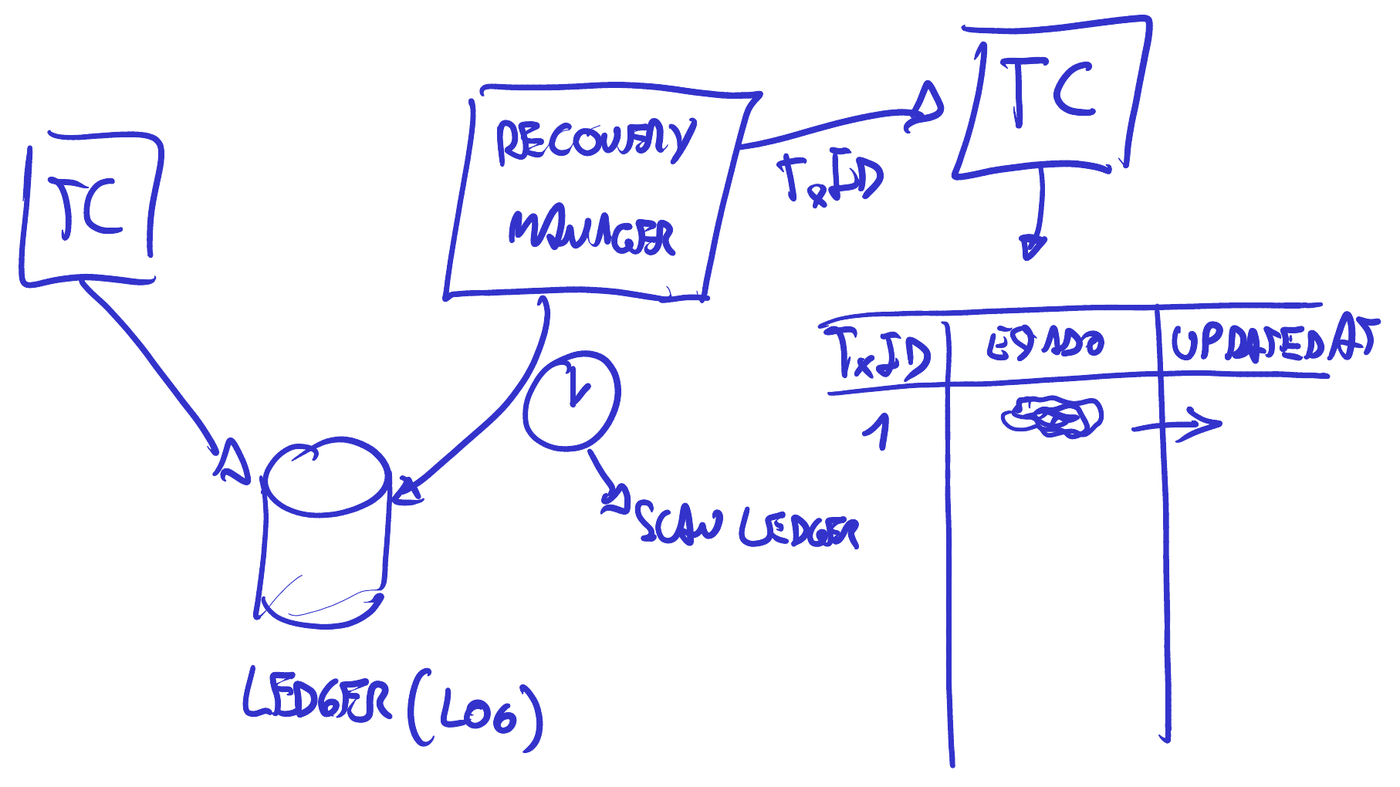
¿Cómo lo hicieron? El coordinador escribe su estado en una base de datos, y esa base es DynamoDB mismo: el transaction coordinator está implementado sobre DynamoDB. En vez de Postgres u otro motor, el estado lo guarda ahí, en lo que conceptualmente es un ledger, otra forma de decirle al log de operaciones. Cada vez que cambia de estado lo actualiza.
El paper no lo dice, pero se puede inferir que la tabla es más o menos así. Tiene el transaction ID; tiene el estado, y con estado nos referimos a todo el estado —no solo si está en committing, sino también quién fue respondiendo OK—, que es lo que le va a servir para recuperarse; y tiene una suerte de updated_at.
La clave es que cada vez que se modifica el estado se actualiza también updated_at. Ese campo sirve para ver si la transacción va avanzando. Y como la latencia es tan predecible, el updated_at debería actualizarse rápido y con frecuencia.
En otra parte del sistema hay otro componente, que no está en la figura, llamado recovery manager. Cada cierto tiempo hace un scan del ledger mirando los updated_at. Si encuentra un registro que supera cierto umbral, una transacción que parece bloqueada porque su estado no se actualiza desde hace un tiempo, toma otro transaction coordinator y le manda el transaction ID que tiene que heredar. El coordinador nuevo lee el estado de la tabla y sigue desde donde el otro se murió.
Todo el sistema está pensado para que, aunque sea un caso patológico, pueda haber dos transaction coordinators coordinando la misma transacción. Los storage nodes implementan prepares y commits de manera idempotente, así que si dos coordinadores mandan dos prepares y dos commits a la vez, el storage node va a notar que es raro, pero no se rompe.
En el caso común aparece otro coordinador cuando el primero murió y dejó de hacer avanzar la operación. Pero la técnica importa en general, porque resuelve el problema que quedó abierto: si muere el coordinador, los storage nodes eventualmente tienen que recibir un abort o un commit, porque de lo contrario todo queda bloqueado. Este componente es la clave: un tercer componente que verifica que todas las transacciones sigan avanzando.
Obviamente debe haber muchos recovery managers, y aparece un problema del huevo y la gallina: ahora hay que hacer tolerante a fallas al recovery manager. Pero eso es más fácil; en general alcanza con varias réplicas escaneando la tabla. Es una forma ingeniosa que se repite en varios diseños.
Los dos conceptos clave, entonces: uno, el tercero que escanea constantemente buscando transacciones viejas y posiblemente bloqueadas; otro, un diseño de coordinadores que permite, en algún caso, que dos coordinen la misma transacción. No debería pasar nunca, pero si por un problema de red el otro sigue mientras el primero revive, no importa demasiado: los dos le mandan coordinaciones a los storage nodes y todo sigue funcionando.