3. Limitaciones de los relojes físicos
Paper de Lamport y relojes desincronizados
El que se puso a pensar este problema fue Leslie Lamport, en un paper que no era el obligatorio de esta clase pero que bien podría haberlo sido. Vale muchísimo la pena leerlo: es el paper más famoso de sistemas distribuidos, y hay quien dice que es el que inició la disciplina. Lo escribió en el 78; un paper fundacional en el sentido fuerte de la palabra.
La referencia completa es Leslie Lamport, Time, Clocks, and the Ordering of Events in a Distributed System, Communications of the ACM, vol. 21, n.º 7, julio de 1978, pp. 558-565.
Lo que hizo ahí —y conviene decir que se puso a pensar antes que decir que descubrió, porque el mérito está sobre todo en haber formulado el problema— fue lo siguiente: si queremos ordenar las operaciones de un sistema distribuido usando el timestamp, el reloj de la computadora, funciona todo mal.
El ejemplo que lo muestra no es de Lamport, es uno construido para entender el asunto, pero resulta suficiente. Supongamos dos procesos separados, un proceso uno y un proceso dos, con el tiempo corriendo de arriba hacia abajo. En algún punto del proceso uno ocurre un evento, E1. Más abajo, en el proceso dos, ocurre otro, E2. Como lo estamos mirando desde afuera, con una visión global que ningún proceso tiene, sabemos con total certeza que el uno ocurrió antes que el dos.
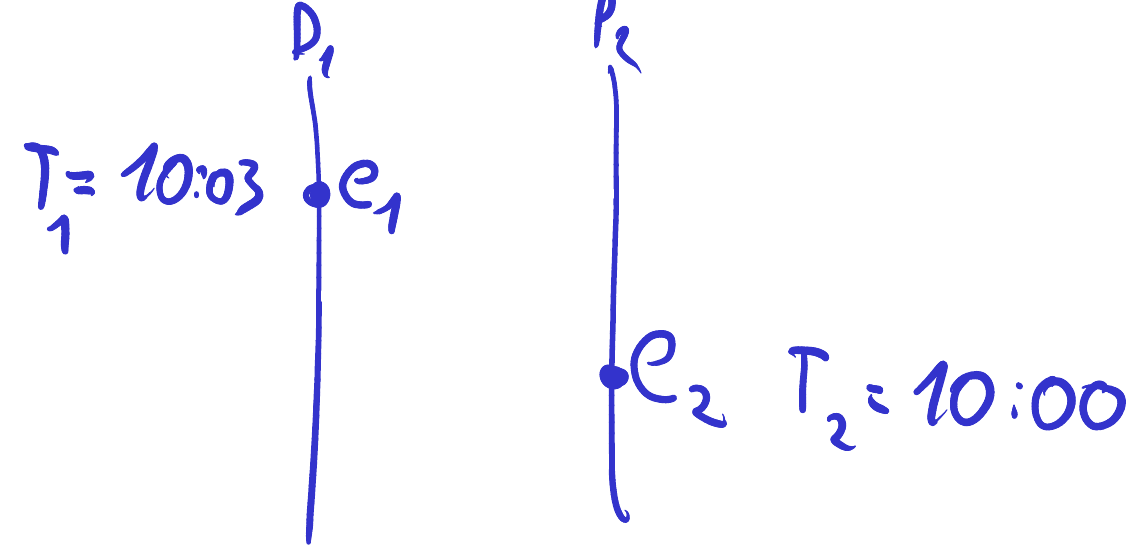
Ahora usemos el timestamp de cada computadora para registrar cuándo ocurrió cada uno. Puede perfectamente pasar que el tiempo de E1 sean las diez y tres y el de E2 las diez en punto. La reacción natural es sospechar un error al anotar los números, pero no lo hay: eso puede pasar simplemente porque los relojes de esas dos computadoras no están sincronizados. Si bien E1 ocurrió antes que E2, la máquina uno puede estar cinco minutos adelantada. Es difícil de pensar, porque la intuición insiste en que el reloj dice la verdad.
Y entonces pasa esto: si un tercero recibe esos dos eventos y los ordena por el tiempo de reloj, la fuente del tiempo fue diferente en cada uno, el reloj que cada máquina tiene en su propio hardware, y va a concluir que la máquina dos ejecutó su evento primero, cuando nosotros sabemos que es al revés.
En un ejemplo tan aislado el problema parece menor. Pero vamos a ir llegando a lugares donde el asunto se complica.
Clock skew
¿Cómo podríamos resolverlo, y por qué es difícil el problema en general? Lo primero que uno intentaría suena razonable: calcular qué tan desincronizados están los dos relojes. A esa diferencia se la suele llamar clock skew, y conviene anotarla como una ε, como si fuera un error. Si la logramos calcular, prácticamente tenemos el problema resuelto: si sabemos que la otra máquina está cinco minutos adelantada, a todo lo que nos responde le restamos cinco minutos.
El problema es que ese ε no se puede determinar con precisión, y el intento fallido de hacerlo explica el asunto mejor que el enunciado.
Tenemos un proceso uno y un proceso dos. Necesitamos calcular el tiempo de un lado, T1, y el del otro, T2, al mismo tiempo; con esos dos números, ε es simplemente T2 − T1. En teoría la cuenta es impecable. Lo que pasa es que estamos en el mundo físico. Pongamos que quien hace la cuenta es la máquina del proceso uno: para saber el valor de T2 le tiene que mandar un mensaje a la otra —un get_time—, la otra calcula su tiempo y en algún momento le responde con un ok y el valor que le salió.
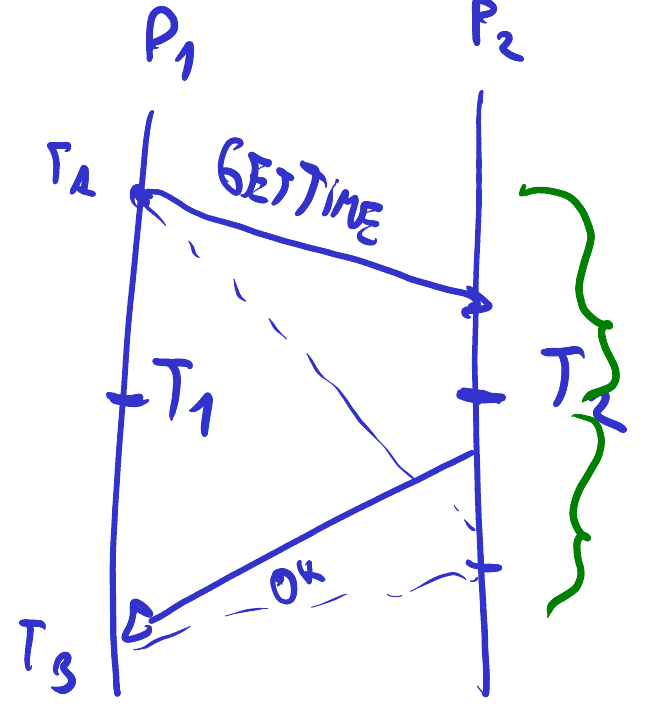
Y lo que no hay forma de saber es cuánto tardó cada mitad del viaje: cuánto la ida y cuánto la vuelta. El mensaje pudo haberse ido rápido, calcularse el tiempo del otro lado y volver rápido; o pudo haber ido lento a la ida y rápido a la vuelta; o de cualquier otra forma. Lo único que conocemos es el total. Ahí está la razón por la cual medir ε es difícil, prácticamente imposible.
Lo único que sí podemos hacer es medir los dos extremos del intervalo contra nuestro propio reloj —llamémoslos TA y TB, el instante en que salió el pedido y el instante en que llegó la respuesta— y después estimar que el cálculo del otro lado ocurrió por el medio. Hacemos el promedio entre TA y TB, lo comparamos con lo que nos respondió la otra máquina, y con eso tenemos un estimativo.
Eso es, en esencia, lo que hace NTP, Network Time Protocol, el que se usa para sincronizar relojes: un protocolo bastante más complicado que en el fondo hace lo mismo, mandar varios mensajes y calcular una especie de promedio entre todas las respuestas para estimar qué tan diferentes están los relojes. Pero siempre va a quedar ese ε, siempre va a haber un pequeño error; nunca vamos a saberlo con exactitud.
Y la culpable es la red. En esos pedidos y sus respuestas, los routers pueden estar congestionados; la ida puede irse por un camino y la vuelta por otro, y eso tampoco lo sabemos; y puede haber colas en el medio, con todo lo que las colas le hacen a la previsibilidad de una demora.
Se puede aproximar bastante mejor cuando la latencia es predecible: cables con una latencia bien definida, de la que se sabe cuánto tarda en ir y en volver, o sincronización por ondas electromagnéticas tipo onda de radio, que es lo que usan los relojes atómicos del mundo. Quien necesita sincronizar dos máquinas conectadas por una red Ethernet común, en cambio, a lo sumo puede usar NTP en una de sus capas de precisión —tiene varias, y usaríamos una de las menos precisas— y obtener un valor aproximado, que nunca va a servir como garantía.
Y ahí está el remate. Podemos aproximar todo lo que queramos, pero si lo que buscamos es corrección matemática de que estos dos relojes están sincronizados, nunca lo vamos a poder afirmar. Con que estén desfasados un nanosegundo, si no podemos saber si es para adelante o para atrás, ya no nos podemos apoyar en eso para resolver un algoritmo.
Dicho eso, hay sistemas distribuidos que usan relojes físicos, y en aquella época todo el mundo sincronizaba así. Lamport se puso a pensar que eso no podía funcionar, y la razón la da él mismo, en el paper y también en una entrevista: está familiarizado con la teoría de la relatividad, y una de sus propiedades es que los relojes no se pueden sincronizar, porque la luz tarda en propagarse; la información de un reloj tarda en llegar hasta el siguiente.
La conexión con la relatividad está explícita en el paper, y no solo en las entrevistas. Al definir la relación de precedencia, Lamport escribe que esa definición “le va a parecer bastante natural al lector familiarizado con la formulación invariante en espacio-tiempo de la relatividad especial”, y remite a Relativity in Illustrations de J. T. Schwartz y Space-Time Physics de Taylor y Wheeler. En el mismo pasaje marca en qué se aparta de la física: en relatividad el orden de los eventos se define en términos de los mensajes que podrían enviarse, mientras que él considera únicamente los que efectivamente se envían, porque quiere poder decidir si un sistema funcionó bien conociendo solo los eventos que ocurrieron.
Obviamente la latencia del get_time no es por la velocidad de la luz —es porque los routers están saturados—, pero la idea es la misma. Como los dos procesos están separados y hay que transmitir la información de un reloj al otro, es un problema circular: nunca tenemos un reloj que podamos sincronizar definitivamente con el de la otra máquina.
Secuenciador centralizado
Hay una forma de sincronizar cosas que ya vimos antes, aunque no con este nombre, y que llega antes que Lamport: tener un lugar centralizado que nos dé números de secuencia. Olvidarse de los timestamps que vengan de nuestro propio reloj y usar una especie de timestamp entre comillas, números de secuencia que nos da un servidor. A ese servidor le podemos decir servidor de timestamps o, como se lo encuentra a veces en la literatura, secuenciador centralizado.
Lo que hace en el fondo es el recurso que utilizamos de vez en cuando, la misma que veíamos en MapReduce y en Google File System: esto es difícil de resolver de forma distribuida, entonces no lo resuelvo distribuido. Se toma una máquina y se declara que esa es la máquina de los timestamps; todas las demás, cuando quieran marcar un mensaje con un valor, tienen que pedírselo a ella.
El ejemplo mínimo son tres líneas de tiempo: en el medio el servidor de timestamps, y a los costados el proceso uno y el proceso dos. El proceso uno le pregunta el tiempo, el servidor le responde con T1, y con eso crea su evento y le asocia ese timestamp. El proceso dos hace lo mismo, recibe T2, y crea su evento con ese otro timestamp.
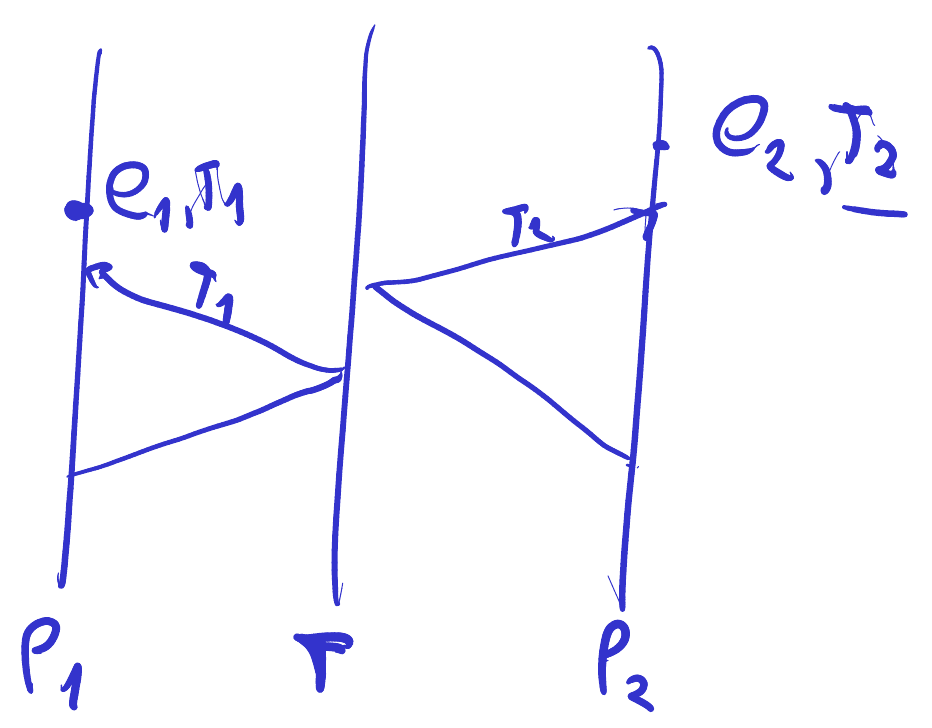
En este esquema tan sencillo ya se vislumbra lo que va a plantear Lamport, que es el giro conceptual de toda la clase: no importa tanto el tiempo real en estos sistemas. Si nos obsesionamos con el tiempo de reloj estamos en problemas. Lo que importa son números de secuencia que nos digan qué cosa ocurrió antes que otra, que reflejen el orden y no tanto el tiempo real, porque rara vez el problema interesante es el del tiempo real. Vale una aclaración de notación: estos números, a pesar de que se escriben con T, no son tiempo físico. Son un número de secuencia global, y son globales porque hay una máquina física emitiéndolos.
El caso concreto ya lo vimos en Google File System. De las tres réplicas, una era el primary, la que tenía los leases; y esa, cuando le mandaba las mutaciones a sus compañeras, les ponía el número de secuencia, y las demás tenían que aplicar las cosas en el orden en que venían numeradas. Ahí aparecía ya el problema del orden, resuelto de forma centralizada.
Los problemas del esquema son dos. Es un único single point of failure: si falla ese servidor, falla todo lo que dependa de él. Y no es distribuido, con lo cual es poco performante.
Nada de eso alcanza para descartarlo. En Google mismo lo usaban, y hay otros sistemas que usan un secuenciador central, o un subsistema dedicado a generar estos timestamps incrementales.
Lo que queda del recorrido es otra cosa: que cambia el foco del tiempo real físico —así lo llama el paper— a este otro concepto, que es el que importa: qué cosa ocurre antes que otra cosa.