3. Ejecución en el clúster y shuffle
En esta sección
Hasta ahora todo fue conceptual: pares, claves intermedias, un agrupamiento que ocurre en un lugar indeterminado. La pregunta que sigue es cómo se implementa sobre máquinas de verdad, y la respuesta pasa por corregir dos veces la imagen que nos armamos.
Jobs lógicos y nodos físicos
En la vida real vamos a tener un clúster de muchas máquinas físicas: el sentido del sistema es repartir el cómputo entre computadoras distintas.
Empecemos con una imagen simplificada, que vamos a corregir enseguida. De un lado, un grupo de nodos mapper: todos los inputs se distribuyen entre ellos y cada uno ejecuta la función map. Del otro lado, otro grupo, los reducers, que ejecutan la segunda parte. Parte de lo que el algoritmo tiene que hacer es esa distribución: enviar los valores de un lado al otro.
Lo primero que no funciona así es esa separación: no hay un conjunto de nodos mappers y otro de reducers, sino el mismo clúster, que primero actúa como mapper y después como reducer.
La razón queda a la vista en cuanto se piensa en los tiempos. No se pueden correr los reducers hasta que no terminen todos los mappers: hay dos fases bien diferenciadas. Con dos clústeres separados, uno iba a quedar ocioso esperando a la otra fase, y eso es un desperdicio de máquinas.
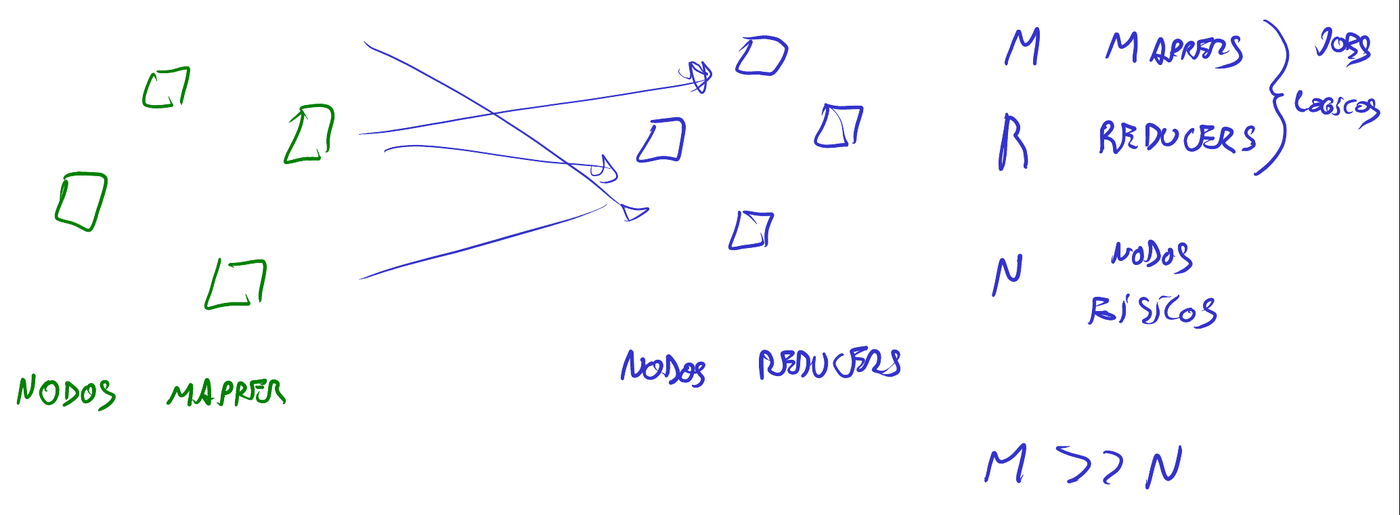
La segunda corrección tiene que ver con el conteo. Hay que ejecutar un mapper por cada input, y ese input puede tomar dos formas: muchos archivos diferentes, o un único archivo de gran tamaño dividido en fragmentos, a los que se les llama splits. Los dos casos dan lo mismo: mil archivos, o un archivo de gran tamaño dividido en mil fragmentos, son mil mappers.
Y ahí aparece lo interesante, porque podemos tener muchos más mappers lógicos que nodos disponibles. Lo que va a pasar es que algunos maps queden a la espera: hay un map listo pero ningún nodo libre que lo tome, así que el cómputo tarda un poco más.
Hay tres cantidades en juego, independientes: M la cantidad de mappers, R la de reducers y N la de nodos físicos. Típicamente no hay relación fija entre ellas, y es muy común que M sea bastante más grande que N; el paper incluso lo recomienda. La razón es doble: así tenemos a todos los nodos ocupados, sin que ninguno espere trabajo, y además nos queda redundancia.
La recomendación está en §3.5, Task Granularity, con los dos motivos enunciados con precisión: que cada worker haga muchas tareas distintas mejora el balanceo de carga dinámico y acelera la recuperación ante la caída de un worker, porque las tareas de map que ese worker había completado se reparten entre todas las demás máquinas en vez de recaer sobre una. El paper da también la cota práctica: el master toma del orden de M+R decisiones de scheduling y mantiene del orden de M×R estado en memoria, a razón de un byte por cada par de tarea map y tarea reduce. Con mil mappers y mil reducers eso es un megabyte: una cantidad despreciable, y de ahí que la granularidad fina resulte tan económica.
Los números concretos dan la escala: el paper dice que suelen correr computaciones con M = 200.000 y R = 5.000 sobre 2.000 máquinas worker, o sea cien tareas de map por máquina. M se elige para que cada tarea quede en unos 16 a 64 MB de input —el mismo rango que los splits— porque así la optimización de localidad de la sección 5 rinde al máximo; y R, como un múltiplo chico de la cantidad de máquinas. R además queda acotado porque el output de cada reduce termina en un archivo separado, así que R es la cantidad de archivos de salida.
Lo que contamos con M y con R, entonces, son jobs lógicos: unidades de trabajo que eventualmente se van a ejecutar en alguno de esos nodos físicos. Quién los asigna lo contestamos más adelante, con la arquitectura.
Aparece una pregunta natural: si un nodo va lento, ¿puede otro tomar su trabajo? Puede pasar que un mismo job se ejecute en varios nodos a la vez, por redundancia. Si el coordinador —y vamos a ver que existe— nota que un nodo está demasiado lento y no progresa, puede asignarle el mismo job a otro como precaución. Termine primero uno u otro, no hay inconveniente: al final tenemos dos versiones iguales del mismo trabajo. Por qué eso no genera inconvenientes se entiende cuando llegamos a la tolerancia a fallas, que está pensada precisamente para esto.
Política de particionado
Entre esas dos fases hay una intermedia con nombre propio: el shuffle. La traducción que conviene tener a mano es “el reparto”, porque es literalmente lo que hace.
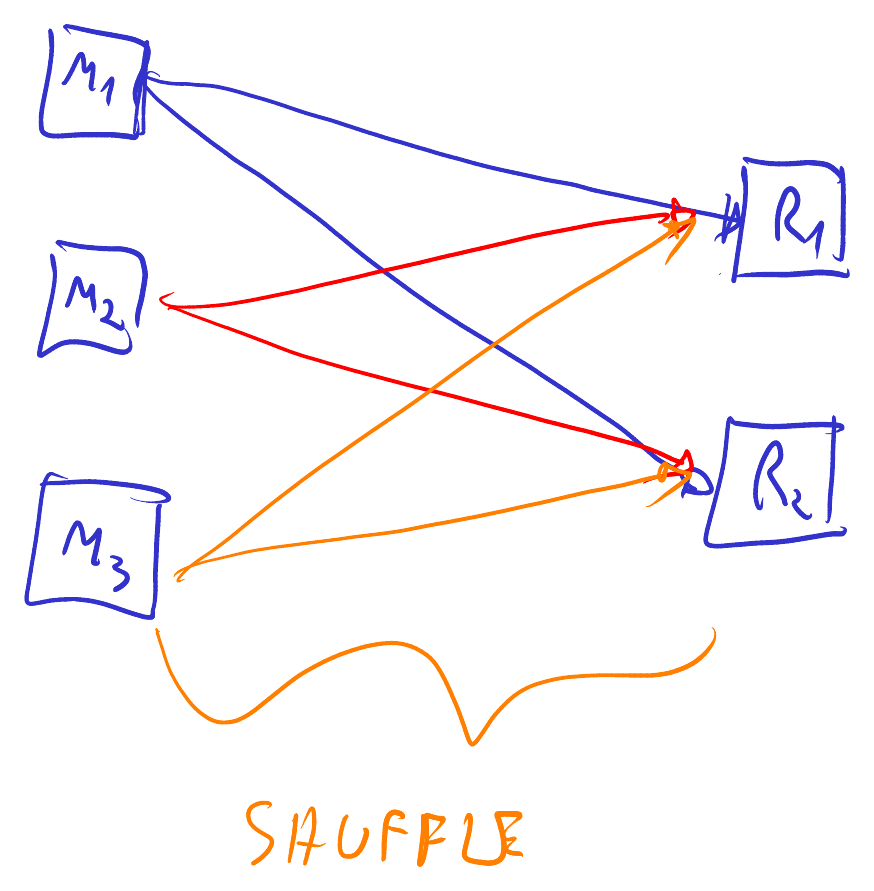
Vayamos a un ejemplo con tres mappers y dos reducers. Podemos imaginar los tres jobs de map dibujados uno al lado del otro, como si se hubieran ejecutado a la vez, aunque fue en momentos distintos: lo que importa es que los tres terminan. Del otro lado, R1 y R2.
Las claves que el mapper 1 va generando las va a tener que enviar, cada una, o a R1 o a R2. Y lo que pasa siempre —salvo con un input demasiado pequeño— es que de cada mapper salen claves para los dos reducers: M1 les envía a los dos, M2 también, y M3 también. Ese conjunto de flechas cruzadas es el shuffle.
Lo que esa fase hace se ve mejor de otra manera. Supongamos que el universo entero de claves intermedias es K1 a K6. ¿Qué son esas claves en el ejemplo de contar palabras? Cada una es una palabra, y el universo es el de las palabras que aparecen entre todos los documentos. Cada una aparece muchas veces.
Lo importante es una sola cosa: que todas las veces que aparece K1 vayan al mismo reducer, para que pueda contarlas a todas. Entonces queremos partir ese universo en dos conjuntos: uno con K1, K5 y K6, que va a R1, y otro con K2, K3 y K4, que va a R2.
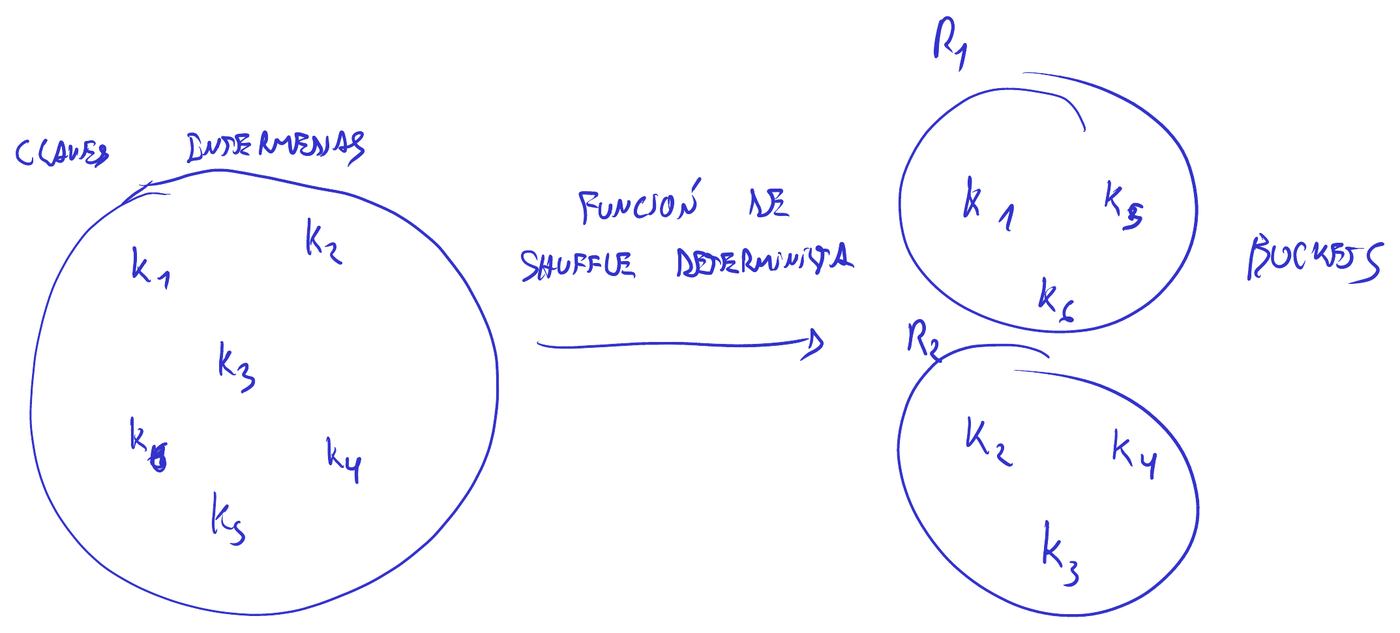
Hasta aquí resulta evidente. Lo que no lo es tanto es quién decide. Deciden los mappers, y todos tienen que tomar la misma decisión, siempre. Si K1 aparece en M1, M2 y M3, los tres tienen que enviarla a R1; y si “mundo” va al conjunto de abajo, los tres tienen que decidir lo mismo. Porque si se mezclan, el agrupamiento pierde todo sentido.
¿Y con qué criterio? En las implementaciones uno puede elegir la función, pero no hay tantas alternativas y siempre se termina haciendo más o menos lo mismo, parecido a cómo funciona una hash table. Lo que necesitamos es una función de shuffle determinista, y esa es la clave del asunto.
La función es la siguiente. Tomamos la clave intermedia y la pasamos por una función de hash: MD5, SHA. Recibe cualquier entrada y devuelve un número muy grande que parece aleatorio, pero no lo es: con la misma entrada devuelve siempre el mismo número. La propiedad que tiene que tener es que sin saber qué se le dio uno no puede anticipar qué va a salir, y que lo que sale está uniformemente distribuido.
A ese número se le aplica módulo R, la cantidad de reducers. Con dos reducers, eso da cero o uno. Hay entonces un ajuste de numeración que conviene explicitar, porque es una fuente real de confusión: a los reducers los venimos llamando R1 y R2, pero el módulo devuelve valores de 0 a R−1, así que hay que leer el 0 como R1 y el 1 como R2.
Con eso, todos los mappers pueden decidir a qué lugar enviar cada clave, y cuando comienza el algoritmo todos tienen que estar de acuerdo en hacer exactamente esto mismo.
¿Es el shuffle simplemente una función de hash, o hay algo más? No hay nada más: hash y módulo. Es exactamente lo que usa una hash table para decidir a qué bucket va cada clave, y esos dos conjuntos en los que partimos el universo son los buckets.
El paper coincide en las dos mitades. En §3.1 dice que las invocaciones de reduce se distribuyen partiendo el espacio de claves intermedias en R pedazos con una función de partición, y da
hash(key) mod Rcomo ejemplo, aclarando que tanto R como la función las especifica el usuario. En §4.1 confirma que es la función por defecto y que tiende a producir particiones balanceadas. Pero ahí mismo da el contraejemplo de que “siempre se hace lo mismo”: cuando las claves de salida son URLs y se quiere que todas las entradas de un mismo host caigan en el mismo archivo, se usahash(Hostname(urlkey)) mod R— se hashea no la clave entera sino la parte por la que se quiere agrupar. La libertad de elegir la función está justamente para eso.