2. Sincronización de los logs
En esta sección
En los escenarios anteriores apareció varias veces el mismo movimiento: el líder nuevo, apenas el sistema se estabiliza, les envía su log a los demás, agregándoles entradas que no tenían o eliminándoles las que les sobraban. Dijimos que el log del líder es el log, sin explicar cómo se lleva a cabo. Corresponde examinar en detalle esa sincronización, que es la parte más difícil de todo esto. Le vamos a dar un nombre: rollback. El paper no usa ese término; describe el mecanismo como el líder forzando a los followers a replicar su propio log (sección 5.3).
Campos de AppendEntries y Log Matching Property
Conviene reducir la escala. Este ejemplo va a ser de tres servidores, S1, S2 y S3, y vamos a observar solamente cuatro posiciones del log: los índices 10, 11, 12 y 13. El estado del que partimos ya lo habíamos visto la clase anterior. En el índice 10 hay una entrada en cada uno de los tres, las tres del término 3. En el 11 hay dos, en S2 y en S3, también del término 3. En el 12 hay dos otra vez, pero no coinciden: en S2 una del término 4 y en S3 una del término 5. Y en el 13 hay una sola, en S3, del término 6.
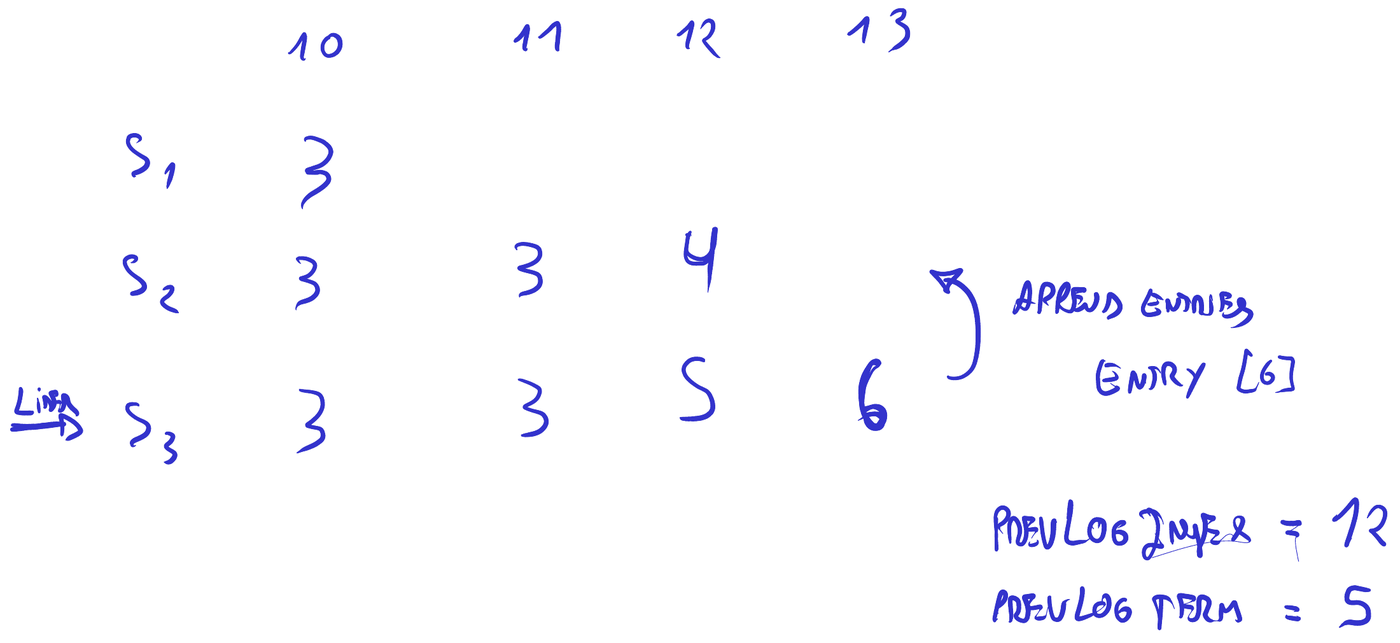
Lo primero es convencerse de que esto es perfectamente posible: no hay ninguna anomalía todavía, es el funcionamiento normal del algoritmo. Reconstruyamos cómo se llega a un estado así.
En el índice 11, uno de esos dos servidores era el líder; supongamos que era S2. Le envían un request nuevo, lo agrega a su log, se lo transmite a S3, S3 lo agrega también, y S2 falla. Estos casos son fáciles de analizar si aceptamos algo que ya deberíamos tener incorporado: que las máquinas fallan y se recuperan con frecuencia. S2 cae y se recupera de inmediato; al recuperarse no recuerda que era líder, así que se produce una nueva elección y resulta electo él mismo otra vez. Justo al ser elegido le envían otro request, que agrega en el índice 12 —esa es la entrada del término 4—, y vuelve a caer. Ahora el electo es S3: apenas es elegido le envían un request nuevo, que aparece en su índice 12 como la entrada del término 5. Cae. Lo vuelven a elegir a él mismo, y aparece el 6.
Esta es una red que funciona muy mal: las máquinas se desconectan y se reconectan permanentemente. Y hay un detalle relevante: apenas un servidor se conecta puede empezar a recibir requests, y esos requests nunca son respondidos al cliente, porque nunca llegaron a un quórum, a una mayoría.
Después la situación se estabiliza. Se acepta el 6, y el líder ahora es S3. Le llega esa entrada nueva, la agrega a su log, y tiene que enviársela a los demás: lo que buscamos es que el log quede idéntico en S1, en S2 y en S3.
Y allí está la idea central del mecanismo: en Raft se aprovecha AppendEntries para todo, y la sincronización de los logs no es la excepción. Lo que el líder le envía a S2 es, por un lado, la entry —la del término 6, aunque lo que dibujamos es el término y adentro va el dato, y cómo se estructura no nos interesa aquí— y, por otro, dos campos más que habrá que implementar: prevLogIndex y prevLogTerm. En este caso prevLogIndex vale 12, porque estamos enviando el índice 13 y el anterior es el 12; y prevLogTerm vale 5, porque 5 es el término que hay en ese índice 12 en el log del líder. Esos dos campos, más que la entry misma, son lo que va a utilizar el que recibe el AppendEntries para decidir si puede agregar correctamente el dato.
Falta justificar por qué con esos dos números alcanza, y la justificación es una propiedad: la Log Matching Property, sección 5.3 del paper, página 7, la propiedad de coincidencia de logs que quedó pendiente cuando hablábamos de las entradas heredadas. Establece que si en dos servidores distintos una entrada tiene el mismo índice y el mismo término, tenemos la garantía —porque así funciona Raft— de que el comando que contiene es el mismo. Y en su forma completa afirma algo más fuerte todavía: que todas las entradas anteriores a esa también son iguales.
Dónde se observa esto en el diagrama: en el índice 11. Esas dos entradas están en la misma posición del log de dos servidores distintos y son las dos del término 3, así que si pudiéramos abrir esa celda y ver el comando que contiene, sería exactamente el mismo. Ese es el caso favorable, y es el que el algoritmo va a buscar.
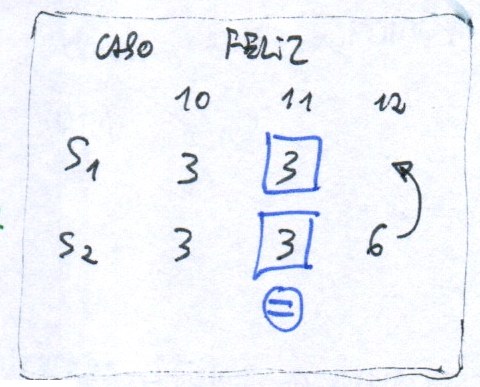
En el índice 12, en cambio, tenemos misma posición pero términos distintos: un 4 en uno y un 5 en el otro. Allí no vamos a tener el mismo comando: van a ser comandos diferentes, que el cliente envió en dos ocasiones diferentes. Y justamente por eso, lo peor que podríamos hacer es también lo más simple: escribir el 6 en el índice 13 de S2, dar el log por sincronizado y continuar. Sería un error grave, porque nos quedarían dos logs divergentes, uno con 3, 3, 5 y 6, y el otro con 3, 3, 4 y 6, y la máquina de estados que cada uno tiene por encima sería diferente.
Rebobinado del log y aviso de commit
Aprovechando esa propiedad, veamos qué hace efectivamente el follower. S2 recibe el 6 y antes de escribir nada verifica el valor que tenía previamente. El índice anterior que le enviaron es el 12, y el suyo también: coincide. El término anterior que le enviaron es 5, y el que él tiene en esa posición es un 4: no coincide. Entonces rechaza el AppendEntries. Qué responde exactamente —un fail, un status incorrecto, alguna otra forma de negativa— es un detalle de implementación; lo que importa es que lo rechaza.
Lo rechaza porque aceptarlo produciría el problema con el que cerramos la subsección anterior. Traducido a palabras, le está comunicando al líder que no puede aceptar esa entrada, que le faltan datos y que necesita las anteriores al 6. El follower no está en condiciones de saber en qué punto exacto los dos logs se separaron; lo único que puede afirmar es que en la posición que le señalaron no hay coincidencia, y que por lo tanto la responsabilidad de retroceder es del otro.
El líder, ante ese rechazo, comienza a rebobinar. El puntero que mantiene para ese follower —nextIndex, en el vocabulario del paper— pasa de 13 a 12. Y ahora le va a enviar dos entradas: toma el 5 y el 6 y se los envía juntos en un solo mensaje. El par de campos que valía 12 y 5 se corre un lugar hacia atrás: prevLogIndex 11, porque ahora la entrada anterior a lo que le envía es la del índice 11, y prevLogTerm 3, el término que hay en esa posición del log del líder. Ese es el patrón: cada vez que le rechazan un AppendEntries, el líder retrocede un índice y el paquete de entradas que envía crece en una.
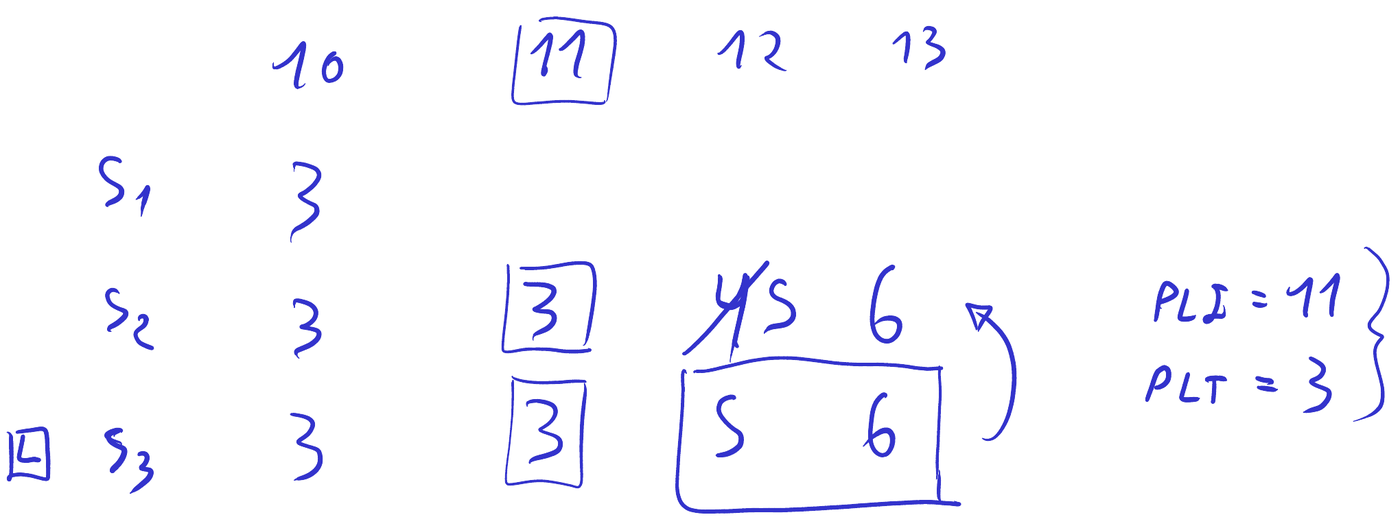
S2 lo recibe y verifica nuevamente. prevLogIndex 11: coincide. prevLogTerm 3: coincide. Esto sí lo puede aceptar. Y es en este punto donde comienza a descartar entradas viejas: descarta ese 4 que tenía en el índice 12 y coloca en su lugar el 5 que le enviaron; y el 6, en el índice 13, donde no tenía nada, directamente lo escribe.
¿Por qué pudo descartar ese 4? Resulta evidente si volvemos a la situación original: ese 4 no estaba comiteado, estaba en un solo lugar, y podría haber sobrevivido como podría no haberlo hecho. Si S1 continúa caído, S3 habría sido elegido líder de todas formas y ese 4 se habría perdido igual. No estamos perdiendo nada que se haya prometido hacia afuera.
Continuemos, porque el commit todavía no apareció. Cuando el follower responde afirmativamente, el líder puede extraer una conclusión: como S2 pudo agregar el 5 y el 6, ahora tanto el 3 como el 5 y el 6 están comiteados. Lo están porque los tiene él y los tiene otro, y este cluster tiene tres servidores: dos de tres es una mayoría, y con la mayoría alcanza. El 3 del índice 11 entra en la cuenta sin que nadie lo haya vuelto a enviar: ya estaba en los dos logs, por debajo del punto donde coincidieron.
Al tener comiteado hasta el 6, en un mensaje posterior aprovecha el AppendEntries siguiente para enviarle leaderCommit, el campo que indica hasta qué punto está comiteado el log. Cuando el follower lo recibe, recién entonces se entera de que el 3, el 5 y el 6 están comiteados, y recién entonces los puede enviar a la capa de aplicación.
Cabe preguntarse quién le avisa a esa aplicación que algo se comiteó. Es Raft: le envía un mensaje indicándole que debe comitear todas esas entradas nuevas. Y hay un supuesto detrás que es importante: Raft asume que esa aplicación no es persistente, que se va formando a medida que se va comiteando. El log avanza secuencialmente y la aplicación lo sigue por detrás; cuando el líder le informa que el commit avanzó, el follower adelanta el puntero, aplica la 5, aplica la 6, y así la aplicación se pone al día.
Si todo esto resulta confuso, la confusión tiene un origen identificable, y es una de las partes que hay que analizar con cuidado al leer el paper: son varias piezas que ocurren en lugares distintos y en momentos distintos. En un momento el líder le sincroniza los logs, y en otro momento posterior le informa que esas entradas que le envió antes están comiteadas.
Costo del rebobinado
Queda una pregunta natural sobre el caso extremo: ¿qué ocurre si el índice y el término no coinciden nunca en el primer intento? La regla es esta: siempre se envían el índice y el término de la entrada anterior a la que se quiere escribir, y se los va comparando contra lo que el otro tiene en esa posición. En algún momento el otro va a responder afirmativamente, y a partir de ese punto agrega todo en un solo paso. Si no coincide, el líder sigue rebobinando de a una entrada por vez.
S1 es el que quedó más atrasado: tiene una sola entrada, la del índice 10. El líder le envía el 6 con prevLogIndex 12, y S1 responde que no tiene siquiera el 12. Rebobina uno y le envía el 5 y el 6 con prevLogIndex 11, y S1 responde que tampoco tiene el 11. Rebobina otra vez y le envía el 3, el 5 y el 6, con prevLogIndex 10 y prevLogTerm 3. Allí sí coincide, y S1 agrega las tres entradas juntas.
De ese recorrido surge el problema que tiene el algoritmo: es lento. El algoritmo base avanza de a una entrada y funciona, y esa es su virtud. Pero si el follower está muy atrasado el costo se vuelve significativo: si había mil entradas de diferencia, van a tener que intercambiar mil mensajes hasta ponerse al día.
Existen optimizaciones para reducir ese intercambio. La idea es que el follower, además de responder negativamente, le envíe información de su propio log, para que el líder no tenga que descubrirla a fuerza de rechazos. Concretamente, el paper propone que en la respuesta negativa se incluya el término de la entrada en conflicto junto con el primer índice que el follower conserva de ese término. Con eso el líder puede saltear de una sola vez todas las entradas conflictivas de ese término, y el costo pasa a ser un AppendEntries por término en conflicto en lugar de uno por entrada. Pero no es tan simple como parece, porque hay alrededor de tres casos distintos. En el video del MIT lo explican bien, y aun así es una parte difícil. Alguna optimización habrá que implementar para el trabajo práctico, porque tiene restricciones de tiempo.
Lo que hay que retener es el algoritmo básico: una entrada por vez, comparando índice y término, y funciona por la Log Matching Property.
Un detalle que aparece al pasar y conviene conservar es cuál es la información que determina todo esto: lo que importa es el índice y el término, no el commit. Los commits aparecen después, porque es el líder quien avisa cuándo comiteó las entradas, y por lo tanto puede haber entradas que tengan quórum y no estén marcadas como comiteadas en ninguna parte. Supongamos que al líder le llega una entrada, la escribe localmente, la escriben también dos followers, y caen todos: el líder no llegó a enterarse de que esos dos la habían escrito, pero en el momento en que cayó había quórum, y eso debería estar comiteado. El índice de commit, de hecho, se reconstruye cuando los servidores se recuperan, y eso lo vamos a ver más adelante.
En el paper, esa optimización se presenta señalando que, si se desea, el protocolo se puede optimizar para reducir el número de AppendEntries rechazados, y después, en un párrafo breve, explica cómo evitar tantas idas y vueltas. Los autores la presentan como opcional y aclaran que dudan de que sea necesaria en la práctica, porque las fallas son poco frecuentes y es improbable que se acumulen muchas entradas inconsistentes. Conviene leer el paper en detalle, que está bastante claro.