6. Lecturas transaccionales
En esta sección
Snapshot read
Todo lo anterior fue para las escrituras. Para los reads transaccionales también hay que hacer cosas, y terminamos por ahí. Un transactional read es el problema del snapshot read, un tema que vamos a ver bastante más en Spanner.
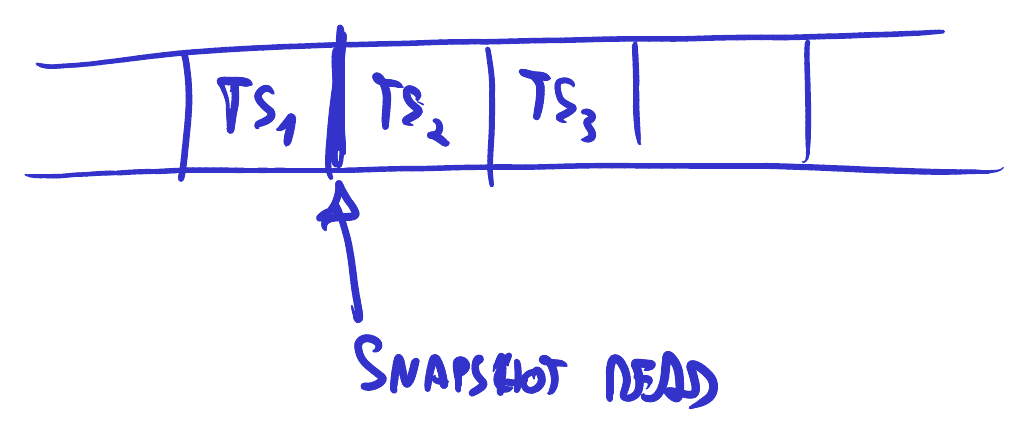
Tomemos el hilo de todas las transacciones: la uno, la dos, y así. Entre transacción y transacción queda dibujada una línea divisoria, y esas líneas son lo interesante. Es como una máquina de estados —ni siquiera distribuida—: la base va pasando de un snapshot a otro según las transacciones que llegan. Y como las transacciones son serializables, es decir, como si hubieran ocurrido una después de otra, conceptualmente se pueden identificar esos lugares intermedios y leer el estado del sistema exactamente ahí. Eso es un snapshot read: leer todos los valores tal como estaban en ese punto.
Qué no es un snapshot read es más fácil de pensar, y se parece al primer ejemplo de la clase. Dos transacciones, la primera con timestamp TS₁ y la segunda con TS₂. En la primera queda x = 1 e y = 1; en la segunda, x = 2 e y = 2. Mandamos un get x y un get y. Si no se manda como snapshot read o read transaccional —que vendrían a ser lo mismo—, nos puede caer una lectura de cada lado: el get x antes de la segunda transacción y el get y después. El primero da 1 y el segundo da 2.
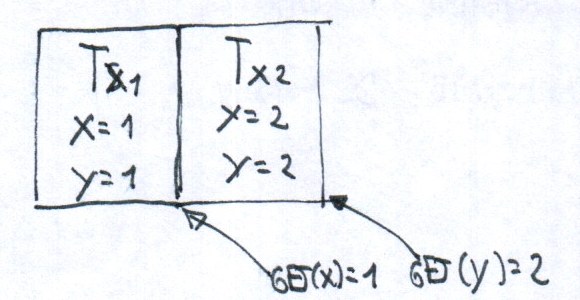
Y ese snapshot no existió nunca. Existió el estado con x e y en 1, y el estado con x e y en 2, pero el que armamos con esas dos lecturas no existió. Con lecturas sueltas, entonces, no funciona. Queremos transacciones también para las lecturas, precisamente para evitar esto.
Timestamp ordering en lecturas
El timestamp ordering de Bernstein sigue funcionando del mismo modo. Volvamos a la tabla: clave, valor y timestamp. Tenemos x con valor 2 y su timestamp.
La clave es que a la transacción de lectura también hay que ponerle un timestamp. En principio no lo vamos a guardar en ningún lado, pero la transacción tiene que tenerlo. Mandamos un get x con timestamp 9, por ejemplo, el que nos asignó el transaction coordinator; al ser una lectura, ese valor se manda a la tabla.
El sistema infiere que ese 9 es más viejo que el de escritura del ítem. Si ejecutáramos la lectura no leeríamos el valor de ese momento sino uno más nuevo, así que la rechaza. El cliente tiene que volver a mandarla, con la esperanza de que todos los valores sean más viejos que su timestamp.
Más formalmente: el timestamp del read tiene que ser mayor que el timestamp del ítem. Queda la duda de si podría ser igual, y qué dice el paper habría que verificarlo; pero si se cumple esa condición el mecanismo funciona. Eso garantiza que, si todos responden que sí, leímos el valor actualizado de todos los participantes.
Timestamp de lectura del ítem
Hay un caso más sutil: qué pasa si se lee un valor y después llega una transacción de escritura más vieja. Es algo más difícil de entender que lo anterior, pero no tanto.
Tenemos x con valor 2 y timestamp 10. Vino una lectura: get de x con timestamp 12. No hay conflicto: le respondimos OK. Después llega una escritura, un put de x con cualquier valor, pero con un timestamp más viejo: 11.
Esta es la parte fina. Si ya respondimos transaccionalmente una lectura con timestamp 12, y viene una escritura más vieja que esa lectura, la escritura se tendría que rechazar: hay que rechazar escrituras que, si se hubiera linealizado todo, romperían el orden. Tiene sentido: si dibujamos las transacciones en orden, tuvimos una lectura en un punto, y llega una transacción que modifica el valor leído y que se ubica antes de nuestra lectura, hay una inconsistencia con la regla que nos autoimpusimos: el timestamp define el orden en que teóricamente se ejecutaron las transacciones.
Esa escritura tiene que ser rechazada, pero con los datos que tenemos no podemos: el 10 de la fila es más chico que el 11 que nos mandan, así que la verificación que teníamos la aceptaría.
¿Cómo se soluciona? Se le ponen al ítem dos timestamps, uno de escritura y otro de lectura, lo cual es atípico. Cada vez que se lee el valor se actualiza el timestamp de lectura, de manera que si llega un write que lo hubiera modificado antes, comparamos contra los dos. Si el timestamp que viene es posterior a ambos, se acepta; si alguno es más nuevo, se rechaza. Y ahí funciona, porque 11 es más chico que 12.
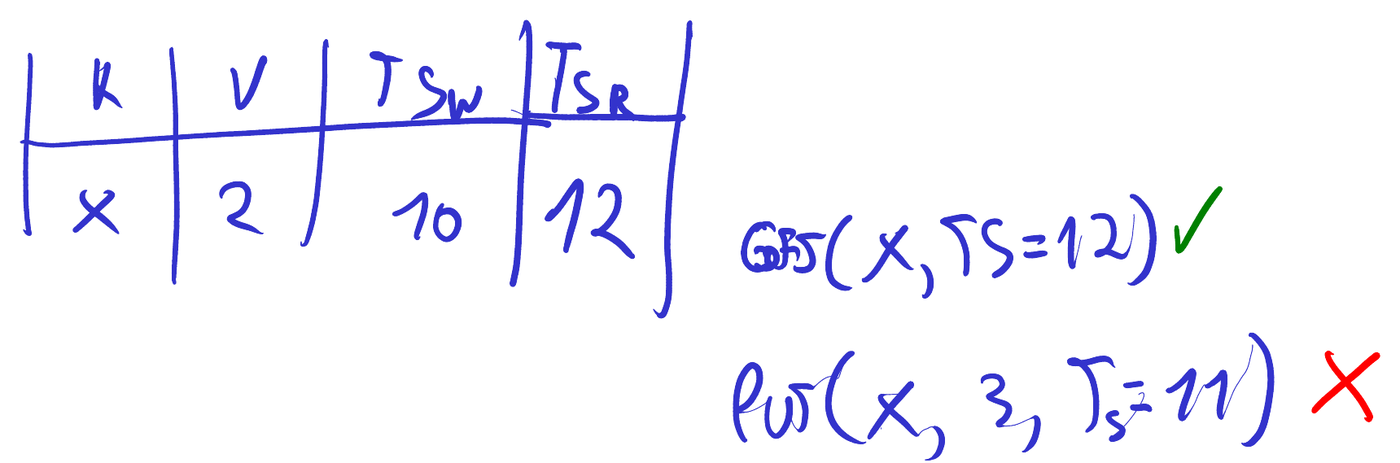
Esta es quizás la parte menos intuitiva del algoritmo. ¿Por qué? Porque una lectura produce una escritura en la base. El get, aunque lee, tiene que acceder en modo escritura para actualizar el timestamp de lectura. Y si hay cachés u otras capas intermedias, esto complica bastante el diseño: es una lectura que no es una lectura, una escritura encubierta.
Two-phase read
Los ingenieros de Amazon señalan que no querían eso. No querían que, por agregar transacciones, todas las lecturas se transformaran en escrituras, que en general son mucho más costosas. Lo que hicieron es ingenioso, aunque también puede dar falsos positivos: un two-phase read, que es básicamente leer los mismos valores dos veces.
Mismas transacciones de antes: x = 1 e y = 1 de un lado y x = 2 e y = 2 del otro. En la primera fase el cliente lee todo normal, con lo cual puede leer uno de cada lado: get x = 1 y get y = 2. Ese es el caso a rechazar, porque leyó mitad de un estado y mitad del otro. ¿Cómo lo detectan? Esa fue la fase uno; ahora lee todo de nuevo, get x y get y otra vez, y le da 2 y 2. Compara ambas lecturas, dieron distinto, entonces falló: no fue un snapshot read, se intercaló una transacción, la operación falla y el cliente reintenta.
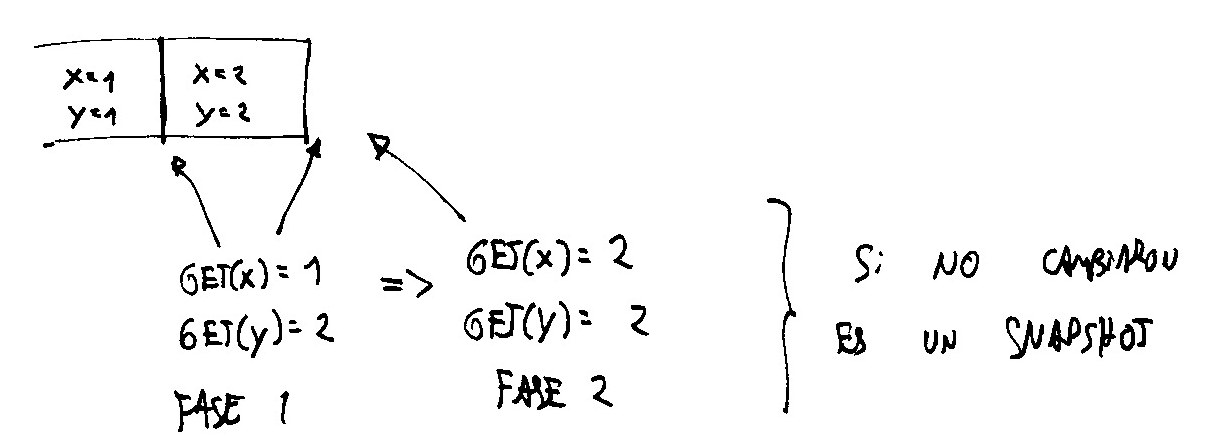
Un detalle de implementación: según el paper, no compara los valores directamente sino la posición en el log de cada ítem, su log sequence number (LSN). Los grupos de replicación de DynamoDB tienen un log interno, como el de Raft, aunque lo que corren es multi-Paxos. Cada valor escrito queda asociado a una posición del log; si las posiciones son iguales, el ítem no cambió; si son diferentes, cambió. Además, verifica que ningún ítem tenga una transacción preparada encima. No compara el ítem directamente porque, si es grande, sería una comparación costosa y un desperdicio, aunque eso no importa tanto.
Esto puede dar falsos positivos; cuál es exactamente ese caso queda como duda abierta, no lo tenemos anotado. Pero así lo resolvieron. Se llama two-phase read, y lo que hace es simple: leer todo dos veces y, si coincide, darlo por bueno, como si se hubiera leído transaccionalmente. El precio es exactamente el doble de lecturas, y eso eligieron antes que convertir cada lectura del sistema en una escritura.
Con eso llegamos al final de la primera mitad de las transacciones distribuidas. El paper le dedica muy poca atención a este tema: es el read transactional protocol, y son dos párrafos. El oficial, el que corresponde de verdad, sería usar la escritura adicional para garantizar ese caso.
Todo esto era además una excusa para dar el timestamp ordering, que contradice todo lo de los relojes de Lamport: es otro caso donde se usa tiempo físico de verdad para garantizar la concurrencia. ¿Y dónde estaba lo optimista? En las cruces. Cada cruz roja en lugar de un tilde verde implicaba que quien hace la operación falla y tiene que reintentar. Nadie se queda esperando, y el sistema no reintenta automáticamente por nosotros. Ahí está lo optimista: asumir que la cosa iba a funcionar, descubrir al final que falló, y volver a intentar. Es una apuesta, y como toda apuesta se paga cuando sale mal —con un reintento del lado del cliente— a cambio de no hacer esperar a nadie mientras sale bien. En Spanner la apuesta va a ser la contraria.