8. Reconfiguración: split-brain y servicio de configuración
En esta sección
Toda la sección anterior descansó en una suposición provisoria: que hay alguien, externo a la cadena, que detecta la falla y reconfigura el sistema. Conviene hacerse cargo de esa deuda, y para eso hay que precisar qué queremos decir con configuración. No se trata tanto de archivos de configuración como de la estructura básica del sistema y de cuándo cambia: cuándo se agrega un nodo, cuándo se quita uno, o cuándo decimos que tal nodo es el head y tal otro el tail. A eso se lo llama reconfiguración, y suele ser un problema en sí mismo. La pregunta abierta se enuncia en una línea: quién reconfigura y quién detecta las fallas. Y aquí se complica todo, porque la conclusión va a ser que no es trivial que estos nodos detecten por sí mismos que otro dejó de funcionar.
Split-brain
Si el único problema que tuviéramos fuera que falla un nodo solo, no sería tan complicado: un nodo no puede comunicarse con el que le sigue, se comunica con el que está después de ese y con eso alcanza. El problema son las particiones de red.
Y no es una hipótesis improbable: muchos de estos esquemas ubican intencionalmente los nodos en data centers distintos, para que si falla uno entero no falle todo. Es plausible que media cadena esté en un data center y la otra mitad en el otro, y que en algún momento se pierda la conexión. Para complicarlo más, pensemos que hay clientes de los dos lados.
Ubiquémonos en el lugar del nodo que está justo antes del corte. Ese nodo puede detectar que algo falló; asumamos que el sistema intenta reconfigurarse de manera autónoma. Va a intentar comunicarse con el que le sigue y va a descubrir que no responde; va a intentar con el siguiente, y ese también está caído. Y como todo esto es un fail-stop, no tiene forma de diferenciar si falló la red o si fallaron esos dos nodos. Entonces puede decidir, erróneamente, autopromoverse a nueva cola y empezar a operar con los clientes de su lado, aceptando escrituras y procesándolas entre los nodos que le quedaron.
Lo mismo, y esto es lo grave, puede ocurrir del otro lado del corte. El nodo que quedó justo después venía recibiendo heartbeats del que estaba antes, y es eso lo que le permite detectar que dejó de recibirlos. Va a intentar comunicarse con el head y le ocurre lo mismo: concluye que esos dos nodos fallaron, sin advertir que hay una partición. Y unilateralmente empieza a reconfigurar todo, informándole a su cliente que ahora él es el head y tal otro el tail.
Lo que termina ocurriendo es que esto, que conceptualmente era un único sistema con un único estado replicado, se convirtió de repente en dos sistemas independientes, y el estado empieza a evolucionar por separado en cada uno. Las operaciones que envía uno de los clientes nunca llegan al otro lado, y a la inversa. Es un escenario muy serio.
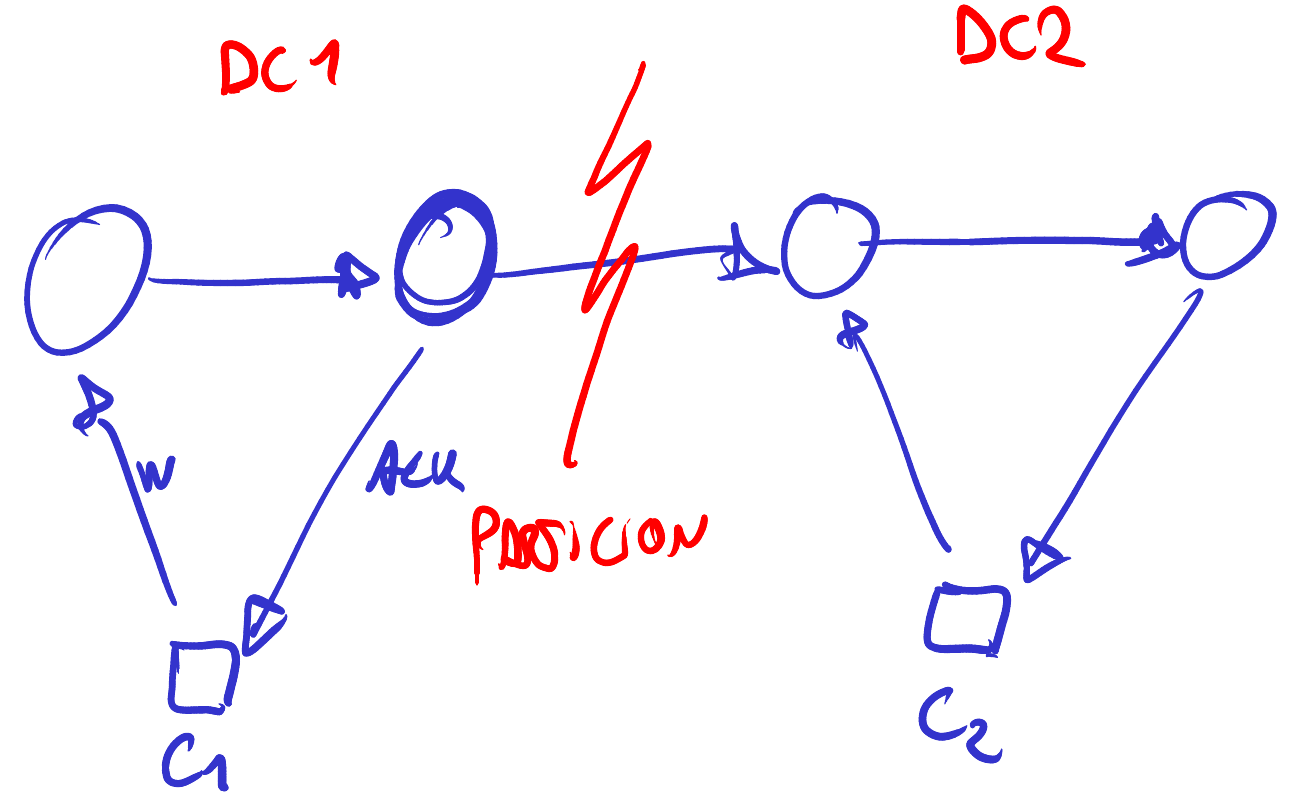
Se llama split-brain, y la metáfora es elocuente: lo que antes era un único sistema distribuido con estado, por haber tomado decisiones incorrectas, se autoconfigura y se parte en dos. Vamos a volver sobre él en varias clases, porque es de los problemas más difíciles, si no imposibles, de resolver. Automáticamente casi nunca se puede: la estrategia es evitarlo, y cuando de todos modos ocurrió, la reparación es manual. Si lo que se guardaba eran pedidos de compra y transferencias, eso significa convocar a los abogados y determinar a quién devolverle el dinero, porque a alguien le puede haber quedado el saldo en negativo: compró en los dos lugares al mismo tiempo y parecía tener más de lo que tenía.
Por rudimentaria que fuera nuestra versión original, la del primary con sus backups, ahí esto no puede ocurrir, y la razón está en la metáfora misma: el cerebro es uno solo. Si ese cerebro deja de funcionar, a lo sumo perderemos datos, pero no aparecen dos estados evolucionando en paralelo. Y si teníamos el log fuera del sistema, Kafka tampoco tiene ese problema, ni lo tienen los nodos que consumen de él. Es decir que el split-brain aparece cuando construimos algo en principio muy simple, pero sin definir quién reconfigura el sistema.
Servicio de configuración
¿Cuál es el mecanismo para evitarlo? A estos sistemas de chain replication se los combina con un servicio de configuración. Ese servicio va monitoreando el estado de cada nodo y detecta cuando algo falla; la configuración nueva se decide dentro de ese servicio, y es él el que se la comunica a los demás. Nadie se autopromueve por su cuenta.
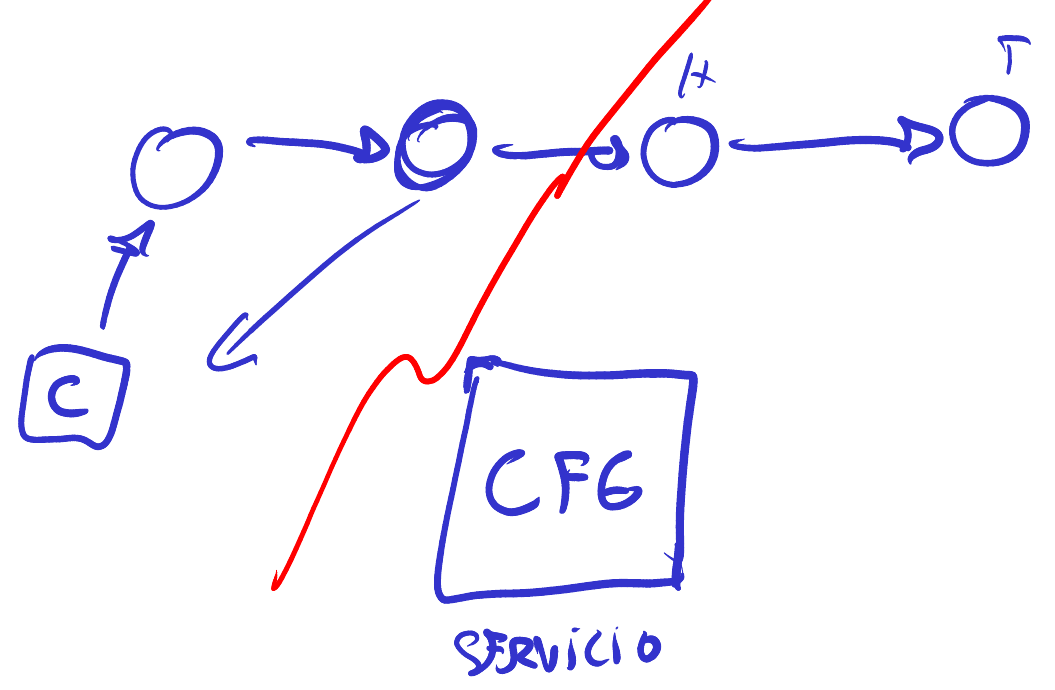
Evidentemente, para que esto no sea otra vez el problema del huevo y la gallina, ese servicio tiene que soportar particiones. Y hay varias formas de resolverlo.
La forma más simple es que ese componente lateral sea una máquina sola. Parece demasiado elemental, pero es lo que termina haciendo Google File System: una máquina sola que cumple varias funciones, y uno de sus roles importantes es decidir, cuando algo falla, cómo se reconfigura el sistema.
¿No es esto una especie de proxy, que cuando falla un nodo le envía el pedido al siguiente? No, y la distinción importa: los requests de escritura y lectura no pasan por el servicio de configuración. Lo que ese servicio tiene internamente es un storage que guarda cómo tiene que conectarse cada componente con cada componente. Si detecta que una máquina falló, primero guarda el estado actual y después les comunica a todas cómo se tienen que reconfigurar. Se asemeja mucho más a una base de datos con metadata que a algo por donde circulen los datos.
En algunos lugares vamos a encontrar que a esto se lo llama el control plane, en contraposición al data plane, que es donde están los datos. No hace falta detenerse demasiado en eso ahora, es terminología; cuando veamos ejemplos concretos va a resultar evidente cuál es cuál.
Los sistemas que se usan para esto tienen nombres que después vamos a ver con detenimiento. ZooKeeper se usa mucho, y también etcd, que es el que usa Kubernetes para guardar el estado de dónde está cada pieza. Son, en definitiva, sistemas de storage.
Volvamos a la versión simplificada, la del servicio como una única máquina, para ver qué ocurre con la partición. Al ser una máquina sola, va a quedar de un lado o del otro, y lo que observa es que todas las máquinas del otro lado dejaron de funcionar. Entonces reconfigura la mitad que tiene disponible: le indica al cliente de ese lado que ahora el head es tal nodo y el tail tal otro. Y así toda la red de un lado puede seguir funcionando, y la del otro no.
¿Qué le ocurre a la mitad que quedó aislada? No se reconfigura. El cliente de ese lado envía escrituras, llegan hasta el final de su mitad, pero nadie le envía los acknowledge, porque el tail no existe de ese lado y esa mitad no puede decidir por sí sola reconfigurarse. El resultado es poco elegante: el cliente sigue realizando retries y esa mitad queda inconsistente y no operativa por un tiempo, hasta que se restaure la conexión y el servicio les indique cómo restaurarse.
Pero el punto es ese: no ocurrió el split-brain. Eliminamos una mitad entera del sistema y seguimos operando con la otra. Parece drástico, y lo es, pero suele ser la forma estándar de evitarlo: cuando se divide la red, una mitad avanza y la otra queda no disponible.
La otra forma interesante es que el servicio de configuración en sí mismo sea tolerante a particiones: en vez de un nodo solo con una base de datos interna, puede estar implementado con Raft. Si observamos ese componente en detalle vamos a encontrar típicamente tres o cinco nodos. Tomemos cinco: si una partición deja tres nodos de un lado y dos del otro, Raft decide que continúe la mitad que quedó con la mayoría. Así el servicio se autoconfigura y tolera fallas —si falla cualquiera de esos nodos sigue funcionando—, y además esos tres alcanzan para actualizar después el estado de los otros dos.
Y de paso queda claro por qué esos números son impares. Con cinco la mayoría es tres, así que sobrevive a dos caídas; con cuatro la mayoría sigue siendo tres, de modo que sobrevive a una sola: la cuarta máquina cuesta lo mismo y no aporta ninguna tolerancia adicional. Es una idea que vamos a reencontrar varias veces: Raft en el rol de servicio de configuración.
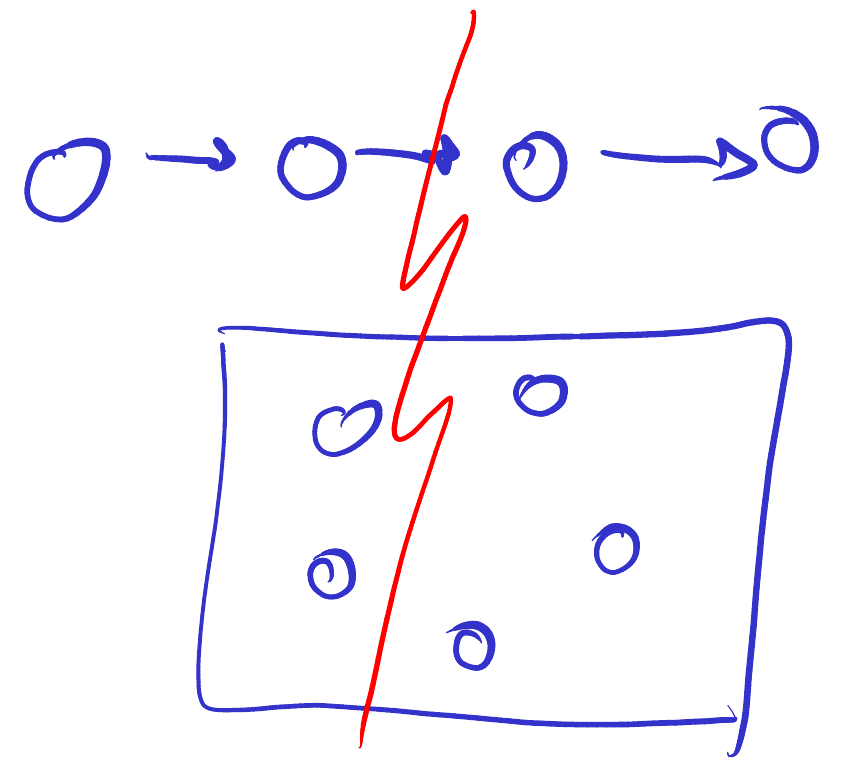
Resta un último punto: el sharding y la replicación casi siempre ocurren juntos. La clase que viene vamos a ver un sistema que usa los dos a la vez, un file system distribuido donde los archivos se dividen en fragmentos —ahí está el sharding— y cada fragmento está replicado en tres, cuatro o cinco lugares, sin necesidad de que ese número sea impar. Es Google File System, y evita el split-brain con un coordinador centralizado, la forma más simple de la que hablábamos.
Si miramos hacia atrás, hay una sola pregunta debajo de todas las respuestas: quién decide el orden. El log externo lo resuelve dejando que decida Kafka; el primary-backup, dejando que decida el primary, unilateralmente; la cadena, dejando que decida el head y que el tail confirme. El split-brain es lo que ocurre cuando nadie definió quién decide y dos mitades creen tener ese derecho al mismo tiempo. Y el servicio de configuración no escapa a la pregunta: la vuelve a plantear un nivel más arriba, porque ahora alguien tiene que decidir quién decide. Ese retroceso podría continuar indefinidamente, y lo interesante es que en algún momento se detiene: cuando un grupo de nodos consigue ponerse de acuerdo entre ellos sin que nadie externo arbitre. Ese acuerdo es lo que ya habíamos nombrado al destilar la replicación —decidir cuál es la siguiente operación—, y es el gran problema al que le vamos a dedicar las clases que siguen.