7. Control plane y data plane
En esta sección
Auto-admin y control plane
Queda un componente que no estaba en el dibujo, y es de lo poco del paper que hay que leer con atención: el auto-admin, que implementa un control plane para DynamoDB.
La intuición es esta. Un sistema con millones de usuarios, además de soportar put, get y update sobre los datos, tiene que soportar muchos pedidos de otra clase: crear, eliminar y monitorear tablas. Con millones de usuarios, crear una tabla deja de ser algo excepcional y pasa a llegar todo el tiempo, igual que los puts. No puede haber gente creándolas a mano, ejecutando comandos uno por uno: a esa escala, todo tiene que estar automatizado.
Eso lleva a un criterio de diseño muy aplicado en servicios para muchos clientes, y en particular en los multi-tenant: la separación entre control plane y data plane.
Operaciones de control y de datos
Las operaciones de cada lado ya dan una idea. En el data plane están put item, get item, update y delete: poner, leer, modificar y borrar un item. Del otro lado hay operaciones de otra naturaleza, que no tocan ningún item: create table, create index, update table. Y en ambos casos hay muchas más.
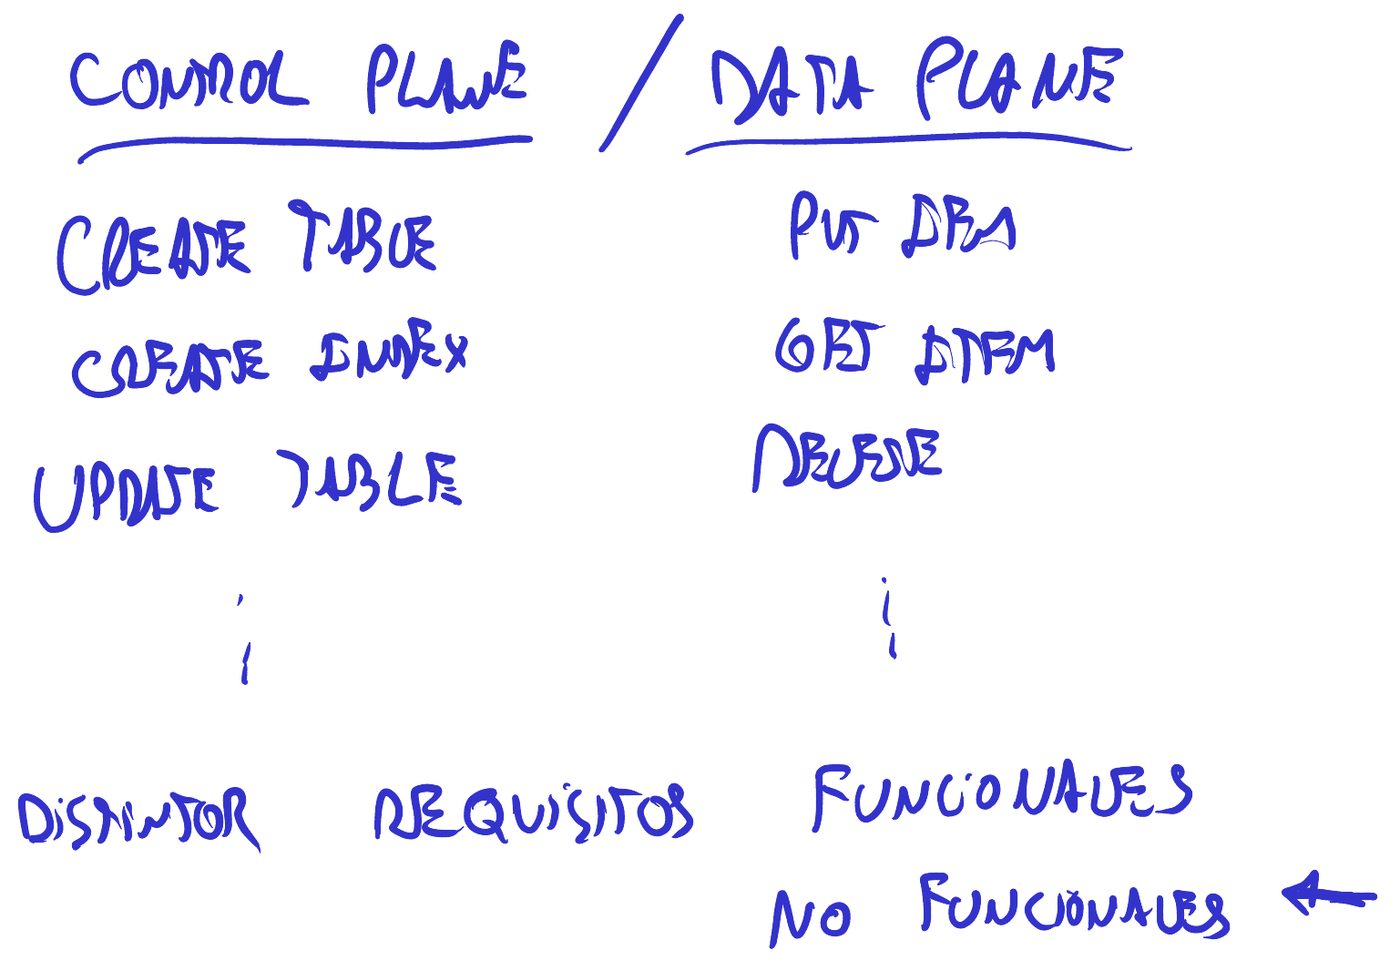
La primera intuición es que, aunque el servicio tenga un SLA de disponibilidad y latencia, las dos categorías no necesitan la misma disponibilidad. Si los usuarios no pueden escribir ni leer items van a estar insatisfechos, y con razón: esa mitad necesita alta disponibilidad. Pero si se cae cinco minutos, o incluso una hora, la parte que crea tablas y las actualiza, no es tan terrible.
Es decir, las dos partes tienen distintos requisitos: son dos subsistemas con requisitos funcionales y no funcionales diferentes. Funcionales, evidentemente, porque atienden operaciones distintas. Pero lo interesante es que la disponibilidad, un requisito no funcional, no es uniforme en todo el sistema.
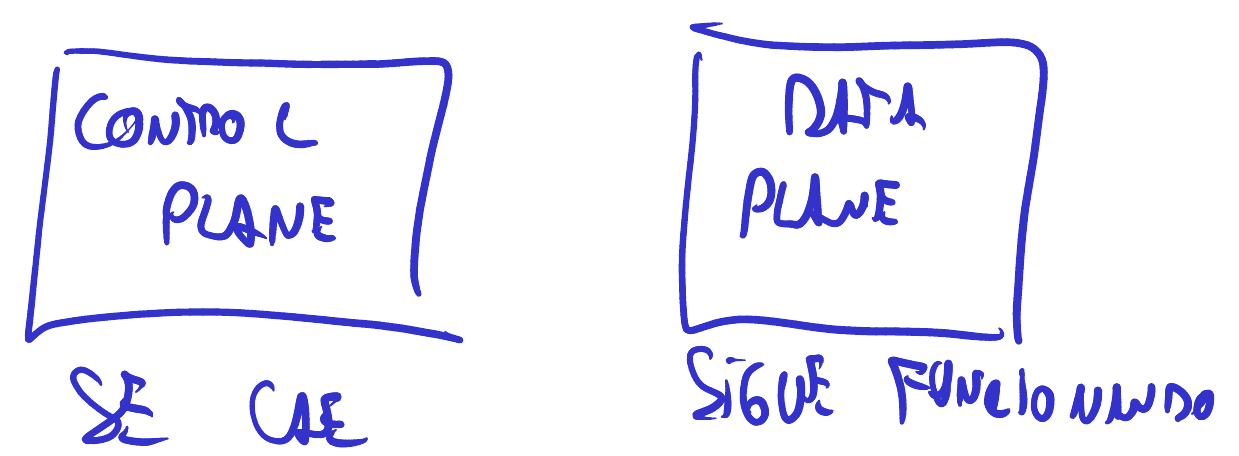
Con eso podemos definir los términos. El data plane son los requests en tiempo real sobre los datos. Cuando un cliente contrata a un proveedor de cloud, lo que contrata es básicamente el data plane: el SLA y las garantías son sobre él, y es lo que paga y le interesa. El control plane gestiona el sistema mismo: crear, administrar y monitorear tablas. A escala cloud ninguna de esas tareas puede quedar en manos humanas, así que hace falta un subsistema dedicado.
Dicho de otro modo: queremos que el control plane pueda caerse y el data plane no. Para eso hay una separación bastante física entre los dos: dos subsistemas que se comunican de forma muy estratégica, sin dependencia fuerte entre ellos. El data plane, en general, no necesita del control plane para funcionar.
Ejemplo: create table
Seguir un create table desde que entra muestra para qué sirve esta separación. El pedido llega al auto-admin. Del otro lado está el clúster de data nodes: miles, distribuidos en distintas ubicaciones. Ante un create table hay que elegir algunos de ellos, crear ahí las particiones y réplicas de la tabla, y configurar los grupos de replicación.
El auto-admin lo hace en dos movimientos. Primero registra en el partition metadata los storage nodes elegidos, para que dónde vive cada rango quede asentado antes de que alguien lo necesite. Después les manda a los elegidos la configuración inicial para inicializar la tabla en esos tres lugares.
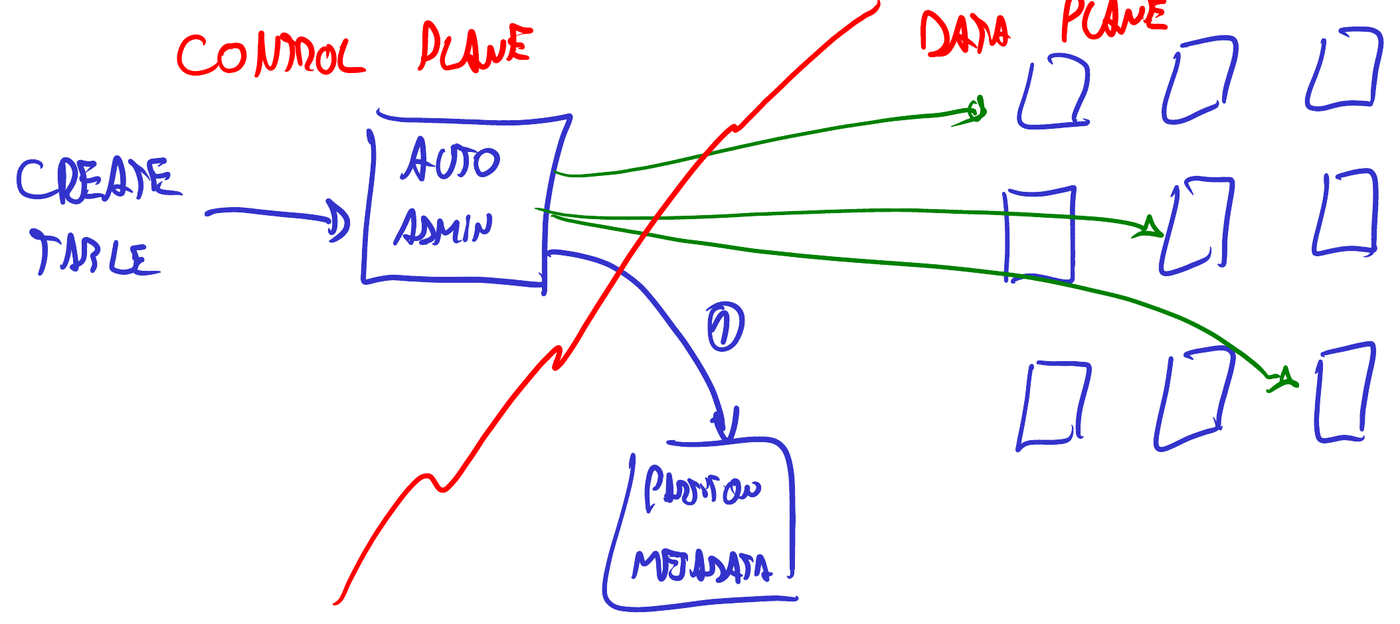
Sobre ese recorrido se traza la división: una curva que parte el dibujo en dos, con el control plane y el auto-admin de un lado, y el data plane con los data nodes del otro. ¿Dónde se ve la ventaja? Si el auto-admin se cae por cualquier razón, el cliente puede seguir usando todo el data plane, que tiene más redundancia, es más potente y es más sincrónico: todos los requests devuelven enseguida. El auto-admin puede permanecer caído un tiempo sin que se note del otro lado. Puede incluso recibir un pedido de tabla, caerse a la mitad, restaurarse y terminarla después. Pero los dos están bien separados.
Tareas del control plane
Queda ver para qué usa DynamoDB el auto-admin, que también resume para qué se usan típicamente los planos de control. Son cuatro cosas.
La primera es el ciclo de vida de las tablas, y descansa en una propiedad general del plano de control: sus pedidos son típicamente asincrónicos. Crear una tabla es una operación relativamente lenta que implica coordinar con muchos lugares. Uno manda el pedido, el sistema confirma que lo va a procesar, la tabla aparece en estado “creando”, y mientras tanto el plano de control ejecuta un workflow que consulta el partition metadata service, contacta los distintos nodos, y así hasta terminar. Es raro que el plano de control haga cosas complejas de forma sincrónica, porque podría quedar bloqueado durante bastante tiempo; por eso usa workflows.
La segunda, igual de importante, es el monitoreo de flota. Flota se suele usar para un clúster, para todas sus máquinas. El auto-admin monitorea activamente todos los storage nodes: el detector de fallas de DynamoDB es parte de él, y cuando detecta una falla reemplaza nodos y los restaura.
La tercera surge de ese mismo monitoreo, pero apunta a otra cosa. El auto-admin también detecta particiones muy hot, calientes: aquellas que reciben un volumen muy alto de accesos. La estrategia básica de DynamoDB es dividir esa partición en dos mitades, con la expectativa de que el tráfico se reparta en partes iguales. A veces no ocurre, y el caso típico es el que vimos con Memcache: las hot keys, que esta estrategia no soluciona. Pero en general, si hay mucho tráfico uniforme hacia una partición, el auto-admin lo detecta y la divide. Para eso tiene que hacer muchas cosas a la vez: registrarlo en el partition metadata service, crear el nodo nuevo, transferirle la mitad de las claves. Todo eso lo gestiona con otro workflow, y eso es el scaling y el rebalanceo.
La cuarta y última —seguramente hace más, pero esta es la última categoría interesante— es que hace y gestiona los backups: se ocupa de que los datos se guarden en otro storage, S3, y monitorea que el backup efectivamente ocurra cada tanto.
Ninguna de estas cuatro cosas es esencial para la operación en tiempo real. Al usuario no le interesa directamente que se ejecuten: le interesa que existan, que el sistema se monitoree y se restaure solo. Por eso van a un sistema aparte del que atiende sus requests.
Y hay un corolario organizacional. Típicamente este sistema lo administra un equipo separado dentro de la organización de DynamoDB: uno opera el control plane, otro el data plane, otro el partition metadata. Es un sistema muy grande, con mucha gente, y separarlo en subsistemas también facilita organizar los equipos.