3. Two-phase commit
En esta sección
Participantes, coordinador y fases del algoritmo
Pasemos al otro gran tema, el más interesante desde el punto de vista de los sistemas distribuidos: la atomicidad, el todo o nada, también cuando hay fallas. Queremos el atomic write que ya nombramos, y la manera de obtenerlo es el famoso two-phase commit. Como también se ve por otro lado, varias cosas van a sonar repetidas; vale la pena recorrerlas de todos modos, relativamente rápido.
El esquema introduce participantes. Los dos sistemas del ejemplo —tickets y asientos— son participantes; los llamamos participante uno y participante dos. Y tiene que haber una entidad nueva, el transaction coordinator, que orquesta a todos los participantes. Puede ser el propio frontend, pero típicamente es un sistema dedicado, porque implementarlo tiene sus complicaciones. Hay variaciones, pero en general el que ejecuta la transacción es el coordinador.
Primero hay una fase en la que el coordinador manda operaciones sueltas a los participantes: un write acá, un read allá. Previamente les avisó que ese write pertenece a una transacción que se inicia, y eso crea un transaction ID. Todos esos mensajes tienen que poder agruparse, así que el TxID viaja con las operaciones: se incluye el TxID en cada RPC. Y para mandar esas operaciones el coordinador ya tuvo que obtener los locks correspondientes en cada participante.
Nada de eso es todavía two-phase commit. Lo que le da nombre al algoritmo es lo que pasa al hacer el commit: se hace en dos fases. Primero el coordinador les envía prepare a todos, y cada uno contesta OK, o no. Le pregunta al primero, que dice OK; al segundo, que también dice OK. Ese es el caso feliz. Con todas las respuestas viene la fase siguiente: le manda el commit al primero, que responde OK, y al segundo, que también responde OK. Ese último OK no es tan crítico como el otro, pero también importa. Esas son las dos fases.
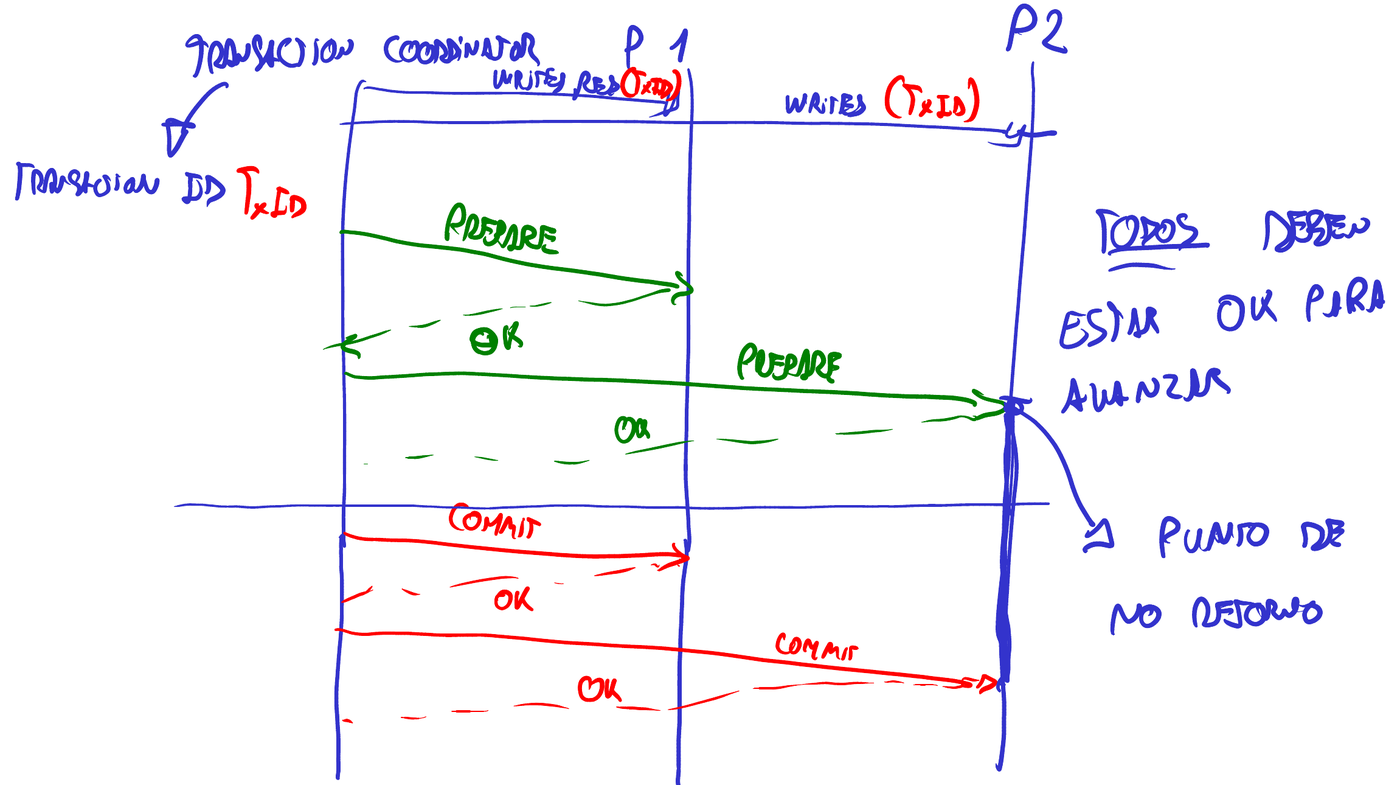
¿Por qué en dos fases? Por lo que pasa cuando algún participante, en lugar de responder OK al prepare, responde que no. La clave del algoritmo es que en la primera fase todos —subrayado— tienen que estar OK para avanzar. Algunos textos dicen que todos tienen que votar positivamente, y la palabra votar puede engañar: si es una votación, es unánime. No hay quórums. Solo cuando el coordinador recibe un OK de absolutamente todas las partes pasa a la fase de commit. Con uno solo que diga que no alcanza para cancelar la transacción para todos.
Punto de no retorno del participante
Eso parece obvio. Lo más importante del algoritmo aparece al mirarlo desde cada host en lugar de desde arriba. Hay un punto en la línea de vida de cada participante que conviene nombrar, porque es la clave de todo: el punto de no retorno.
Antes de responder OK al prepare, el participante puede abortar cuando quiera. Se puede caer; puede haber guardado todo en memoria y romperse; no pasa nada. Puede abortar unilateralmente sin daño. Pero responder al prepare es un compromiso: tiene que poder hacer commit si el coordinador se lo pide. A partir de ahí el coordinador le puede mandar un commit o un abort. Con el abort no pasa nada, descarta todo. Pero si le manda el commit y el participante no puede hacer commit, se bloquea todo el algoritmo: habría que inventar algún mecanismo adicional para desbloquearlo. Todo se apoya en que el participante va a poder hacer commit.
Por eso, típicamente, antes de responder al prepare tiene que guardar en disco. Y si queremos algo más fuerte que el disco —como en un sistema distribuido, según vamos a ver— en ese punto tiene que estar garantizado que el valor está replicado.
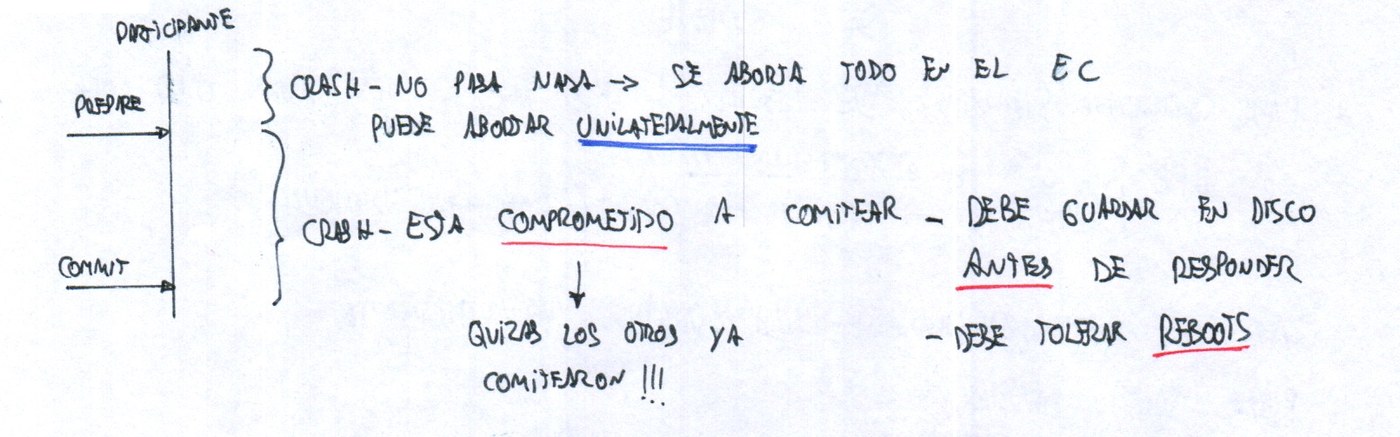
¿Y si después del prepare el participante decide que no puede hacer commit? Es un problema serio, porque ya respondió que sí y el coordinador cuenta con él. Pero el caso más difícil es otro: el participante responde OK y nunca recibe respuesta del coordinador. Ni commit ni abort. Queda en ese período intermedio, sin poder decidir unilateralmente. Puede ser que el coordinador ya le haya mandado un commit a alguien —la transacción ya está parcialmente confirmada— y después se haya roto; o que el mensaje no llegara; o que justo nos particionáramos. Por eso, después del punto de no retorno el participante tiene que quedar bloqueado, y además reteniendo los locks si usa locking pesimista, porque todavía no puede hacer commit. El algoritmo es delicado precisamente por eso: puede bloquear todo el sistema indefinidamente.
Pregunta natural: ¿el participante no podría timeoutear y asumir que el otro se murió? No puede, y eso es lo importante. Ningún participante puede timeoutear solo, porque no sabe si la transacción ya se aplicó en otro lado. El coordinador se rompe y el participante queda esperando. Supongamos que hace timeout, y que timeout significa revertir, descartar la transacción. Puede que el coordinador sí se haya comunicado con alguien, y que ese alguien sí haya hecho commit. Queda la mitad de la transacción confirmada y la otra mitad no, justo lo que no queremos.
En el ejemplo se ve mejor. Si uno decide que pasó mucho tiempo, que el coordinador debe estar muerto, y revierte, puede que el coordinador alcanzara a hablar con el otro antes de morir: queda emitido el ticket y no reservado el asiento. Lo mismo vale al revés: si uno decide hacer commit por su cuenta después de un timeout y el coordinador realmente murió, ese participante es el único que hizo commit: se reservó el asiento pero no se emitió el ticket.
Un matiz: el participante ya hizo flush a disco antes de responder al prepare, pero eso puede haber sido en un lugar temporal; no es que el dato ya está visible para todos. El punto es otro: si el coordinador no le dice si la transacción se abortó o se confirmó, el participante no puede decidir solo. Eventualmente el coordinador podrá mandarle un “actualizate” al reconectarse, pero hasta entonces no hay nada que resolver por su cuenta.
Tolerancia a fallas del coordinador
Llegamos así al punto central: el coordinador tiene que ser altamente tolerante a fallas. El mecanismo se apoya en dos cosas. Una es la que vimos: el participante debe poder hacer commit después del prepare. La otra es peor: el coordinador debe tolerar fallas y, si las hay, poder restaurarse.
Ordenemos primero lo de los participantes. En toda la primera parte, si falla algo en cualquier lado, no pasa nada: el participante todavía no respondió OK. Si falla, revive y no se acuerda de la transacción, cuando le pregunten prepare no va a reconocer la transacción: responde que no, y el coordinador puede revertir todo, porque no hizo commit en ningún lado. De ahí en adelante sí tiene que tolerar fallas: aunque fallen todos los componentes, tiene que poder hacer commit cuando se lo pidan.
¿Y el coordinador? Manda prepares a todos y después commits. Cada respuesta la tiene que ir guardando en disco —o en un sistema distribuido tolerante a fallas—, de manera que si muere y levantamos otro, ese otro pueda leer el estado. Típicamente es un log: le mandé prepare a tal, me respondió prepare OK, y así toda la secuencia. El que lo reemplace tiene que poder heredar ese estado; si no, el sistema queda bloqueado con los locks tomados.
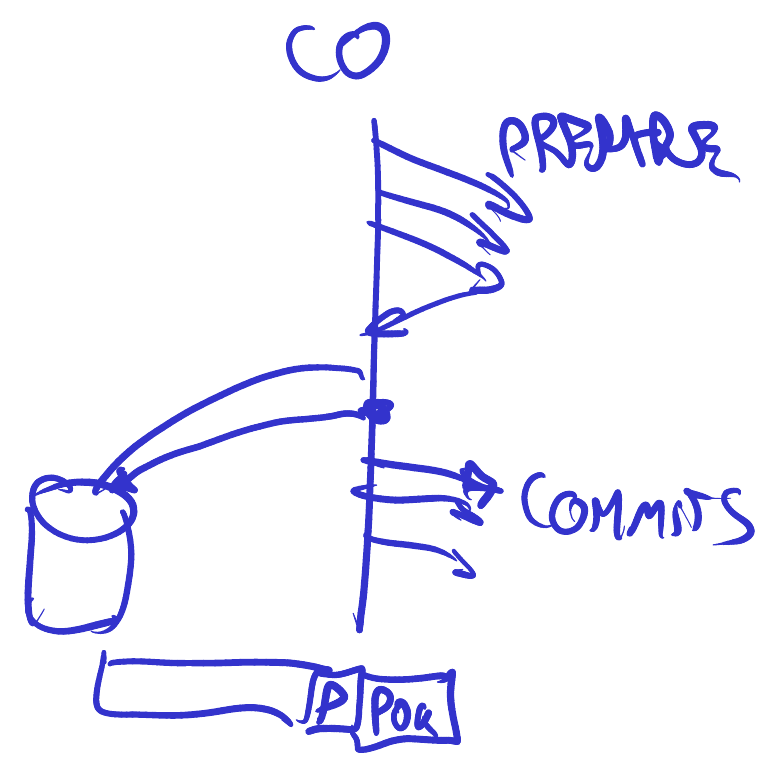
Hay un momento especialmente crítico: antes de mandar el primer commit, todo el estado tiene que estar persistido. Así, si revivimos el coordinador, sabemos que todos respondieron prepare, que empezamos a mandar commits y que hay que mandárselo a todos. Mandar commits repetidos no es tan terrible: quien ya hizo commit puede indicar que ese commit ya lo recibió y no hacer nada. Lo importante es que cuando empieza la fase de commit, sea commit para todos. Ante una duda podemos mandar aborts, pero si le mandamos abort a alguien se lo tenemos que mandar a todos, sin mezclarlo con ningún commit.
Quizás quede más claro al ver cómo lo implementa DynamoDB, pero el coordinador tiene que ser tolerante a fallas. Si no lo es y pierde el estado —si lo tenía en memoria y se pierde al caer—, es un problema grave: queda todo el sistema bloqueado y hay que reparar la transacción manualmente, con algún criterio.