7. Chain replication
En esta sección
Hay otra forma de replicación que surge de modificar el primary-backup hasta obtener algo distinto. Se llama chain replication, y no es tan común: no se habla mucho de ella y no hay demasiados proyectos que la utilicen. Pero la idea es elegante.
Estructura de la cadena
Pensémosla con tres nodos replicados conectados uno detrás del otro, formando una fila. Al primero lo vamos a llamar el head y al último el tail, y los datos se replican siguiendo esa fila, eslabón por eslabón. Se parece a una lista enlazada, con la diferencia de que los eslabones no son celdas de memoria sino máquinas.
Hay una forma de pensarlo que lo conecta con lo anterior: el head junto con el nodo del medio es un primary-backup en miniatura, y el del medio junto con el tail, otro encadenado detrás. Aunque quizás sea más simple pensarlo como lo que su nombre indica: una cadena.
La particularidad importante es cómo se producen las escrituras y las lecturas. Para escribir, el cliente siempre le envía la escritura al head. El head se la replica al del medio, y el del medio al siguiente. Puede haber más nodos intermedios, eso no modifica el esquema. Y el que finalmente le responde al cliente no es el head: es el tail.
Hay algo aquí que resulta llamativo: el request se le envía a un nodo y el response lo devuelve otro. Es una situación poco habitual en sistemas distribuidos: si quisiéramos implementar esto con RPCs, en el sentido en que los venimos usando en el trabajo práctico, un remote procedure call común no va a funcionar.
¿Cómo se resuelve? Los detalles finos los dejamos fuera del alcance, porque cada implementación determinará cómo hacerlo. Pero típicamente el cliente mantiene dos conexiones abiertas, una con el head y otra con el tail, y asumamos que ninguno falla. Con esa doble conexión la biblioteca que usamos envía las escrituras al head y recibe los acknowledge del tail. Solo cuando recibe ese ack la escritura está confirmada.
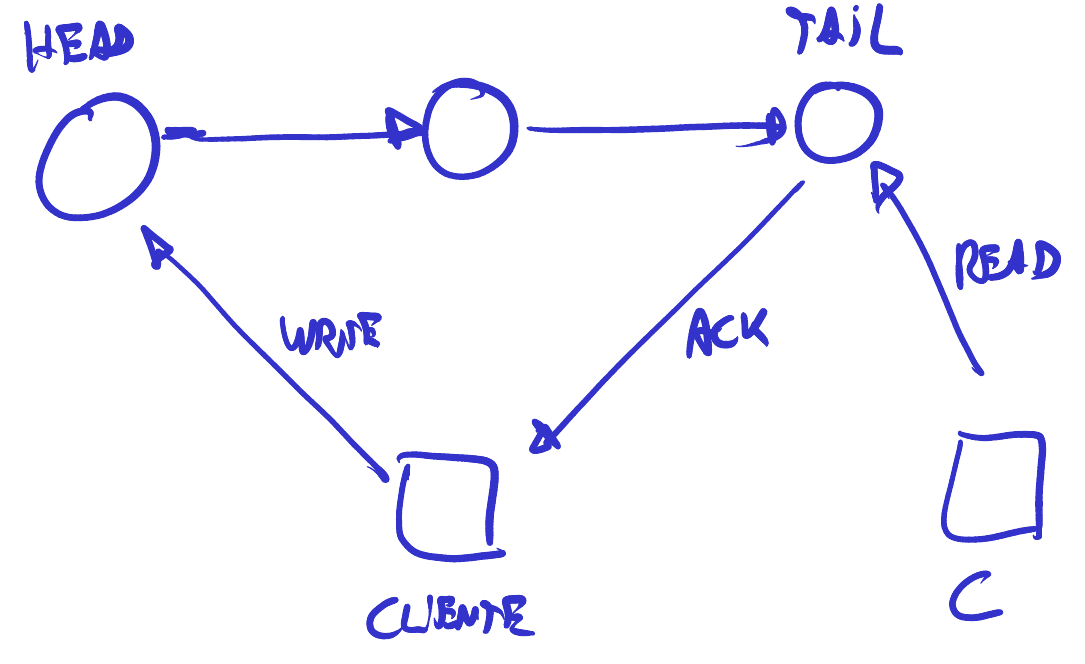
¿Qué beneficio tiene? Uno es evidente por comparación con el esquema anterior: en el primary-backup el primary tenía que enviarles los datos a todos los backups, con lo cual cada escritura salía tres veces por la misma placa de red, que podía saturarse. Aquí el head recibe una escritura, la aplica localmente y se la envía a un solo nodo. Cada eslabón emite una sola copia, así que el costo de red por máquina no crece con el largo de la cadena.
El otro beneficio no es sorprendente, pero es de gran importancia: este sistema es fuertemente consistente. Para que lo sea, es decir para que sea linealizable, el requisito es leer siempre del tail.
La razón está en el acknowledge: la escritura está confirmada y asegurada solo cuando ese ack llega. Si el sistema, visto como una caja, le responde acknowledge a un cliente y es fuertemente consistente, cualquier lectura posterior tiene que ver lo que ese cliente escribió. De ahí la regla: si aparece otro cliente que solo quiere leer, tiene que leer de la cola, al menos en la versión básica de este esquema.
¿Y si lee de un nodo del medio? Puede leer algo que todavía no está confirmado, que eventualmente va a terminar de propagarse o que quizás no llegue nunca. El caso que lo ilustra: el cliente le envía la lectura al head, el head le responde un valor, pero falla inmediatamente después y no llega a enviárselo al siguiente eslabón. Ese dato lo vio solamente ese cliente y nunca nadie más lo va a ver. De hecho, el que había enviado la escritura original va a recibir un error, porque nunca va a recibir el acknowledge, y probablemente realice un retry; y sin embargo el segundo cliente leyó un dato que no tiene respaldo en ninguna parte.
Eso no puede ocurrir leyendo de la cola: si el dato ya pasó por el head y por todos los intermedios, está replicado en todos los nodos, confirmado, commiteado. Leyendo de la cola, el cliente siempre obtiene la versión más actualizada. Y eso no ocurría en los sistemas anteriores: en el primary-backup no había coordinación entre el primary y los backups, y si fallaba el primary se comprometía todo el esquema. En ese sentido, esto es bastante más tolerante a fallas.
Todo esto se puede relajar. Si uno está dispuesto a tolerar esos errores, hay optimizaciones que permiten leer de cualquier nodo; el precio es que el cliente tiene que asumir que puede obtener información desactualizada. Lo que la cola garantiza, y los nodos del medio no, es que el dato ya está en todos los nodos.
Nada de esto es un ejercicio teórico: varias empresas lo usan internamente, en particular para implementar sistemas de logs, que tienen que respetar el orden. La virtud del esquema es esa combinación poco frecuente: es inusual, pero es muy fácil de comprender.
Manejo de fallas
Las fallas de este esquema son varias y todas tienen su interés. Para analizarlas de a una hace falta una suposición provisoria: que hay alguien externo a la cadena que detecta la falla y reconfigura el sistema. Cómo se detectan es un problema en sí mismo y lo vamos a analizar enseguida.
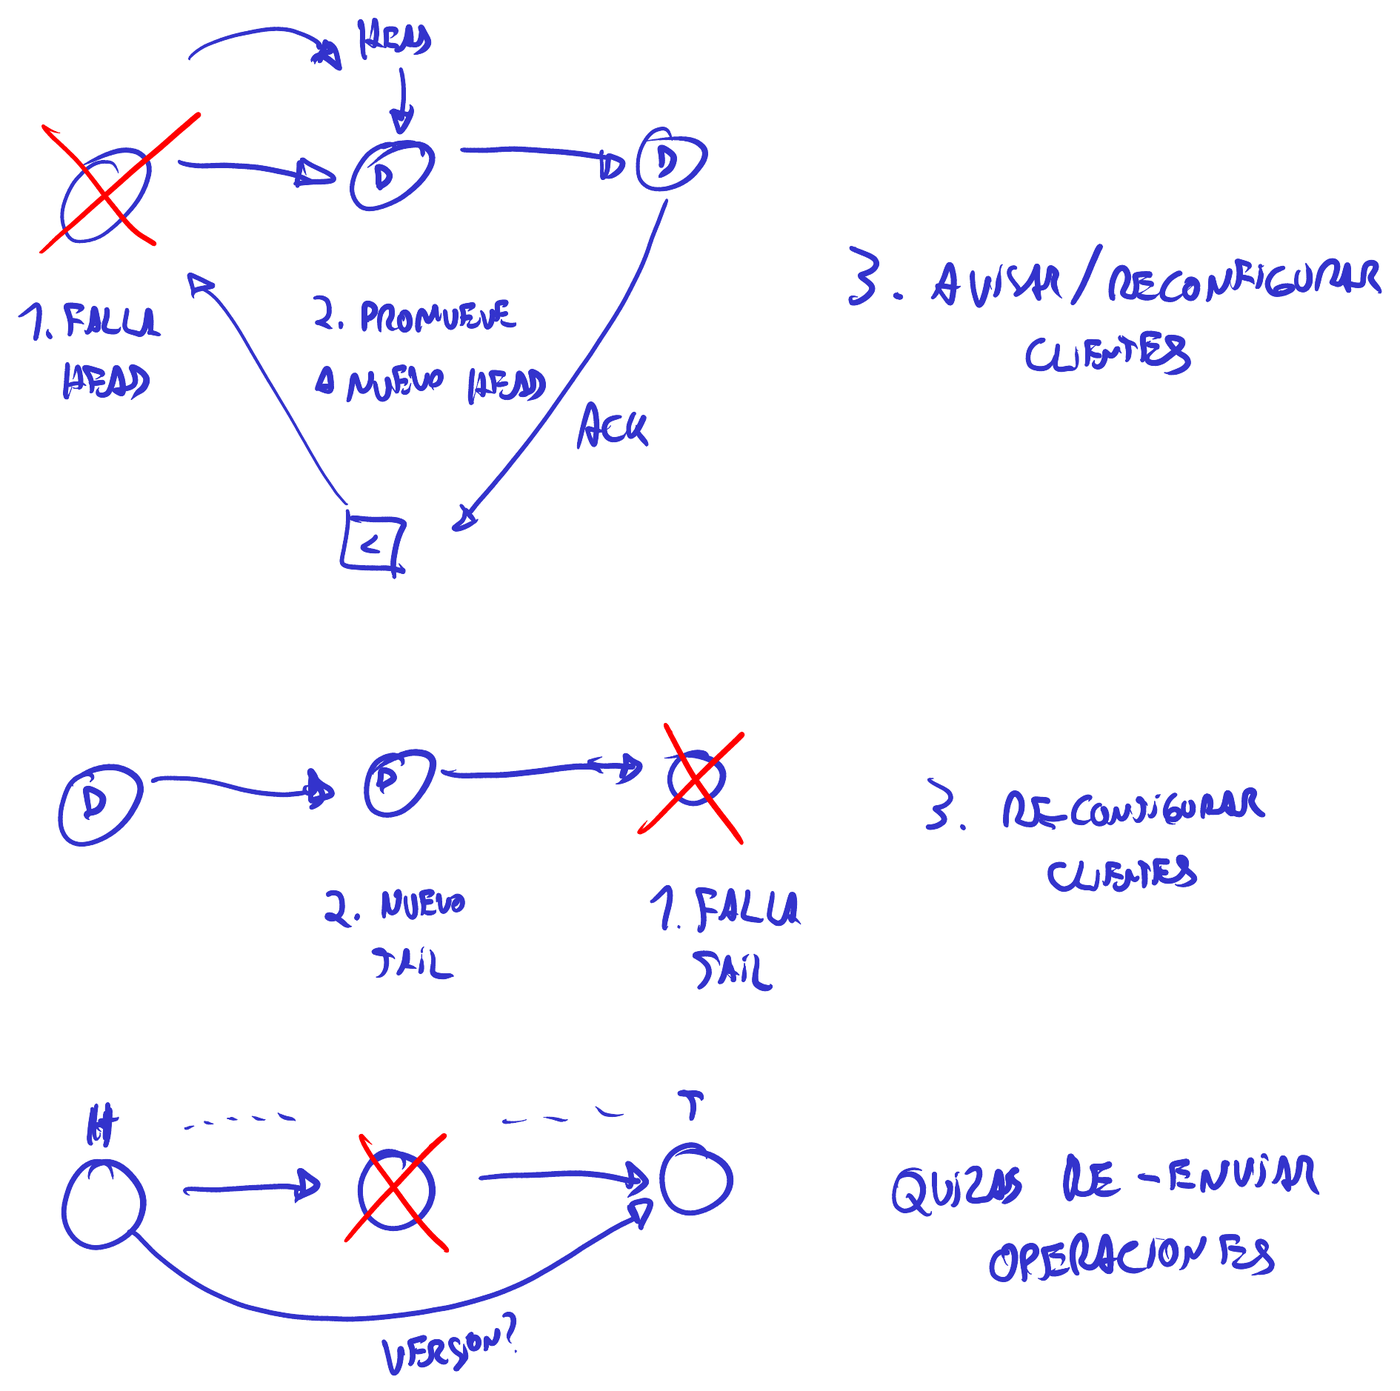
El primer caso es que falle el head. La resolución es la previsible: se toma el nodo que le seguía y se lo promueve a nuevo head. Después hay un paso más, que no es opcional: avisarles a los clientes y reconfigurarlos, porque cada uno tenía una conexión abierta con el head anterior y ahora la tiene que abrir contra otra máquina.
Lo interesante es preguntarse si en ese salto no se perdió información. No se perdió, y vale la pena recorrer los escenarios. Uno es el que ya usamos: el cliente le envió un dato al head y el head falló antes de replicárselo al que le sigue. No es realmente un problema, porque si falló antes de replicar el cliente nunca pudo haber recibido el acknowledge: va a asumir que su escritura fue un fail-stop y va a reintentar.
El otro escenario es que el head lo haya escrito localmente y además haya logrado replicárselo al segundo nodo. Ahí el segundo se lo va a enviar al tercero y el tercero va a responder. A pesar de que falló el primero, nada quedó inconsistente: el dato terminó replicado en los otros dos, el head ahora es el segundo nodo, el tail sigue siendo el mismo y el cliente se entera de quién es el nuevo head. Es elegante: no se inventa ni se pierde ninguna información.
De todo esto surge una garantía general que conviene retener: si el cliente recibe el acknowledge, el dato está replicado en varios lugares —salvo el caso extremo de que sean solo dos nodos y uno falle—, lo que quiere decir que por lo menos alguien lo tiene guardado en el disco.
El segundo caso es el inverso: falla el tail. La salida es tan intuitiva que casi no hace falta enunciarla: el nodo del medio pasa a ser el nuevo tail. Y de nuevo hay un tercer paso, reconfigurar a los clientes.
Aquí pueden ocurrir problemas parecidos. Si el sistema nos respondió antes de que el tail fallara, tenemos la garantía de que el dato está replicado en los otros dos nodos. El caso menos favorable es el otro: si el dato está en los dos primeros y después falla el tail, podemos llegar a tener un duplicado y hay que eliminarlo. Si el cliente nunca recibió el ack va a reintentar, y a lo sumo se duplica un dato; pero no perdimos información.
El tercer caso es que falle un nodo del medio. Con tres nodos el reparto es forzado, pero lo mismo podría ocurrir en cualquier posición interna de una cadena más larga. Lo evidente es sortearlo: se reconfigura la cadena para omitirlo.
Pero hay una precaución adicional. Todas las operaciones que el head le fue enviando tienen que haber llegado al tail, y eso no está garantizado. Así que antes de esa reconfiguración —o inmediatamente después— el head le tiene que consultar al tail por su versión, para saber hasta dónde recibió, y si le faltan operaciones se las tiene que reenviar. Eso es más complejo de lo que parece, porque el head no puede enviar la operación y desentenderse: tiene que guardar algunas por si se las tiene que reenviar a otro nodo, es decir, tiene que mantener una pequeña memoria de log. Si hay algún caso difícil, es este.
El flujo de información, en realidad, es más rico de lo que veníamos suponiendo: los nodos se pueden comunicar constantemente entre sí y verificar el avance de cada uno. Una variación que se usa en la práctica hace eso: la escritura baja del head al del medio y del del medio al tail, y el tail responde dos veces, una al cliente y otra al head, informándole que la operación llegó al final. Ese aviso se propaga y permite realizar cierta limpieza.
Incorporación de nodos
Queda un caso que no analizamos: cómo se agrega un nodo. Si tenemos dos o tres nodos formando la cadena y queremos sumarle uno más, la forma más simple es agregarlo al final, detrás del tail actual, de manera que la cadena crezca por el extremo y el nodo nuevo sea la nueva cola.
El asunto es que un nodo recién incorporado no tiene nada y se tiene que poner al día. Una estrategia razonable es enviarle primero un snapshot —una imagen con todo el estado tal como está en un momento dado— y después el log, es decir las operaciones que ocurrieron desde ese momento. Se le sigue enviando log hasta alcanzar la misma versión —digamos la 10— que el nodo que lo precede, y solo entonces se reconfigura el sistema para que empiece a responderle los acks al cliente. Antes no, porque no tendría con qué respaldar esa confirmación.
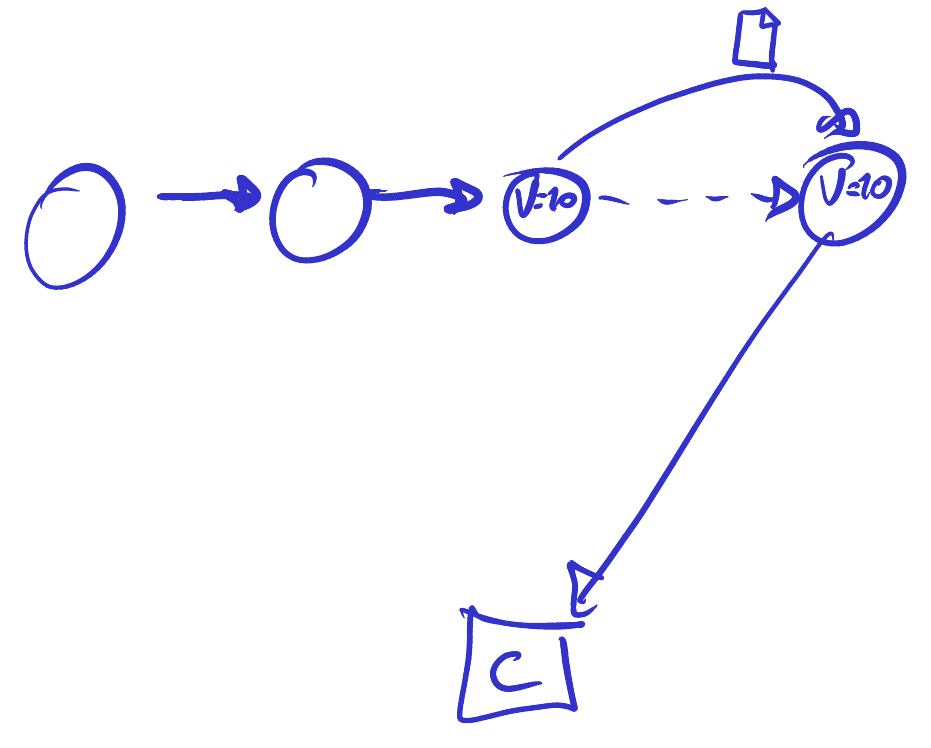
Analizado en detalle, sin embargo, esto es mucho más complejo. Enunciado en una línea parece sencillo: se le envían los archivos, después el log, después se reconfigura. Pero estas son las sutilezas difíciles de los sistemas distribuidos: hay que coordinarlo todo para que en el proceso no se pierda ni se duplique ningún dato.
Este caso importa tanto como los tres anteriores, y la razón está en ellos: en cada uno falló un nodo y quedamos con uno menos, de tres pasamos a dos, a un solo nodo de distancia de no tener más tolerancia a fallas. Así que después de cada falla hay que agregar uno, y la manera típica es exactamente esta.
Y sin embargo hay algo que hasta aquí supusimos inexistente, y que no es en absoluto menor. Porque leído así, todo el algoritmo parece excelente: parecería que resolvimos la replicación de una forma tan limpia que todo lo anterior habría sido innecesario. No es el caso. El problema aquí es detectar las fallas.