1. Motivación de los algoritmos de consenso
En esta sección
Lo que viene continúa la línea de las clases anteriores: los sistemas de storage, las bases de datos, los file systems distribuidos. Raft es un algoritmo de consenso y vamos a dedicarle dos clases; hubo varios, pero este es el que vamos a estudiar en detalle.
El nombre engaña un poco. Más allá de que varias máquinas se pongan de acuerdo en un valor, lo que queremos resolver es el problema de la distributed state machine, o state machine replication: que varias máquinas reciban las operaciones en el mismo orden y que el estado quede consistente en todas. Los sistemas reales a veces implementaron Raft directamente y a veces variaciones: Zookeeper usa un protocolo propio y anterior que resuelve el mismo problema de manera muy parecida; DynamoDB internamente también usa un algoritmo de esta familia.
Escrituras parciales en Google File System
El punto de partida es una pregunta que quedó pendiente de la clase pasada, con el Google File System. La idea de Google era muy buena —les sirvió para hacer grande la empresa—, pero el sistema tenía problemas de consistencia serios, y son esos problemas los que justifican la clase de hoy.
Un chunk vive replicado en tres chunkservers. El cliente le envía un registro al sistema; ese registro se escribe primero en el primary, y el primary después trata de escribirlo en los dos peers que tienen las otras copias. A uno se lo envía y llega. Cuando intenta enviárselo al otro, puede fallar la conexión, no llegar nunca la respuesta, reintentar todo lo que quiera y que la respuesta siga sin llegar. ¿Qué hace el Google File System? Le informa al cliente que la operación falló y delega en él la recuperación.
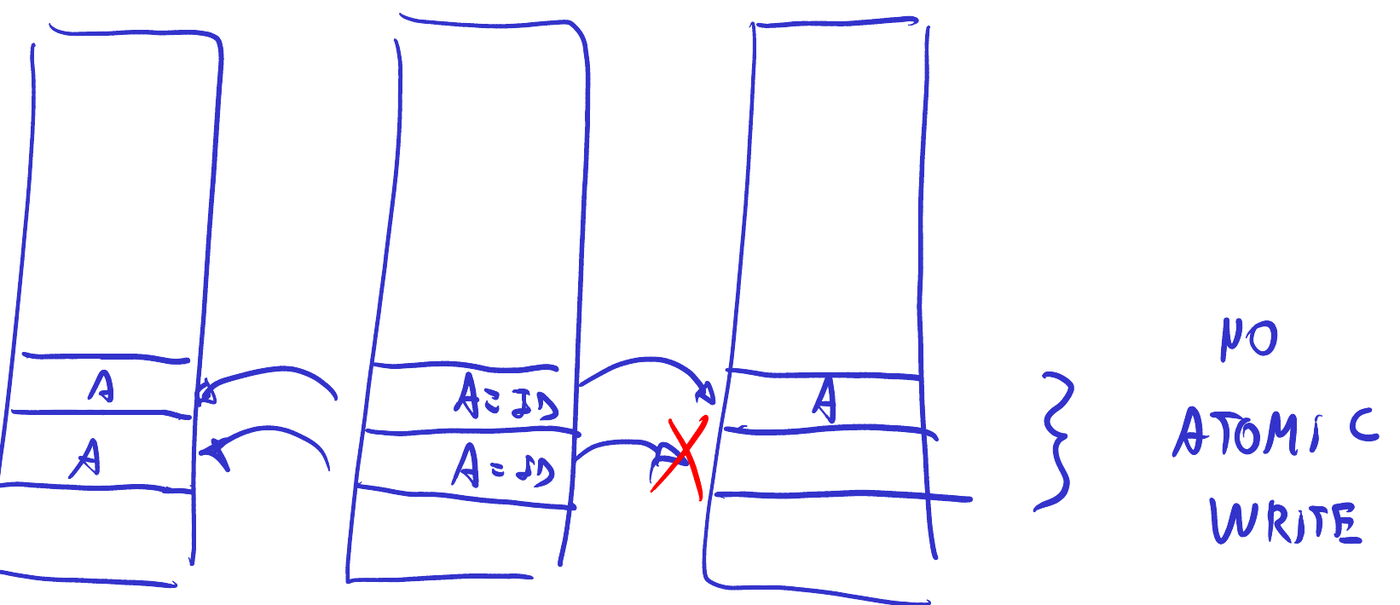
Lo que se supone que tiene que hacer el cliente es un retry. Y aquí aparece la primera sutileza: el retry no hace ninguna magia para quitar los duplicados. El Google File System no compara el registro que llega contra los que ya tiene escritos ni lleva memoria de qué pedidos atendió antes: aplica la operación otra vez, y si el segundo servidor ahora responde, la escritura se completa. Eso nos deja dos problemas.
El primero es que nos quedan tres réplicas que no son tan réplicas. En una de las máquinas hay una zona del chunk donde no hay ningún registro: puede estar vacía, puede contener restos de datos, pero difiere de las demás. Con eso se cae la garantía ideal, la de leer en cualquier lugar y obtener la misma información: si las cosas fallan, los tres chunks pueden quedar inconsistentes de forma permanente.
La palabra que conviene subrayar es permanente. No es consistencia eventual ni ninguna de esas nociones modernas: es inconsistencia, sin más. Esa porción que quedó con el padding conserva un hueco de forma permanente. Y detectar que eso es un hueco y no información real recae sobre los clientes que consumen el archivo: usaban checksums, o lo advertían al no poder leer el registro en el formato correcto. Nuevamente, el sistema traslada la responsabilidad al cliente.
El segundo problema es lo que pasó en las otras dos réplicas: al haber reintentado, el registro quedó escrito dos veces. Y la solución también es problema del cliente, que tiene que tener algún mecanismo de IDs únicos para que quien consume el archivo no lo cuente dos veces, sino que reconozca que ya lo vio.
La reacción natural es preguntarse si nadie desarrolló algo para que esto no vuelva a ocurrir. Y en efecto: hay formas más modernas de resolverlo, y la tolerancia a este tipo de problema hoy es mucho más baja. Quien contrata DynamoDB no recibe de Amazon la advertencia de que a veces el sistema es inconsistente. DynamoDB garantiza que eso no ocurra.
La garantía es que no queden réplicas permanentemente inconsistentes. DynamoDB sirve lecturas eventualmente consistentes por defecto; la consistencia fuerte en las lecturas se pide explícitamente con
ConsistentRead.
El nombre que le habíamos puesto a este problema era atomic write, atómico en el sentido distribuido: el write ocurre en todas las máquinas o en ninguna. Lo que queremos evitar es que quede escrito en una y en la otra no, y que a pesar de eso las cosas sigan adelante. El Google File System es un sistema sin atomic write; con Raft ese problema no se produce, y vamos a ver que resolverlo es sumamente trabajoso. Concretamente, Raft nos va a permitir writes atómicos al nivel de cada operación individual.
Un par de clases más adelante va a aparecer otra técnica, para cuando queramos modificar varios registros a la vez como si fuera una transacción de base de datos. Ahí estaremos en el terreno de la transacción distribuida, con el two-phase commit y otro conjunto de complicaciones. Por ahora el ladrillo con el que vamos a construir todo lo demás es este: atomicidad de una operación por vez.
Hay una segunda propiedad que el Google File System tampoco provee: la consistencia fuerte. Ahí, según dónde leamos, puede que veamos una escritura y puede que no. Lo ideal sería que si le enviamos una operación y nos responde afirmativamente, la siguiente operación —la nuestra o la de cualquier otro cliente— vea lo que escribimos. Raft tiene consistencia fuerte.
“Consistencia fuerte” es un nombre algo ambiguo. El más académico, el que vamos a usar, es linealizabilidad: escribimos algo, el sistema nos responde, y al leer obtenemos lo mismo que escribimos. Su definición precisa es tema de la clase que viene.
Existe una versión relajada que Raft inicialmente no provee, la consistencia débil o eventual: escribimos, el sistema responde que está bien, leemos nuevamente y nos devuelve un valor desactualizado, aunque eventualmente se actualice. Raft se puede modificar para eso, pero el paper intenta la versión fuerte, la que garantiza que si nos dio OK, después va a responder lo que corresponde.
Punto único de falla y split brain
Hay un segundo problema que estos algoritmos vienen a resolver, y estaba en los dos ejemplos anteriores por igual: el famoso punto central de falla, el single point of failure. Los papers de MapReduce y del Google File System llaman master a ese nodo; coordinador es el nombre que le pusieron los labs del MIT, que usamos para los trabajos prácticos, y por eso los dos términos se emplean indistintamente. Nombran lo mismo. La estructura era la misma en ambos sistemas: un nodo privilegiado y muchos nodos subordinados —chunkservers en uno, workers en el otro— que recurrían a él para consultar el estado del sistema.
El problema es directo: ese nodo era una máquina, y si moría, moría todo el sistema. ¿Cómo se evita? Que en vez de ser uno sean varios. Se soluciona con replicación.
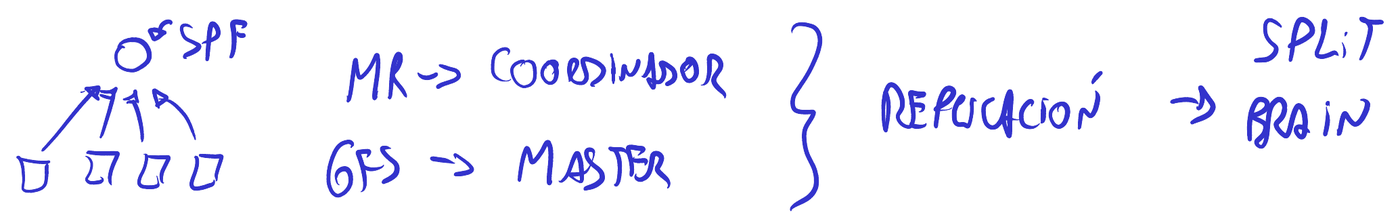
Solo que aquí tenemos un problema del huevo y la gallina. Ese nodo era único justamente para simplificar el problema, para tener un lugar donde el estado fuera uno solo y no hubiera que ponerse de acuerdo con nadie. Si lo replicamos sin cuidado, aparece la otra situación que teníamos que evitar: el split brain.
El split brain es lo que ocurre cuando, en un sistema distribuido con replicación, los nodos se descoordinan y el sistema empieza a comportarse como si fuera dos sistemas. El estado avanza por los dos lados y diverge, y después no hay forma automática de unificarlo —y quizás tampoco haya forma razonable—. Pensemos en un sistema financiero donde la cuenta de alguien tiene un valor en un lugar y otro distinto en otro. Ya no hay forma técnica de determinar cuál es el saldo correcto. Eso es mucho más indeseable que perder disponibilidad, y por eso el objetivo de todo lo que sigue es evitarlo a toda costa: es una situación irreconciliable.
El ejemplo merece verse de nuevo. Sobre un diagrama de tiempo, un cliente envía un pedido de escritura del valor 15. La nomenclatura —la misma del MIT— es Wx15: un write del valor 15 en la variable x. Después ese cliente intenta escribir lo mismo en la otra réplica. Las réplicas son dos, S1 y S2, y supongamos que con ellas estamos tratando de resolver ingenuamente el problema del nodo central: implementar una máquina de estados replicada, pero de forma manual.
Le escribimos el 15 a uno y también al otro. Si el otro responde afirmativamente, la operación se completa. El problema es cuando no responde. Y como vimos en la primera clase, el caso feliz —irónicamente— es que ese servidor haya muerto: se quemó el disco, se cortó la energía del rack. Ahí a lo sumo perdimos alta disponibilidad: seguimos operando con un servidor.
Pero una no respuesta puede ser otra cosa: que la red se haya particionado. No falló el servidor, sino un router, un switch, cualquier componente de red en el medio. ¿Qué implica? Que quizás nos quedaron algunos clientes de un lado de la red y otros del otro —pensemos en dos data centers—. Del otro lado quedó el cliente dos, que quiere escribir un valor distinto, digamos 20, y que también está intentando enviarle su escritura al otro servidor, y a él también le falla.
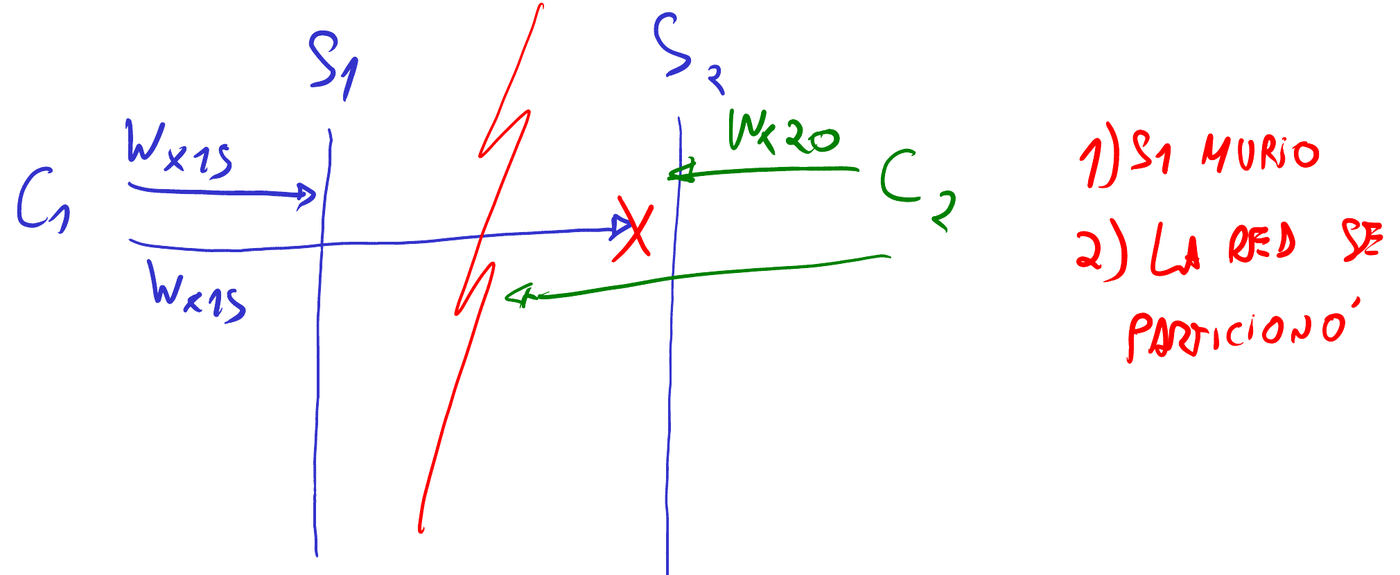
Si el servidor dos acepta esa escritura, ahí divergieron: ahí se produjo el split brain. La mitad izquierda piensa que x vale 15 y la derecha que vale 20. Y no tenemos manera de resolverlo: ¿quién tiene razón, C1 o C2?
Este es el lugar exacto donde encaja el famoso teorema CAP, que en el fondo es simple. Una vez particionada la red hay que elegir una de las dos mitades, y la que no elegimos tiene dos destinos posibles: o devuelve información desactualizada, que es ser inconsistente, o directamente no responde más, que es no estar disponible. Y hay algo que la mitad descartada no va a poder hacer en ningún caso: aceptar escrituras. Esa imposibilidad no la impone el teorema: sale de haber elegido preservar la consistencia, que es la rama por la que va a ir Raft. Un sistema que privilegiara la disponibilidad podría dejar que las dos mitades siguieran aceptando escrituras y reconciliarlas después —y eso es precisamente la divergencia que queremos evitar—.
Hay varias maneras de evitar el split brain, y todas tropiezan primero con un problema adicional: S2 no se puede comunicar con S1 para preguntarle si está vivo, por exactamente la misma razón por la que el cliente no pudo escribirle. A lo sumo se da cuenta de que S1 no está disponible, y S1 ve exactamente lo mismo de S2: una ceguera simétrica. Entonces el problema que vamos a resolver hoy, el que se llama elección de líder, es este: cómo hacen esas dos mitades para decidir, cada una unilateralmente y sin poder hablar con la otra, cuál va a seguir recibiendo las escrituras y cuál va a dejar de responder o va a responder información vieja.
Modelo de fallas
Estos algoritmos no toleran cualquier falla. Las que nos interesan son las dos situaciones indistinguibles que acabamos de mirar: la máquina que se murió y la red que se cortó. Se las llama fallas fail-stop. No sabemos cuál ocurrió —no tenemos manera de saberlo—, pero sabemos que el nodo dejó de responder, y con eso tenemos que trabajar. La pregunta, entonces, es cómo tolerar fallas fail-stop. Es una sutileza, y es de la mayor importancia.
Las otras fallas que pueden existir son las bizantinas, nombre sofisticado para algo concreto: una máquina comprometida por un atacante, que responde valores arbitrarios; aunque en el caso común es una máquina que implementamos mal nosotros, con un bug que le hace responder incorrectamente.
Raft asume que quien lo programa lo programa bien, que la máquina responde lo que tiene que responder. Si una máquina no sigue el protocolo correctamente, se rompe todo.
Por eso mismo esto no funciona para sistemas de consenso distribuido donde las partes no se confían entre sí. El ejemplo es Bitcoin, que vamos a ver más adelante: ahí Raft no sirve. Si no tenemos control de las máquinas, no podemos implementar esto.