5. Log
Log como abstracción fundamental
Justamente ahí aparece una abstracción importante, la que introduce un artículo de la bibliografía. No es un paper sino un artículo, de lectura opcional, pero esclarecedor y muy bien escrito, porque introduce la relación fundamental que buscamos: el log. Y el log importa por una razón directa: si damos con la forma de definir un log de operaciones, resolvimos el problema planteado.
Un log es una estructura —concreta o puramente conceptual— que contiene operaciones. La palabra está muy cargada, así que aclaremos de qué no estamos hablando: no es el log que un programa emite a un archivo de texto para depurar. Este es mucho más parecido al de una base de datos, y ese va a ser el primer ejemplo concreto.
Todas las operaciones que los clientes van enviando se agregan a este log, y siempre se agregan al final: suele ser una estructura append-only. Prácticamente nunca hay forma de insertar en el medio, porque ahí se rompen sus garantías. Y al agregar al final, el log está definiendo el orden de lo que contiene.
Por eso el log, como abstracción, relaciona dos elementos: no son simplemente operaciones ni son solamente datos, sino las operaciones y un orden. Y ese orden además es total: no hay jerarquías parciales, sino que se sabe con certeza que esta operación ocurrió antes que esta otra, y eso para todo par de operaciones. En algunos casos se relaja un poco, pero por ahora no importa.
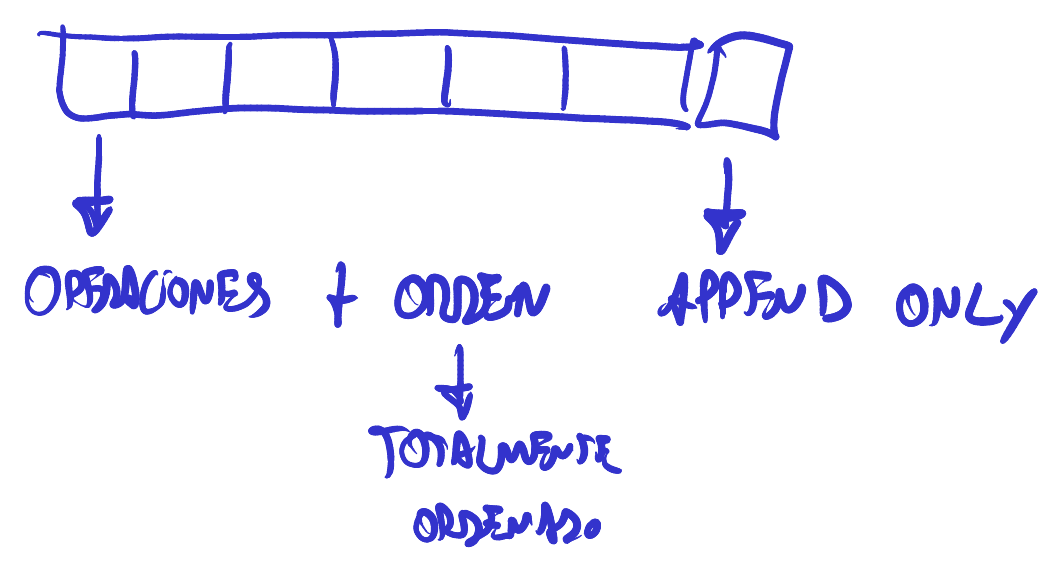
Lo que esto nos resuelve es en qué orden ocurrieron los updates. Y si conseguimos armar un log, resolvimos la replicación: se lo aplicamos a la máquina de estados replicada y con eso alcanza.
Lo que estamos haciendo es destilar el problema esencial de la replicación, y por ahora llegamos a que si conseguimos —quizás no físicamente, pero sí conceptualmente— un log de operaciones, prácticamente está resuelto. Todavía es abstracto, así que vale la pena un par de ejemplos.
Log de una base de datos
Aparece, para empezar, en la base de datos. Tomemos una base relacional: tenemos ahí un log en versión no distribuida, pero muy parecido en esencia a lo que vamos a terminar viendo.
Supongamos que hablamos de Postgres. Tiene muchas estructuras internas, pero dos son las principales. La primera son las páginas, donde se guardan las tablas en sí: todos los rows terminan en páginas, y esas páginas suelen organizarse en alguna estructura como un árbol B. Las que son hojas suelen estar conectadas entre sí, con lo cual termina formándose un árbol B+.
Esto debería resultarnos familiar, porque en Bases de Datos vimos que los índices eran árboles. Y no solo los índices: las tablas también se implementan con árboles B+. Hay otras formas, pero predominan los B+ por esas hojas enlazadas: permiten recorrer un rango entero de corrido, sin volver a subir por el árbol en cada salto.
Además de las páginas había otra estructura, muy importante: la que resolvía el tema de las transacciones, esas operaciones de todo o nada. Permitía, por un lado, que si una transacción no terminó se la pudiera revertir, y por el otro, que si la base se interrumpía a mitad de camino se pudiera restaurar el estado. Esa estructura era el log.
El log de una base de datos tiene varios nombres, y van cambiando con el tiempo. La versión moderna es write-ahead log, WAL. Antes, en la época de Oracle, también se lo llamaba redo log, un nombre que ya casi no se utiliza.
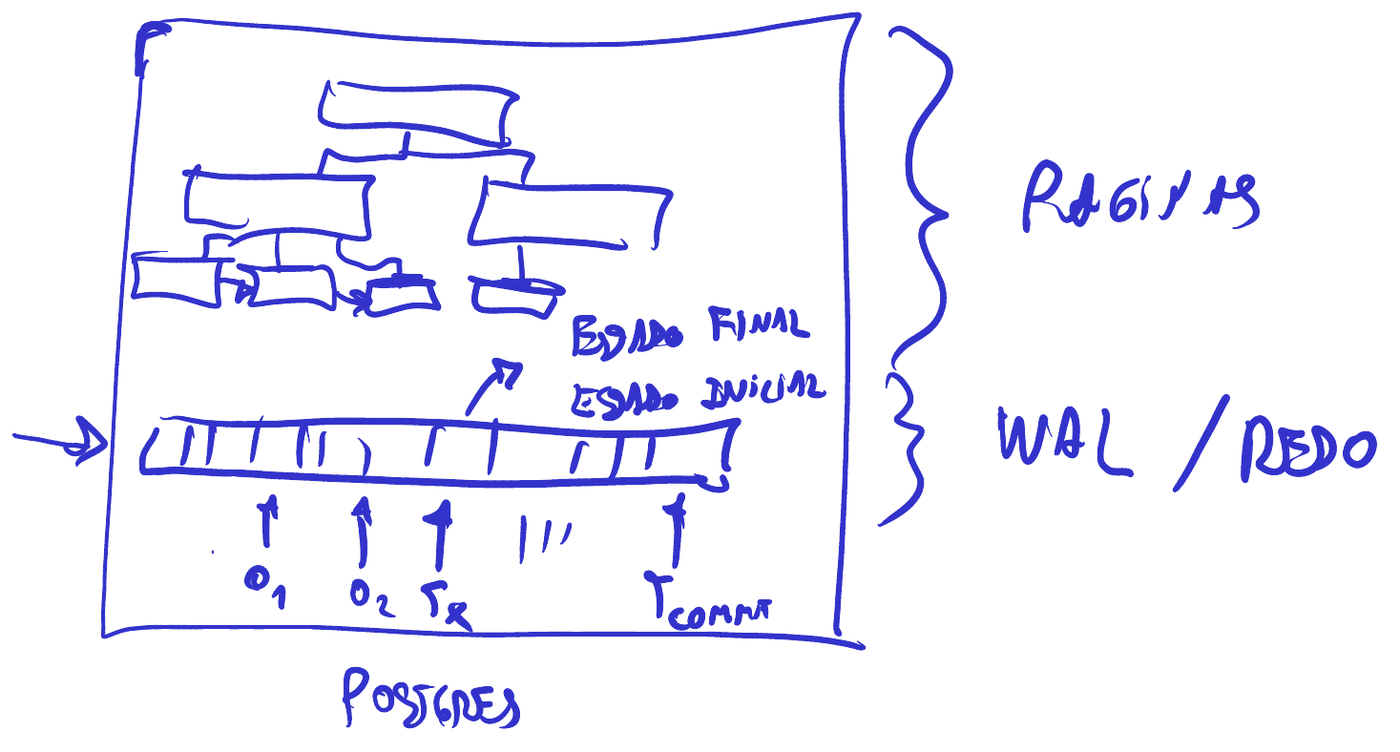
El mecanismo del WAL era el siguiente. Ahí se van registrando todas las operaciones, y además hay que registrar cuándo se inicia una transacción, que es una operación que hace muchos cambios a la vez: se marca el inicio, después vienen operación, operación, operación, y al final el commit.
La gran utilidad era esta: cuando la base se interrumpía y quedaba a mitad de camino —cuando no se llegó a escribir el commit—, al iniciarse nuevamente había un proceso que, antes de recibir requests, verificaba cuáles transacciones habían iniciado y cuáles no habían terminado.
Y cada entrada del log contenía también el estado inicial y el final que pretendía dejar en la página correspondiente. Si había que revertir, se leía el log en sentido inverso y se le asignaba el estado inicial a todas las páginas, y queda como si nunca se hubiera ejecutado la transacción. Lo mismo ocurre con un rollback explícito.
Este log no es distribuido: es una máquina física que está toda junta ahí, con las páginas y el log en su interior. Pero es un ejemplo paradigmático de para qué se usa un log en la práctica, y conviene recordarlo, porque cuando lleguemos a Amazon Aurora vamos a ver que hace cosas muy interesantes con él.
Log en Raft y versionado
El segundo ejemplo es Raft, donde uno termina familiarizándose mucho con un log. Todavía no lo conocemos, pero su esencia se puede adelantar: es básicamente un algoritmo de consenso, pero también resuelve replicación, y las aplicaciones que lo usan tienen dos capas bien diferenciadas.
Arriba está nuestra aplicación —llamémosla app—, que seguramente tenga un storage, y ese storage es lo que queremos replicar. Abajo está la capa de Raft, que contiene un log muy parecido al de la base de datos: no tiene transacciones, pero ahí se van guardando las operaciones.
Todo eso junto constituye una máquina física. Al lado hay otra, con otra instancia de nuestra aplicación y su storage, y otra instancia de Raft. No suelen ser procesos diferentes: suelen ser parte del mismo proceso.
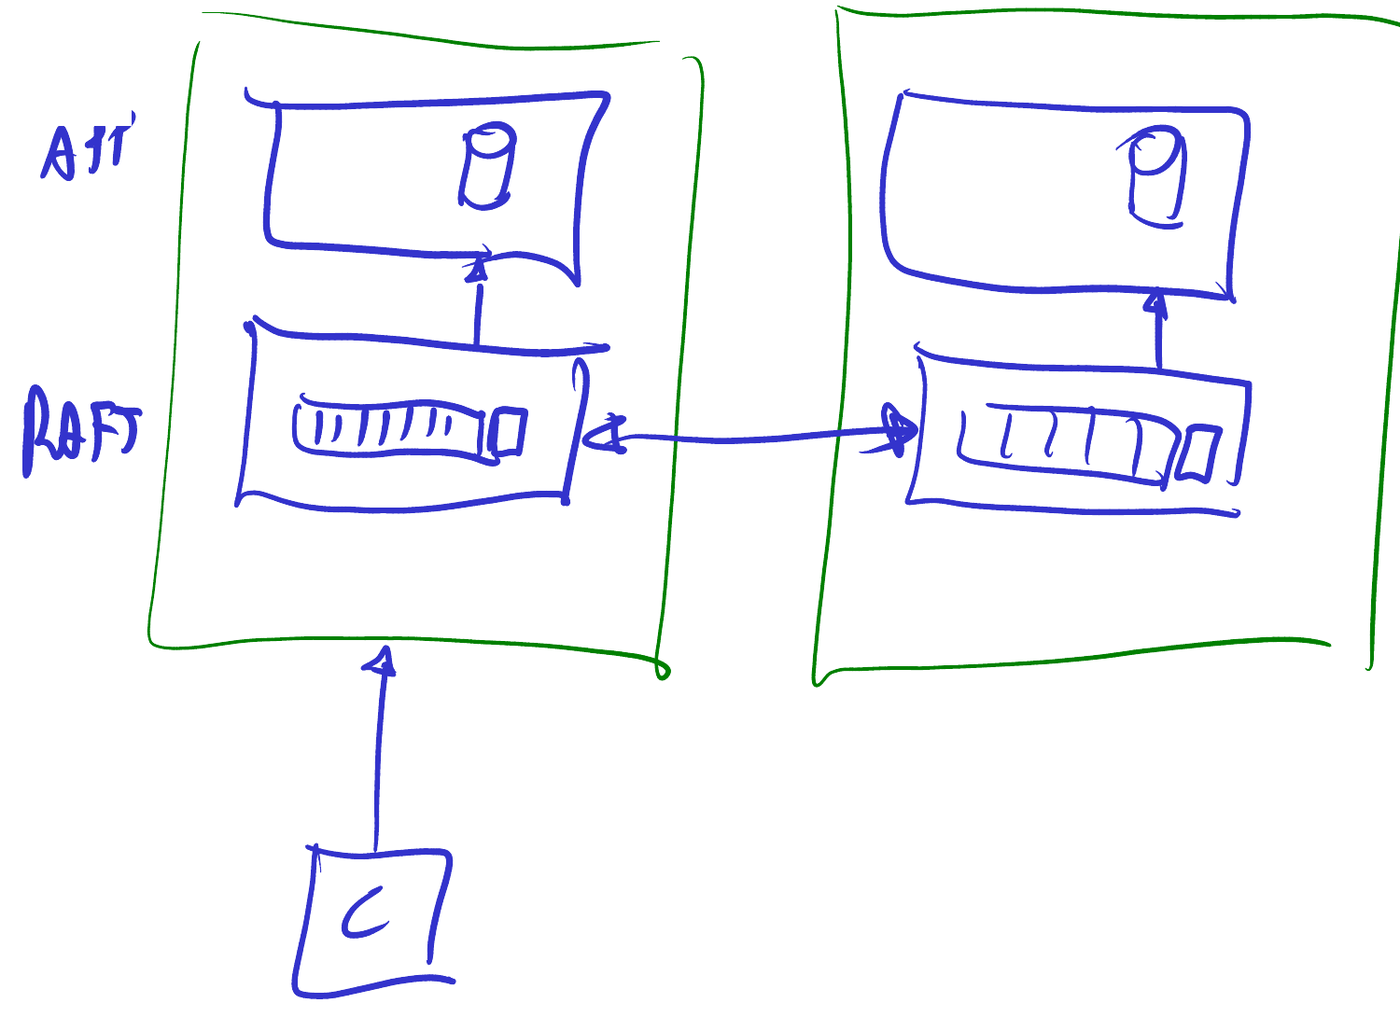
Y lo que vamos a ver, con mucho detalle, es lo siguiente: cuando un cliente escribe a nuestra aplicación, Raft agrega la operación al log, lo sincroniza con los demás nodos y después le avisa a la aplicación para que actualice. De modo que Raft resuelve el tema de replicar un log, y vamos a ver que no es sencillo: el algoritmo es complejo para tolerar fallas y poder replicar esas entradas. Pero va a hacer que la entrada termine apareciendo en la otra máquina, y cuando apareció en una cantidad suficiente se la pasa a la aplicación, que la aplica.
Generalmente Raft suele ser una biblioteca ya implementada por alguien —en el trabajo práctico la vamos a implementar nosotros—, y la aplicación suele ser una base de datos o cualquier otro programa. Pero aquí tenemos un log materializado físicamente: en el paper, y quizás como ejercicio, vamos a ver distintos logs en distintas máquinas que se desincronizaron y cómo se hace para actualizarlos.
No olvidemos para qué existe ese log: es lo que implementa la máquina de estados replicada, la esencia de la replicación que estamos usando aquí.
Ese log tiene además otra propiedad interesante, y aparece tanto si está materializado físicamente, como en Raft, como si lo tenemos en abstracto. Las operaciones van a tener una posición dentro del log, y a esa posición llamémosla timestamp. No es necesariamente el del reloj real: podría ser sintético, por ejemplo el orden dentro del log, 0, 1, 2, 3.
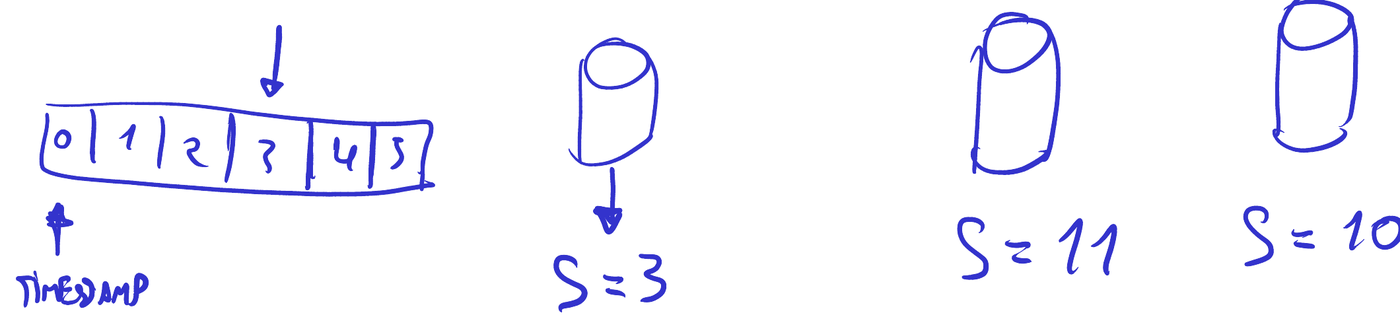
Eso nos da una consecuencia que varios sistemas aprovechan. Ya dijimos que la máquina es determinista y que partiendo del mismo punto el estado final es conocido; entonces, para identificar en qué estado está una réplica, alcanza con darle el mismo ID que tiene el log. Si aplicó hasta el tres y le falta el cuatro y el cinco, podemos decir que está en el estado tres.
¿Para qué sirve? Para saber si la máquina con la que nos comunicamos está más atrasada o más adelantada. El log, en abstracto, se transforma en una especie de versionado para cada réplica: si una está en el estado 11 y la otra en el 10, sabemos que la segunda está más atrasada y que eventualmente va a llegar al 11.
Es una propiedad que va a aparecer en algunos casos. Todas estas técnicas aparecen siempre, pero de manera implícita en los papers: hay que usar la imaginación para identificarlas. El versionado en particular aparece mucho: los datos y los nodos suelen tener versiones de una forma u otra, y cuando usamos un log la versión queda implícita.