4. Web servers: HTTP, load balancers y escalado
En esta sección
Caso de estudio: HTTP
El servidor de tiempo muestra la mecánica completa, pero es un ejemplo abstracto. Conviene entonces mirar uno real: HTTP.
Aquí el cliente es el browser que cada uno tiene delante: Chrome, Safari, Firefox. Y el servidor puede ser Apache, o Nginx, o alguno de los otros servidores disponibles. Lo interesante es que los dos mensajes se llaman exactamente como los veníamos llamando: el request se llama request y el response se llama response. Aquí no hubo que inventarles nombres distintos, porque el protocolo ya los usa.
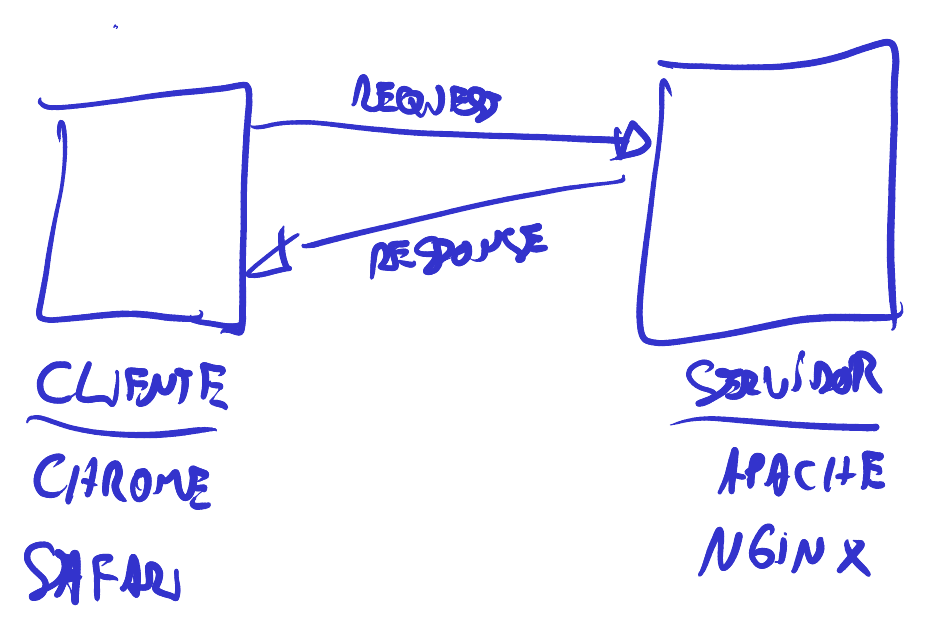
Ese request y ese response no hay que imaginárselos: quien haya trabajado en aplicaciones seguramente ya los vio, y quien no, puede reproducirlo sobre cualquier página, incluida la de la materia. Abriendo las herramientas de desarrollador del browser —las DevTools— hay una pestaña llamada Network, y ahí aparece en vivo todo lo que está haciendo la red: todos los requests y todos los responses. Esos paquetes se pueden filtrar por documentos, y eligiendo uno cualquiera —el calendario de la materia, por ejemplo— la herramienta muestra cómo fue el request y cómo fue el response.
Lo que aparece al abrir uno son, principalmente, unos headers que se mandan con el request y unos headers que se reciben con el response, y después el contenido de lo que el servidor nos mandó. La herramienta lo presenta de una manera de alto nivel y ordenada; pero lo que está pasando por debajo es una comunicación cliente-servidor de las que veníamos describiendo.
El protocolo HTTP es una mezcla de texto con binario. Los headers son lo primero que se manda, y después va el texto; todo eso se le manda al servidor y el servidor responde. Por lo menos HTTP/1 funcionaba así —hoy hay una versión más moderna—: uno manda un request y le responden, manda otro y le responden de nuevo. Y ese es el ejemplo más típico de cliente y servidor.
Todo eso que la herramienta muestra desplegado, los headers, y los parámetros de un formulario si el cliente le hubiera mandado alguno, es el mensaje de request. No son piezas sueltas que viajan por separado: se manda todo junto por el socket. Y lo que el otro nos responde, con el contenido entero de la página y sus headers, es el mensaje de response.
HTTP es de los protocolos que más se usan para implementar aplicaciones. Más adelante vamos a hablar de REST, que es cómo usar HTTP para realizar operaciones de proposito general sobre el servidor de destino. Pero por ahora HTTP nos interesa solamente como ejemplo básico de un cliente-servidor.
Caso de estudio: aplicación web
Lo que veníamos describiendo es la versión simplificada. Los sitios comerciales tipicamente están desplegadas de manera distribuida es decir, no conformadas por una unica PC sino por un cluster de las mismas. Es decir, que el servicio de HTTP provisto es un sistema distribuido en sí mismo. Miremos entonces cómo funcionan estas cosas en la vida real, siendo lo que sigue una anticipación de lo que vendrá más adelante en la materia.
Lo que típicamente tiene una arquitectura de estas es, en vez de un único servidor HTTP, un escalamiento horizontal: muchos de esos servidores, cada uno con una copia de la página. Del otro lado está el cliente, que es quien se quiere conectar, y entre medio está internet, con sus redes, su TCP y todo lo demás. Aparece naturalmente la pregunta de cómo se hace para llegar a una de esas máquinas en particular, ahora que son varias.
La respuesta habitual es que hay un dispositivo especial, que corre un sistema diferente del de las otras, y que es la que recibe la conexión. Vale la pena ser preciso: el socket, en realidad, es entre esa máquina especial y el cliente. Esa máquina, una vez que recibe la conexión, elige una de las máquinas de atrás —por ejemplo, al azar— y le manda el pedido. Ese es el ejemplo típico de lo que se llama un load balancer, un balanceador de carga.
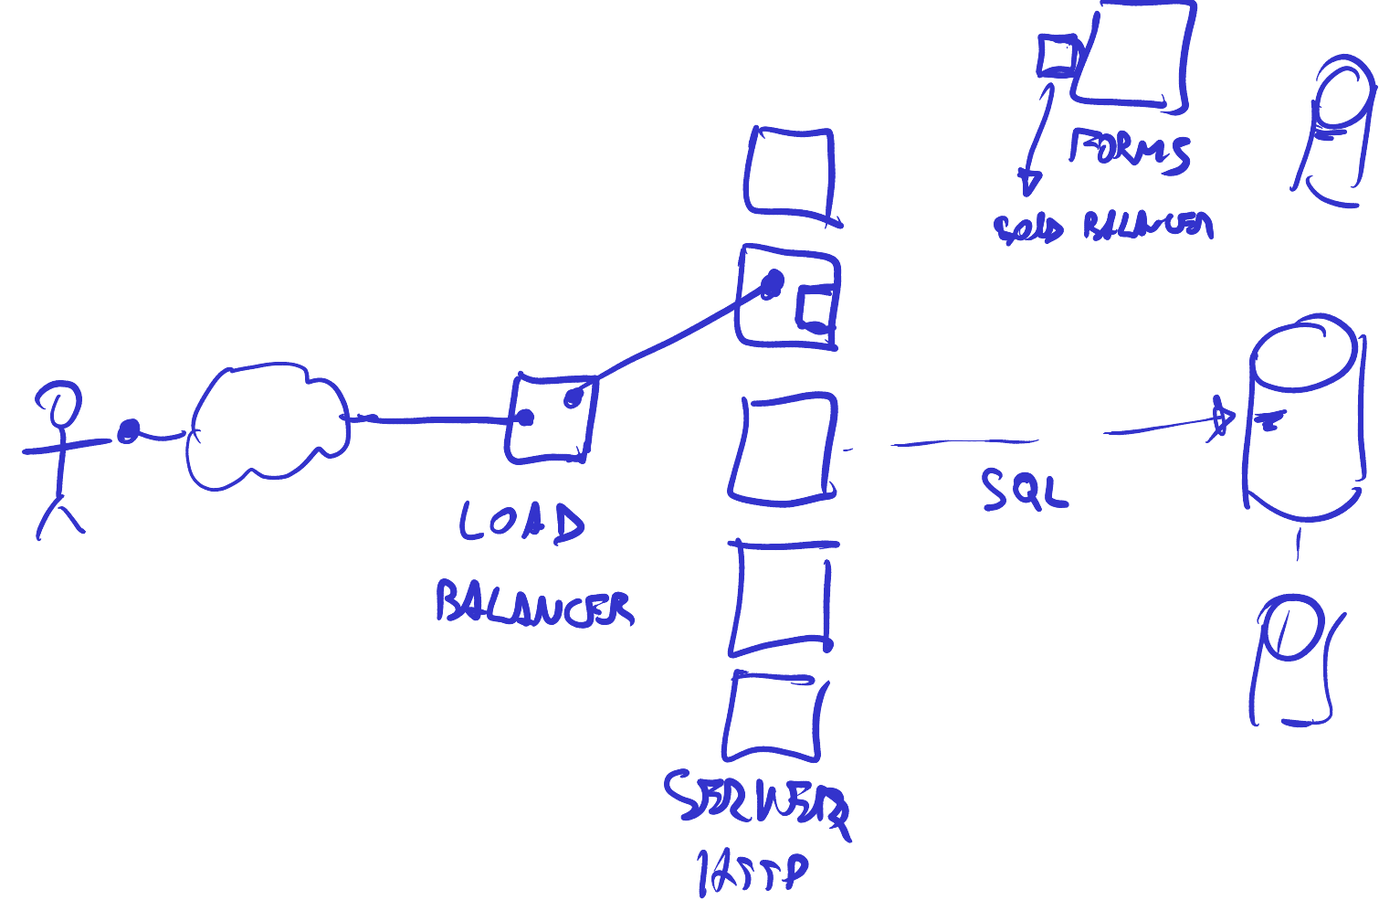
El nombre suele venir cargado de más. Si bien los balanceadores de carga suelen ser dispositivos que vende Cisco y por las que se paga muy caro, desde nuestro punto de vista no dejan de ser simplemente un nodo especial dentro del sistema distribuido, cuya única función es redirigir tráfico de un lugar para otro.
Ese nodo, generalmente, soporta muchísimas conexiones, y la razón es que no tiene que hacer mucho más que retransmitir pedidos. Los otros, en cambio, tienen que tener un file system, leer archivos del file system, cargar la página, implementar el protocolo HTTP y mandárselo al cliente. Como el balanceador hace muchísimo menos, y por lo tanto lo hace mucho más rápido, suele soportar muchas más conexiones que cualquiera de las máquinas que tiene detrás. Esto es un ejemplo de escalamiento horizontal.
Si la página de la facultad tuviera un formulario que hay que llenar y guardar, lo que se suele hacer es poner la base de datos aparte. Todos esos servidores web tienen la información estática de la página, y cada uno, cuando necesita acceder a la información, se conecta a la base de datos y le manda una query en SQL; la base la procesa y le responde. Esa base de datos es, en sí misma, otro nodo dentro del sistema.
Si queremos hilar más fino, se ve enseguida que algo quedó a medio hacer. Escalamos horizontalmente la parte de los servidores web, sí, pero tenemos una única base de datos: si eso se rompe es un punto central de falla. Y en este ejemplo un balanceador delante de la base no tendría sentido, porque hay una sola (destinaremos gran parte de nuestra materia para demostrar que simplemente agregar mas nodos a la base de datos no es algo tan trivial como parece).
Una de las posibles maneras de escalar la base de datos es con una estructura master-slave. A la base de datos original se le ponen réplicas: a la original se la suele llamar master, y a las otras, slaves o readers. La regla es fácil de enunciar: siempre que uno quiere escribir tiene que escribir en el master, y siempre que uno quiere leer puede leer del master o de cualquiera de las otras. Y para leer de las otras se puede poner un segundo load balancer, que recibe las consultas del clúster de servidores web y las reparte entre las réplicas disponibles.
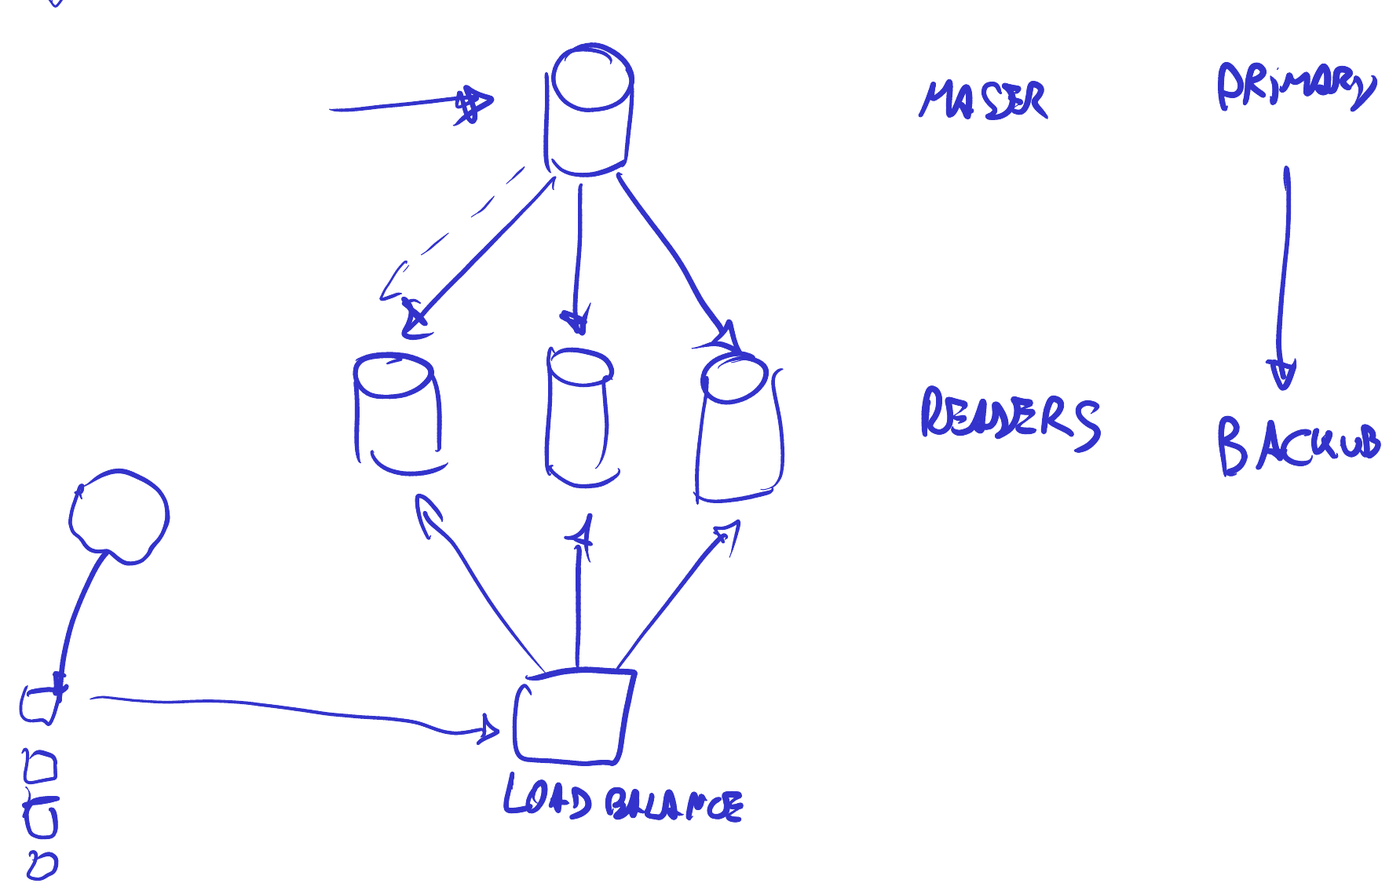
Esa no es la única forma de balancear la carga cuando uno tiene varios nodos replicados. Otra es que haya alguna máquina que le inyecte a cada cliente la lista completa de las réplicas que existen, de manera que cada uno elija a cuál quiere ir sin pasar por ningún balanceador. Son ejemplos, nada más: hay muchas formas de hacer todo esto.
Aparece aquí una pregunta natural, que apunta a cómo están armadas casi todas las aplicaciones de hoy. Si en lugar de una página con un solo servicio tuviéramos varios microservicios —uno de formularios, otro para los trabajos prácticos—, ¿alcanza con un único load balancer que reparta el tráfico entre todos, o cada microservicio necesita el suyo? Antes de contestar, una aclaración sobre el nombre: la base de datos del dibujo no es micro en ningún sentido, porque una base de datos es una pieza grande, y el prefijo no nos dice demasiado. Lo importante es que sean servicios separados, que podamos ir escalando de manera independiente uno del otro.
Con eso dicho, la estrategia es parecida a la que venimos describiendo. Cada servicio expone típicamente una forma de acceder a él, y esa forma suele ser un load balancer; y del load balancer para adentro es una caja negra, que internamente puede tener muchos componentes conectados de las maneras más distintas. Es un árbol que va creciendo. Pero hay una precisión que importa más que la respuesta misma: cuando decimos que un servicio “tiene que tener un load balancer”, el load balancer es apenas un ejemplo de cómo implementar la interfaz. Lo que vimos al principio de todo es que un sistema tiene que tener una interfaz por la cual se accede, y que uno no accede directamente a los nodos sino a través de ella; esa interfaz podrían ser APIs.
De hecho, ni siquiera hay que suponer que el balanceo vive en una máquina dedicada. A veces el balanceador está en el cliente mismo: cada cliente lleva incorporada una especie de balanceador local que conoce a todo el mundo y les distribuye el tráfico directamente. A veces son clientes muy básicos, que lo único que hacen es mandar un request y dejar que otro lo distribuya; a veces son clientes con bibliotecas grandes, que toman decisiones sobre cómo rutear el tráfico. Ese balanceador puede ser una biblioteca que uno compila junto con el programa, o —si se trabaja con containers— un sidecar. Hay muchas formas, y se están usando todas; por eso no hay una única respuesta.
Sobre las máquinas que están detrás del balanceador hay una pregunta razonable: esas instancias, ¿son todas la misma? Exactamente eso son, y tienen que serlo, porque el load balancer no toma decisiones complejas: elige una al azar, le manda el pedido, y esa responde. Una página estática como la de la materia funciona perfectamente con ese esquema.
Y con eso llegamos al punto que hay que retener: la esencia está en si el balanceo de carga se hace sobre algo que tiene estado o sobre algo que no lo tiene. Si los nodos del medio no tienen estado (stateless se le suele decir a ese tipo de nodos), es muy sencillo ponerles un load balancer adelante y elegir cualquiera al azar. Las bases de datos son muchísimo más complicadas, porque una base de datos es la antítesis de un nodo stateless: existe justamente porque tiene un estado. Ahí no podemos simplemente poner más bases al lado de la primera, porque si guardamos un dato en una y después lo leemos de otra, obviamente ese dato no va a existir ahí. Por eso hay que hacer algo intermedio, como escribir siempre en la misma —el master— y que esa después se lo vaya mandando a las demás. Si no tiene estado es muy sencillo; si tiene estado es, prácticamente, el 50 % de la materia, porque los sistemas de storage son interesantes precisamente por eso: por cómo escalamos sistemas que tienen mucho estado adentro. De cómo hacer un depliege de un web server prácticamente no vamos a hablar, porque eso ya se aprendió.