6. Ordenamiento de las operaciones
En esta sección
Hasta aquí el problema de la replicación quedó destilado en un único objeto: si conseguimos un log, es decir un orden total de operaciones en el que todas las réplicas coincidan, la replicación está resuelta, porque todo se reduce a aplicar esas operaciones sobre una máquina de estados determinista. Lo que no dijimos es cómo se consigue ese log. Vamos a ver un par de formas concretas, acercándonos un poco más a la implementación.
Pero antes conviene responder una pregunta que quedó pendiente desde el ejemplo de los dos clientes: ¿el cliente siempre se comunica con la misma máquina? ¿Y todos los clientes con la misma? Depende mucho del sistema. La pregunta importa, porque si hay muchos clientes conectados, cada uno enviando sus propias operaciones, establecer el orden se vuelve más complicado.
Raft lo resuelve así: siempre hay una máquina que actúa como líder, y las escrituras tienen que ir al líder. Si alguien le escribe a otra, la solución estándar es que esa máquina sepa quién es el líder y le redirija el pedido, lo cual puede dar la impresión de que se le puede escribir a cualquiera cuando en realidad se pasa por una especie de proxy. En otros sistemas hay que escribirle directamente al líder, y si no, devuelve error. Y ese líder no es necesariamente el mismo para siempre.
Con las lecturas el asunto suele ser más flexible: algunos sistemas permiten la lectura no consistente, o con consistencia eventual, y eso permite leer un dato quizás desactualizado; otros garantizan que siempre esté actualizado. Lo que no es en absoluto evidente es la escritura: a cuál máquina le escribimos y cómo se decide.
Log externo
Una forma de resolverlo es delegarle el problema a otro sistema. No se usa tanto, pero es la más fácil de imaginar: mantener el log fuera del sistema. Ese “fuera” es discutible, pero el esquema sería así: tenemos varias instancias del sistema y todas consumen de ese log. Evidentemente el log no está en el aire, tiene que haber un sistema que lo gestione, y un ejemplo es Kafka.
¿Y cómo hace Kafka para mantenerlo? Es un problema en sí mismo, y más adelante vamos a leer su paper. Pero si lo damos por resuelto —lo instalamos, lo configuramos y no nos ocupamos de su funcionamiento interno—, lo que sigue es sencillo: todas las escrituras del cliente van al log y las instancias operan leyendo de ahí. Son todas iguales entre sí y reciben las mismas operaciones en el mismo orden.
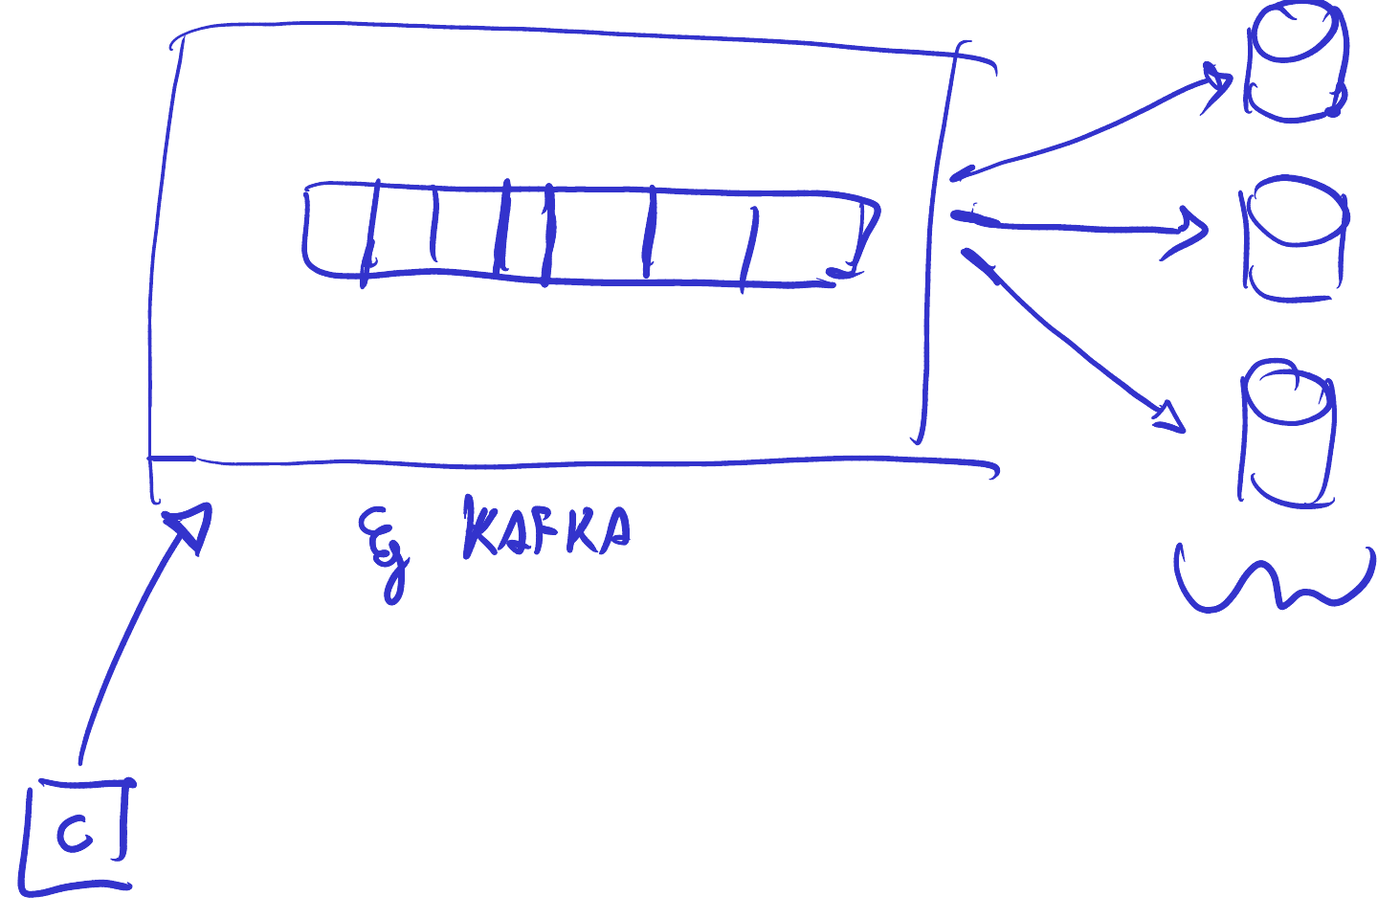
Aparece una objeción natural: ¿no es esto un sistema de streaming de datos, donde el ordenamiento surge de cuál llega primero? Es cierto que el orden surge de quién llega primero, pero lo importante es que hay un único lugar que decide. Si dejamos de lado las transacciones y pensamos en operaciones individuales, el problema que queremos resolver es definir un orden y que todas las réplicas se pongan de acuerdo en cuál es la siguiente operación. Visto así, no importa en qué orden llegan: importa que todas vean el mismo orden. Kafka nos resuelve eso de manera casi transparente, precisamente porque centraliza la decisión.
A este esquema se lo suele llamar active-active, un término que aparece en el artículo de Kreps: todas máquinas iguales, consumiendo de un log común que define el orden.
Pero conviene decirlo con claridad, porque si no queda la sensación de haber ganado más de lo que ganamos: esto es el problema del huevo y la gallina. No lo resolvimos, lo delegamos en una caja negra que se llama Kafka. Así que conviene empezar a pensar concretamente en cómo resolver el problema del log.
Primary-backup
La segunda forma es la más interesante de las dos, y conviene detenerse en ella porque casi todos los sistemas que vamos a ver son variaciones suyas. Se la llama primary-backup.
En qué consiste es fácil de describir. Existe una máquina particular, el primary, y muchas otras que son backups de esa primera. Cuando alguien escribe algo, necesariamente se lo envía al primary, y este a su vez les va enviando las operaciones a los backups. Cuando alguien lee, la lectura puede ir a los backups o directamente al primary. Lo esencial es que el primary actualiza su propio estado y después se lo transmite a los demás.
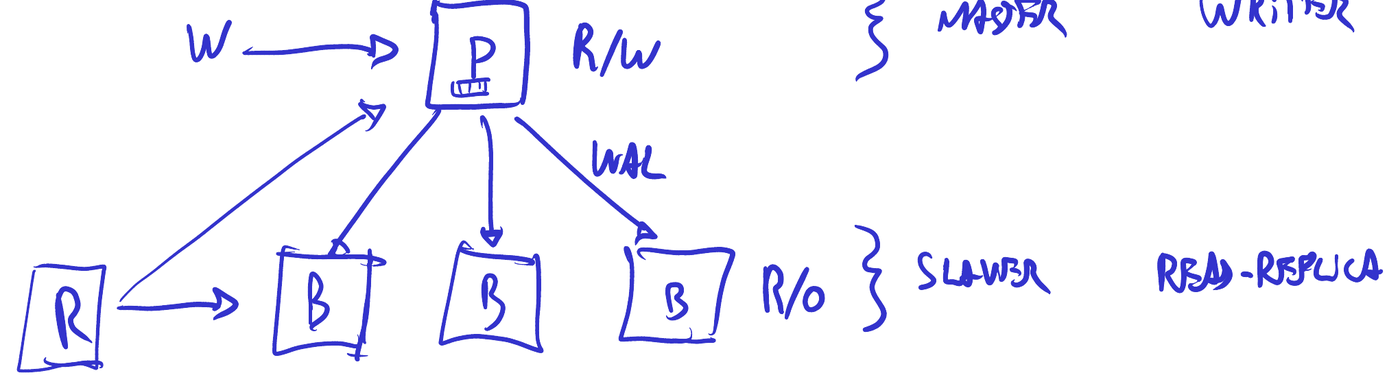
Hay otros nombres: a veces master y slaves, a veces writer y read-replica. El más genérico es primary-backup, precisamente porque aparecen versiones suyas en muchísimos lugares. De hecho, Raft es en el fondo un primary-backup, con una diferencia importante: ahí el primary no está fijo, sino que si falla, otra máquina se transforma en primary automáticamente y todo se restaura.
Pero el caso más común es más modesto: la forma habitual de agregarle escalabilidad a una base Postgres es hacer exactamente esto. Una instancia se define como el writer, de lectura y escritura, y las otras quedan de solo lectura. Y lo que el primary les envía es el WAL: el write-ahead log, además de servir para restaurar las transacciones que fallaron, se les va emitiendo constantemente a los backups, que eventualmente se actualizan.
La esencia está en una frase: el primary determina el orden, y en estos casos simples lo determina unilateralmente. ¿A qué nos referimos con unilateralmente? A que no les consulta a los backups si están muy atrasados o si les puede enviar otra escritura: va aceptando todo en el orden en que le llega y va decidiendo. Si es un Postgres, implementa los mecanismos comunes de transacciones y agrega los commits, que son operaciones especiales dentro del WAL.
Y ahí está la clave del mecanismo: el primary es una máquina sola, y para una máquina sola es fácil decidir cuál operación va primero. El consenso se resuelve porque deja de ser distribuido, y sin esa palabra deja de ser un problema. Los movimientos del primary son tres, en este orden: determina el orden, aplica localmente la operación y emite a las réplicas.
El ejemplo concreto es muy común en bases de datos. La documentación de Postgres explica qué comandos usar para definir una máquina como writer y las otras como réplicas, que se tienen que conectar a un slot de replicación. Es la forma más básica de todas y, por eso mismo, la que menos nos va a ocupar.
Es un esquema muy común en bases relacionales, y tiene un problema: en la implementación típica, a menos que se realicen verificaciones especiales, tiene consistencia eventual. Salvo que en cada operación el primary espere que todos los backups la reciban y vaya coordinando las escrituras, típicamente aplica localmente, continúa con su trabajo y se lo envía a las réplicas, que pueden estar un poco desactualizadas. Quien lee del primary tiene la fuente de verdad; si consulta un backup, quizás obtenga información desactualizada.
Esta es probablemente la primera instancia de consistencia eventual que vemos, y le corresponde un nombre más académico: es un sistema no linealizable. Cuando veamos ZooKeeper vamos a definir con precisión qué es ser linealizable, pero por ahora alcanza con la caracterización. Un sistema linealizable —o de consistencia fuerte— garantiza que si le enviamos una escritura al sistema, visto como un todo abstracto, y después leemos, no vamos a leer una versión vieja. Y suele ser una propiedad global: siempre que cualquier nodo escribió algo y otro lo lee, lee el dato actualizado. Lograr eso es mucho más costoso. Aquí, en cambio, se consigue automáticamente si todas las lecturas van al primary.
En cuanto a la tolerancia a fallas, el esquema cubre bien una mitad del problema y mal la otra. Si falla un backup no es grave: tendríamos que tener otro sistema monitoreando todo, de manera tal que levante un backup nuevo y lo ponga al día. Y ahí reaparece el snapshot: se toma una imagen reciente de lo que tiene el primary, se precarga en el backup nuevo, y después ese backup consume el WAL hasta quedar actualizado. Es un proceso lento, costoso y no del todo automático, pero en principio el esquema es tolerante a fallas.
El caso difícil es el otro. Si falla el primary en un sistema básico como este, y no como Raft, el asunto se complica, especialmente si es de consistencia eventual: puede ocurrir que se aplique una operación en el primary y que este falle antes de emitirla a los backups. Típicamente, para evitarlo, hay cierto nivel de coordinación: se escribe en el primary, se envía a los backups y no se le responde al cliente hasta que algunos la tengan. Pero eso también puede ser más problemático.
En algunos sistemas se le da más importancia y en otros menos a que falle el primary y se puedan perder datos. Por eso conviene hablar de pérdida potencial: no siempre está garantizado que perdamos datos, porque hay formas de que el primary coordine un poco con los backups. En Raft, que no es un primary-backup tan rígido pero que en cierto momento funciona como uno, con un líder y followers, si falla el líder actual no hay forma de perder datos. Por eso vamos a invertir dos clases en comprender ese asunto.
Aparece una pregunta natural: si actualizamos un dato y acto seguido queremos leerlo, ¿cómo sabe el sistema que tiene que leerlo del primary? No lo sabe, y no necesariamente lo hace: depende de cómo se escribió el cliente. En estas bases relacionales, las bibliotecas que se incorporan al web server suelen ser sofisticadas y permiten definirles la dirección del primary y la de las réplicas, de manera tal que al programar uno puede indicar que una lectura necesita ser consistente —y eso obliga a ir al primary— o que lea de cualquier lugar disponible, que son las lecturas que más escalan. Es decisión del programador, no del sistema.
En los otros sistemas, donde el primary-backup está más oculto, depende mucho de cada caso. En Raft las lecturas requieren especial atención: si queremos una lectura consistente no basta con leerla de cualquier nodo y esperar que lo sea.
Change Data Capture
El log externo y el primary-backup no son dos opciones entre las que haya que elegir: la combinación de ambas es la parte interesante, y es la que se encuentra implementada en la práctica. Con toda la ingeniería de datos que existe actualmente, este tipo de arquitectura aparece en todas partes.
Muchas empresas tienen una base relacional, que puede ser Postgres. Esa base emite su WAL, pero aquí no se lo emite directamente a una réplica: se lo emite a un nodo cuyo único trabajo es leer eso e irlo enviando a un log. Y ese log puede ser Kafka.
Ese nodo intermedio no es una construcción teórica. Hay muchos productos que hacen exactamente esto, y hay un proyecto open source que conviene tener presente por el nombre: se conecta a la base simulando ser una réplica, lee el WAL y lo envía a Kafka. Se llama Debezium.
Y del otro lado del log tenemos algo parecido al primer ejemplo: muchos nodos consumiendo del log. La diferencia es que aquí cada uno hace algo distinto, y ahí está lo verdaderamente útil: los consumidores no tienen que ser otras bases Postgres, pueden ser sistemas completamente diferentes.
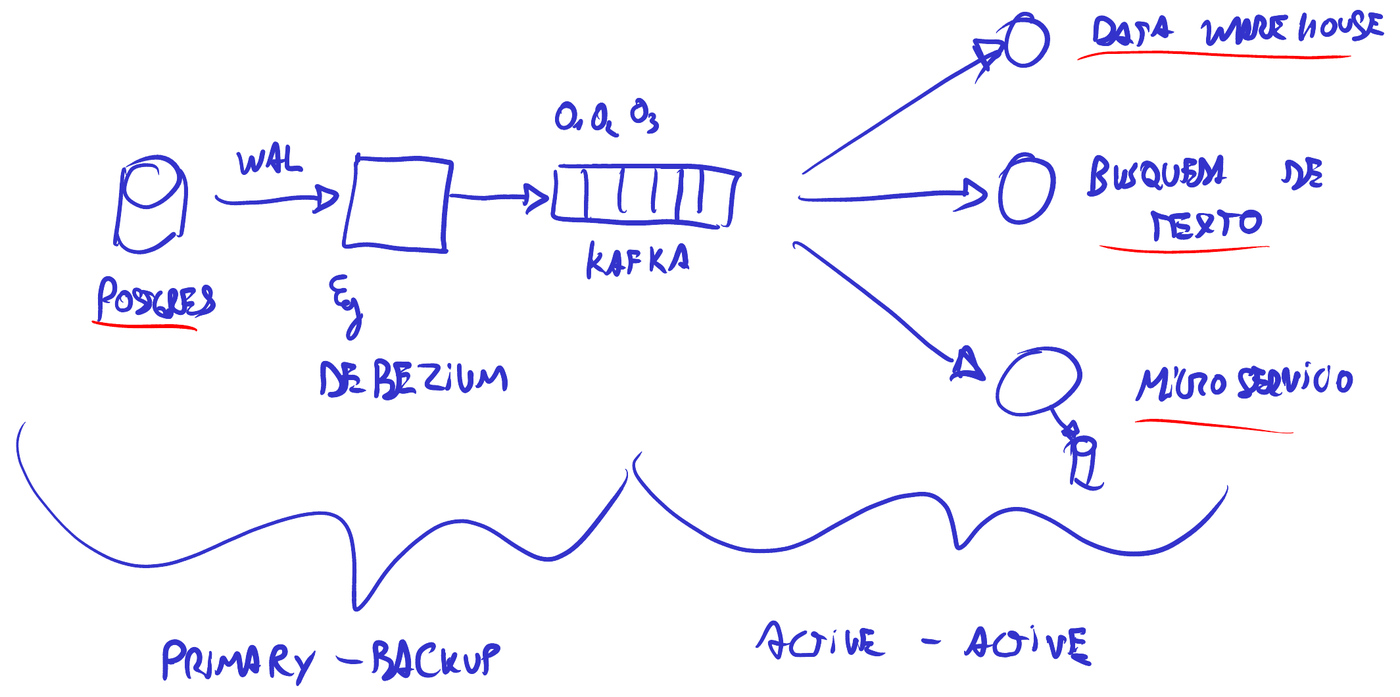
El primer consumidor puede ser un data warehouse: un nombre ambicioso para una base que en general no es relacional y que está más especializada en queries analíticas que transaccionales. Sirve para generar reportes de forma más eficiente y para obtener datos en tiempo real, gráficos y dashboards, que contra una base relacional común la sobrecargan. Suelen soportar grandes cantidades de datos no tan normalizados y usan storage columnar.
Lo importante para nosotros es otra cosa: no es una base relacional y, sin embargo, al recibir las operaciones en el mismo orden puede materializar una base de datos equivalente. No la misma: equivalente. Como una réplica de la primera, pero en otra tecnología.
El segundo consumidor puede ser un buscador de texto, de los que ya conocemos: Elasticsearch, OpenSearch. Va consumiendo las mismas operaciones de la base que actúa como fuente de verdad, y cuando queremos buscar un texto lo buscamos ahí; después, si hace falta, obtenemos el resto de la base principal.
El tercero puede ser cualquier microservicio, y este caso es muy frecuente en el trabajo real. Siempre aparece el mismo problema: está la base que contiene a los usuarios y están los microservicios que los utilizan. Normalmente les alcanza con el ID, pero eventualmente hay que detectar que se dio de baja un usuario y eliminarlo del microservicio. Eso suele ser complejo de coordinar, y esta arquitectura lo resuelve: se toma el Postgres, se emite el WAL y lo van consumiendo los microservicios; la mayoría de las operaciones se ignoran, pero cuando aparece una de eliminar un usuario, el microservicio actualiza su base interna.
Ahora, si observamos el dibujo completo, aparece la lectura que es el punto de esta subsección. El tramo de la izquierda se parece a un primary-backup, donde el backup viene a ser Debezium combinado con Kafka: hay una máquina que decide y algo que la sigue. Y el de la derecha se parece a un active-active, con el log en el medio y un conjunto de consumidores conectados a él. Conviene tomar esos nombres con flexibilidad: lo importante es la estructura, cómo circula la información de un lugar a otro, y que los que consumen a la derecha no tienen ninguna relación en estructura de datos con los que están al principio.
Todos los nodos del dibujo son distintos tipos de máquina de estados replicada, todas recibiendo las operaciones en el mismo orden. El Postgres define unilateralmente ese orden, pero todas terminan teniendo la misma información: una vista diferente de lo mismo.
Y con esto se comprende una frase del artículo de Kreps que de otro modo resulta extraña: que el log es el dual de la base de datos. Lo dice en el sentido de que con el log podemos reconstruir la base. Aunque “dual” no es del todo correcto, porque en sentido inverso no funciona: de la base no podemos obtener el log, ya que no contiene todas las operaciones.