3. Organización cliente-servidor
Cambiamos ahora de tema y pasamos a algo mucho más concreto: la organización cliente-servidor. Muchas veces la vamos a llamar cliente-servicio, que es como la nombra el libro del MIT, para diferenciarla un poco de la noción de cliente y servidor a nivel de sockets.
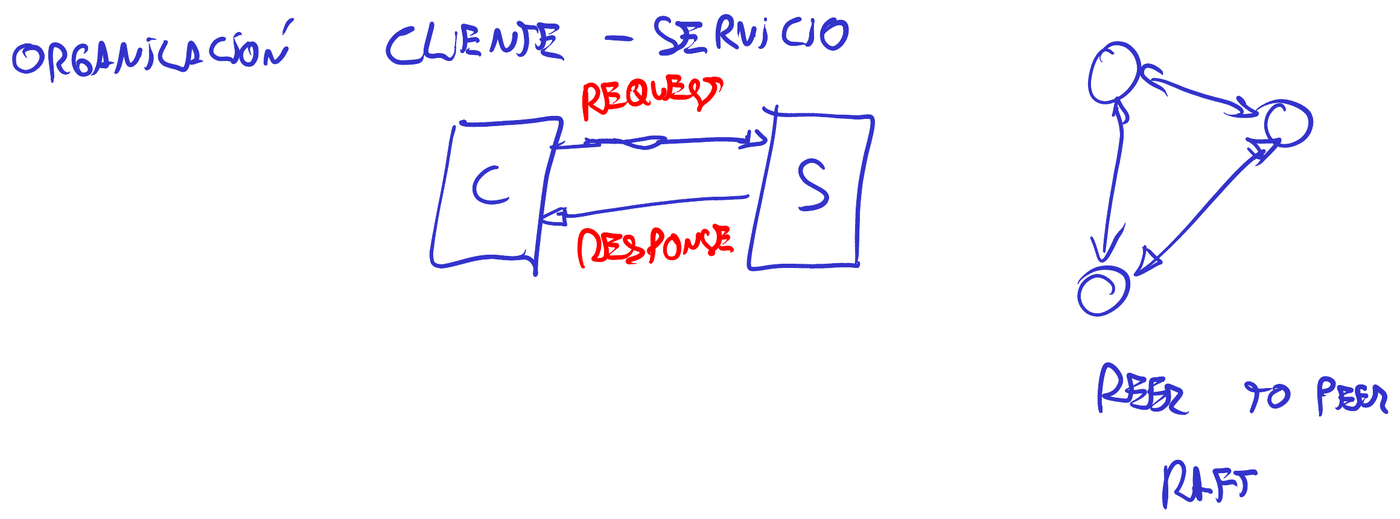
Lo primero es dejar de pensar en TCP/IP: esto es distinto. El énfasis, en esta organización, está puesto en otra parte: en que hay una asimetría entre estos dos nodos. El cliente sigue siendo el que inicia la comunicación, es cierto, pero la definición que nos interesa es más semántica, casi filosófica: no es el cliente porque inicie la conexión TCP, sino porque es el que necesita algo que le puede proveer el servicio del otro lado. Y el servidor le responde.
Esos dos mensajes tienen nombre propio, y son términos que van a reaparecer a lo largo de la materia: el mensaje que el cliente le manda al servidor se llama request; el mensaje con el que el servidor le contesta se llama response. Las definiciones no son tan estrictas: no necesariamente tiene que haber siempre un response con contenido, y a veces es apenas un “okay, lo recibí”.
La diferencia con el cliente y el servidor de TCP es sutil, y por eso mismo puede resultar confusa. El cliente de TCP es el mismo cliente del que estamos hablando ahora, y el servidor de TCP es el mismo servidor: no estamos apuntando a otras máquinas ni a otros roles. Lo que se agrega es la asimetría.
La asimetría se ve mejor por contraste con los sistemas peer to peer, donde todos son compañeros entre sí, todos comparten información y a lo sumo alguno obtiene temporalmente un rol. El ejemplo es Raft, un protocolo esencialmente peer to peer: todos los nodos pueden actuar de cualquier cosa, y ninguno tiene información más privilegiada. En cliente-servidor la situación es distinta: el servidor tiene algo y el cliente tiene otra cosa.
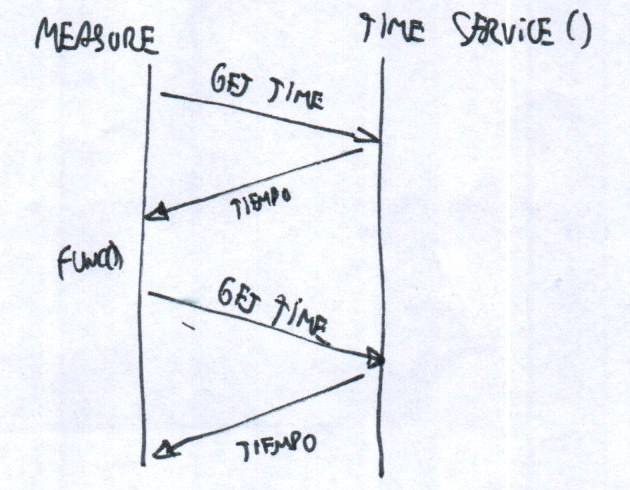
Un ejemplo pequeño alcanza para ver la mecánica completa, y de paso introduce una convención de dibujo que vamos a usar varias veces: el diagrama de tiempo. El tiempo va de arriba hacia abajo, hay una línea para la máquina cliente y otra para el servidor, y los mensajes se representan con flechas.
El servicio del ejemplo es un servidor de tiempo: lo único que hace es decir la hora que es. Cabe preguntarse por qué un cliente le preguntaría eso a otra máquina en lugar de mirar su propio reloj, y la respuesta es que no confía en su reloj y quiere un reloj global.
El cliente quiere calcular cuánto tarda la ejecución de una función. La secuencia es esta: manda un get time y el servidor le responde con el tiempo; ejecuta la función; vuelve a mandar un get time y el servidor le responde de nuevo; y hace la resta. Eso le da la duración de la función, más un pequeño excedente que para el ejemplo no importa.
Implementarlo en abstracto no lleva mucho: alcanza con un pseudocódigo que después podría escribirse en cualquier lenguaje.
Client program

 1  procedure MEASURE (func)
 2      SEND_MESSAGE (NameForTimeService, {"Get time", CONVERT2EXTERNAL(SECONDS)})
 3      response ← RECEIVE_MESSAGE (NameForClient)
 4      start ← CONVERT2INTERNAL (response)
 5      func ()                          // invoke the function
 6      SEND_MESSAGE (NameForTimeService, {"Get time", CONVERT2EXTERNAL(SECONDS)})
 7      response ← RECEIVE_MESSAGE (NameForClient)
 8      end ← CONVERT2INTERNAL (response)
 9      return end - start

Service program

10  procedure TIME_SERVICE ()
11      do forever
12          request ← RECEIVE_MESSAGE (NameForTimeService)
13          opcode ← GET_OPCODE (request)
14          unit ← CONVERT2INTERNAL (GET_ARGUMENT (request))
15          if opcode = "Get time" and (unit = SECONDS or unit = MINUTES) then
16              time ← CONVERT_TO_UNITS (CLOCK, unit)
17              response ← {"OK", CONVERT2EXTERNAL (time)}
18          else
19              response ← {"Bad request"}
20          SEND_MESSAGE (NameForClient, response)
Del lado del cliente, la línea 2 es la función del socket: SEND_MESSAGE es el send, y recibe dos cosas. La primera es el nombre del canal, que en la práctica sería un file descriptor. La segunda es el mensaje que lleva adentro el nombre de la función que queremos ejecutar del otro lado, "Get time". Lo acompaña un parámetro, la unidad en la que pedimos el tiempo, y el servicio la valida: la línea 15 exige que la operación sea la que espera y que la unidad sea segundos o minutos, y si algo de eso falla contesta "Bad request". El ejemplo usa además dos nombres de canal distintos, uno para cada sentido, un detalle que vamos a revisar más adelante.
Después de mandar hay que quedarse a la espera de la respuesta, y eso es la línea 3: RECEIVE_MESSAGE, que sería un read del socket. Y cuando llega todavía falta la línea 4: hacer una conversión. Esos bytes hay que transformarlos en un tiempo, en algo con lo que el programa pueda operar, que aquí significa poder restarlo. Vale la pena enfatizar las tres, porque se repiten siempre:
- Hubo que mandar un mensaje
- Hubo que quedarse esperando la respuesta
- Hubo que convertir lo que llegó.
Toda esa secuencia hay que repetirla, entera, para la segunda medición. Las líneas 6, 7 y 8 son idénticas a las 2, 3 y 4, y lo único que cambia es dónde se guarda el resultado.
Esa función de conversión que aparece cuatro veces en un programa tan corto tiene nombre propio: en la jerga se lo suele llamar marshalling, y también serializar. Consiste en tomar un objeto de más alto nivel —un struct, un objeto, prácticamente cualquier estructura del lenguaje— y transformarlo en un stream de bytes. La razón es la que ya conocemos: por los sockets uno manda bytes, como si fuera un archivo. Del otro lado se recorre el camino inverso y se reconstruye algo que el programa pueda usar, que es lo que hacen las llamadas a CONVERT2INTERNAL.