4. Persistencia
En esta sección
Toda la clase se apoyó en un supuesto que utilizamos sin examinarlo: que las máquinas fallan y se recuperan con frecuencia y que, al recuperarse, conservan cierta información. Ese supuesto se denomina persistencia y tiene un costo. Hay que responder cuáles son los datos que deben sobrevivir a que un servidor falle y se recupere, y en qué orden hay que realizar las operaciones para que sobrevivan.
Estado persistente
Los datos que hay que guardar en disco ya los conocemos: están enumerados en la figura 2 y los fuimos utilizando durante toda la clase. Lo que falta es explicar por qué son importantes, y la respuesta es que hay datos que deben sobrevivir a que los servidores fallen y se recuperen.
El ejemplo más sencillo es el del voto. Un candidato le envía un RequestVote a un nodo y el nodo vota a favor. Después ese nodo cae y se recupera. Aparece entretanto otro candidato, que le envía un RequestVote también a él, y vuelve a votar a favor. Ese nodo votó dos veces en la misma elección sin violar ninguna regla del algoritmo: cayó y se recuperó en el medio, y al recuperarse no conservaba ningún recuerdo. El estado debe mantenerse incluso cuando los servidores se reinician o se desconectan parcialmente.
Lo interesante es que, observando la figura 2, son solamente tres los datos que hay que guardar en disco por este motivo. El primero es currentTerm: los servidores, cuando fallan y se recuperan, deben recordar en qué término estaban antes. El segundo es votedFor, que es el caso del párrafo anterior y el más fácil de justificar. Y el tercero es el log, que es fundamentalmente lo persistente: siempre que se le responde afirmativamente a quien nos envía una entrada, antes hay que garantizar que si fallamos y nos recuperamos no la perdimos. En todos los ejemplos decíamos con frecuencia “llega esta entrada, cae, se recupera”: para que la entrada siga estando, tiene que estar persistida en disco.
Todo lo demás se puede reconstruir a partir de los mensajes que los servidores comienzan a intercambiar. Y aquí se salda una deuda de la sección 2: cómo se reconstruye el índice de commit. Un líder que se recupera no va a saber hasta dónde estaba comiteado su log; la figura 2 indica que el commitIndex se inicializa en cero. A partir de los primeros AppendEntries que les envíe a los otros va a averiguarlo, según cuánta mayoría le responda. La posición del índice sí la conoce, porque el log es persistente y está completo. Envía el AppendEntries, una mayoría responde afirmativamente, y por definición el commitIndex es ese; entonces lo actualiza y se lo comunica a los vecinos, que quizás ya lo supieran. Lo relevante es que se puede inferir. Con lastApplied ocurre lo mismo: es lo que ya se aplicó en la capa superior, y también se reconstruye por sí solo.
Queda currentTerm, el más sutil de los tres. Volvamos al esquema de los tres servidores con los términos 5, 6 y 7 en uno y 5 y 8 en los otros dos. Una forma de intentar inferir el término actual, para un nodo que se recupera, sería observar por dónde va su log: si tiene 5, 6 y 7, inferir que estamos en el término 7. Eso no es correcto, porque para los otros dos servidores, si hubieran caído en ese punto y se hubieran recuperado después, el sistema ya está en el 8. El nodo debe recordarlo, porque en algún momento ocurrió una votación en la que se avanzó el término aunque no se eligió líder, y en la que no se recibió ninguna entrada de log. En algún momento ese nodo supo que se pasó por el 6 y por el 7; y cuando se transforme en candidato, en lugar de indicar 6 o 7 va a tener que indicar 8.
Escritura a disco antes de responder
Hay un principio que importa no solo para Raft sino para los sistemas distribuidos en general, y es el orden en el que se realizan las operaciones. Siempre que establecemos que un dato debe ser persistente, el orden es este: primero al disco —o al storage persistente, que puede ser un SSD o cualquier otro dispositivo—, y después la respuesta. Nunca a la inversa.
Veámoslo sobre el caso que venimos utilizando durante toda la clase. El cliente le envía un request al líder, el líder lo guarda, le envía un AppendEntries al follower, y el follower lo guarda en su log —literalmente: para que le responda afirmativamente al líder, antes debemos contar con una garantía del sistema operativo de que la entrada está en disco. Si se responde afirmativamente y la escritura falla después, todo queda inconsistente.
El escenario concreto es el peor que puede ocurrirnos: el follower le responde afirmativamente al líder, cae y se recupera de inmediato. El líder contabilizó esa respuesta y concluyó que la entrada estaba en una mayoría, cuando en realidad no está guardada en el disco del que acaba de recuperarse. Quedó convencido de algo que no es cierto, y todos los razonamientos de mayoría que hicimos se apoyaban en que esa respuesta afirmativa fuera verdadera.
Aquí conviene un cambio de perspectiva que ordena todo el asunto: estas situaciones siempre hay que analizarlas desde el punto de vista del cliente, y en este caso hay que considerar que el líder es el cliente que le está enviando datos al follower. Si el follower responde OK, el líder cuenta con esa garantía: el OK significa que la entrada está en el disco del otro, no en su memoria.
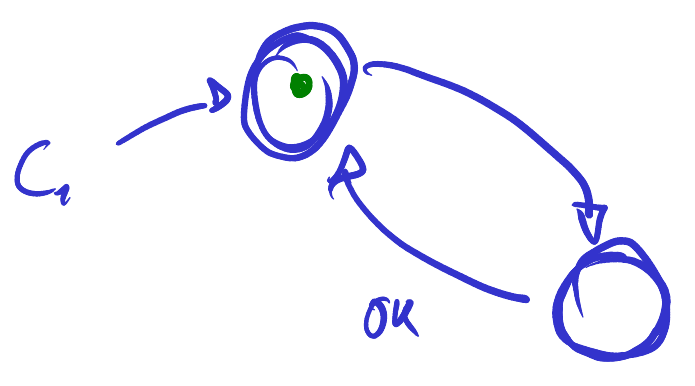
Concretamente, y son las dos garantías que hay que implementar: que un AppendEntries devuelva OK significa que el log está en disco; y que un RequestVote responda garantiza que el voto está en disco.
Surge aquí una pregunta natural sobre la sincronización de los logs: cuándo comienza, si puede ocurrir también como respuesta a un heartbeat o solamente cuando se le hace un start al líder. Imaginemos un servidor que se reincorpora después de mucho tiempo, con el log desactualizado. Como es follower no va a tomar la iniciativa, se mantiene a la escucha. En algún momento el líder va a enviarle un heartbeat, y probablemente ese AppendEntries vacío le llegue mucho antes que uno con una entrada. Lo que debe hacer, recién reincorporado, es verificar si el término que le envían es mayor que el suyo. Si lo es, actualiza su currentTerm, y con eso ya sabe que estuvo fuera de servicio: primero persiste ese término, después le responde afirmativamente al líder, y al responder verifica los logs e informa que le faltan entradas. De modo que sí, la sincronización también comienza como respuesta a un heartbeat.
Y de hecho no conviene pensarlo tanto como heartbeat, porque lo único que existe es AppendEntries, que funciona como heartbeat cuando va vacío. Los dos van a comenzar a sincronizarse incluso con el mensaje vacío: si no coincide, el follower va a responder negativamente, y el líder de inmediato va a comenzar a enviarle entradas de log hasta que se actualice.
Sobre esa primera respuesta negativa hay un detalle preciso de orden de escritura. Probablemente el servidor que cayó estaba en un término antiguo, porque el término avanzó mientras estaba fuera de servicio, así que antes de responder negativamente tiene que guardar el término en disco. Después no necesita actualizar nada más, y conviene revisar los tres datos persistentes: el currentTerm lo acaba de actualizar; el votedFor no lo modifica, porque no estamos en una votación; y el log tampoco, porque todavía no le enviaron nada. Recién cuando se alinean los logs recibe el bloque de entradas en un solo envío, lo guarda primero en disco, y entonces responde afirmativamente.
Queda una última correspondencia entre los mensajes y los datos persistentes. El AppendEntries es la oportunidad para actualizar el log en disco y el término; el RequestVote, para el voto en disco y probablemente también para el término, porque el término se puede actualizar en cualquier mensaje. Eso también lo establece la figura 2: siempre que alguien me envía un mensaje con un término mayor, asumo que yo estoy desactualizado y el otro está en lo correcto, porque asumo que el algoritmo está funcionando bien.
Queda el tramo más interesante desde el punto de vista de la implementación: qué significa que los datos estén escritos en disco. Es una cuestión de performance. Es habitual pensar que ejecutar un write alcanza para que los datos queden en disco. Sin embargo, write no garantiza que los datos estén en disco: garantiza que están en un buffer y que probablemente se escriban eventualmente. Para Raft eso no alcanza: no importa que estén en la memoria de Raft o en la del sistema operativo, tienen que estar en el disco que resiste la falla. Eso se garantiza con otra llamada al sistema, fsync, que vacía todos los buffers. Hay que ejecutar las dos operaciones antes de responder OK, un write y un fsync; de lo contrario se rompe la propiedad de persistencia, que según la figura 2 es un requerimiento para la correctitud del algoritmo.
Y de allí surge el problema de performance, porque el write utiliza buffers justamente para que todo sea rápido. Los anchos de banda involucrados dan la escala de lo que se está evitando: la memoria mueve del orden de 50.000 MB por segundo, un SSD del orden de 10.000 MB por segundo, y un disco rígido mecánico unos 80 MB por segundo. Utilizar buffers es operar en el primero de esos números; ejecutar fsync es descender al del dispositivo que efectivamente resiste. Si por cada entrada de log hay que ejecutar un fsync, especialmente en un sistema que recibe muchos requests, el resultado va a ser muy lento.
Lo que corresponde hacer es agrupar las escrituras en lotes. Todas las implementaciones van a recibir muchos requests, los van escribiendo, y eventualmente ejecutan un fsync de todo el conjunto; y a ninguno se le puede responder nada hasta que ese fsync se completa. Los va ordenando, escribiendo uno después del otro, con lo cual el orden queda definido, y recién cuando los tiene en disco puede continuar y escribirles a los peers. Es una optimización a considerar en los sistemas reales: si el requerimiento es persistencia, tiene que ser persistencia, y eso resulta poco performante. La estrategia consiste en acumular muchos requests en memoria antes del fsync y después responderles a todos en conjunto.