2. Transacciones read-write: two-phase commit y locking sobre Paxos
Vamos primero con las read-write, y esto es en buena medida un repaso de two-phase commit. Imaginemos dos participantes —en un sistema real la lista seguramente sea más larga, pero con dos alcanza para ver la mecánica— y el cliente, que es el que les manda las cosas. El cliente somos nosotros usando el sistema: un frontend, cualquier programa que consulte la base.
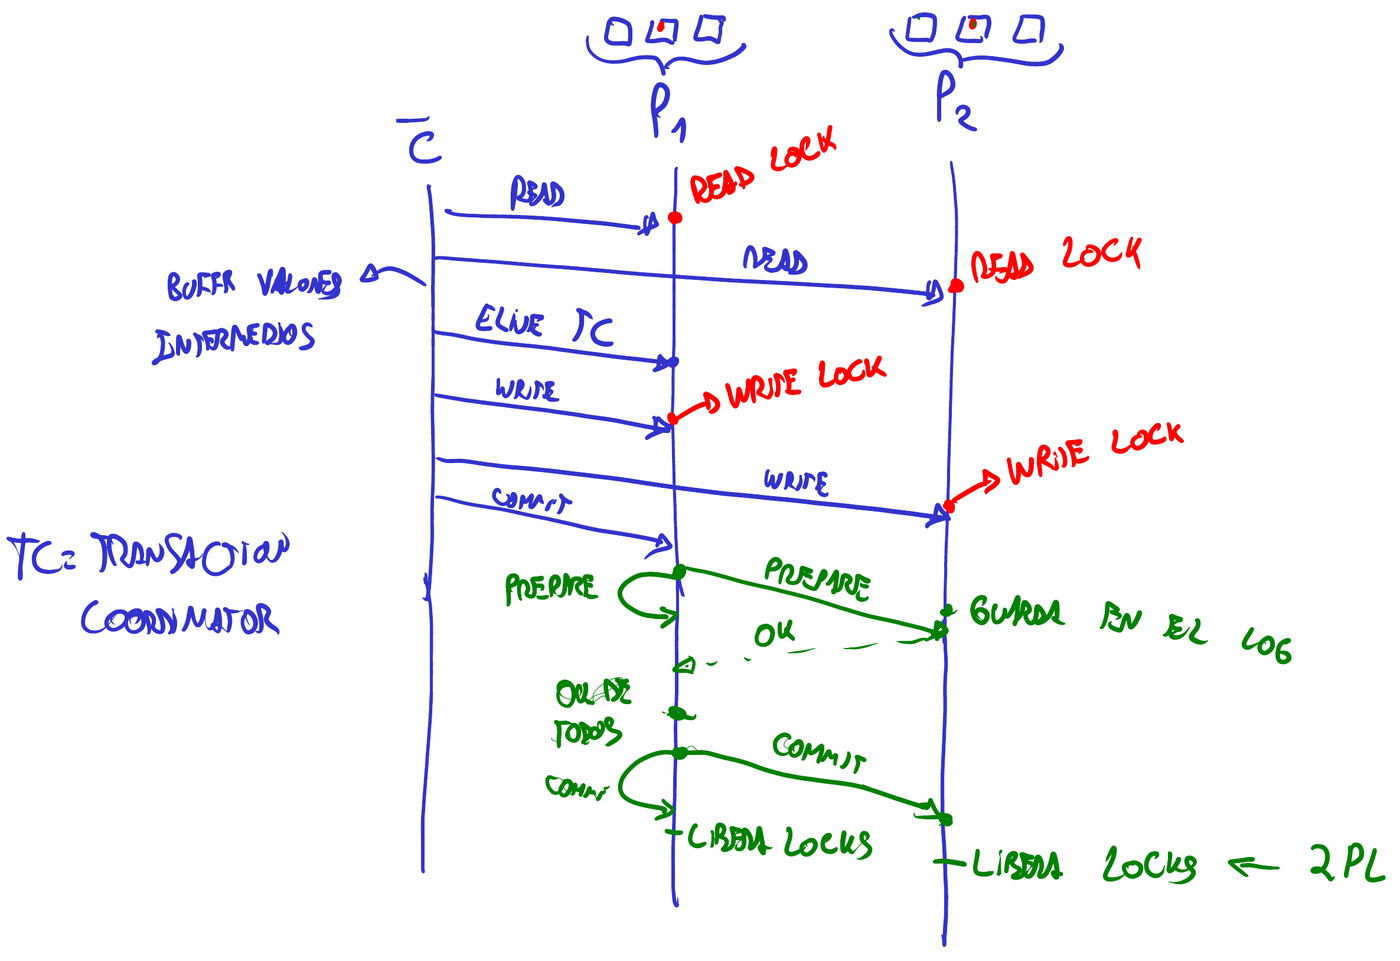
Sobre los participantes hay algo que sostiene todo lo demás: cada grupo de réplicas —cada Paxos group o replication group— es un participante. Cuando uno le manda comandos, la capa de más bajo nivel en realidad está replicando y obteniendo los quórums. Cuando decimos “esto lo escribimos en este paso”, en realidad lo estamos escribiendo replicado, y por lo tanto es tolerante a fallas. Va a ser fundamental que lo sea, porque eso es lo que hace que todo el sistema funcione.
La transacción se implementa así: el cliente puede hacer cualquier cosa adentro, pero primero manda todas las lecturas, obtiene los valores de los distintos participantes, hace las cuentas localmente, va almacenando localmente en un buffer los valores finales, y después manda todos los writes juntos. Y esto usa locking de dos fases: cuando le mandamos un read a un participante, hay que obtener un read lock del registro que estamos leyendo. En el otro participante, otro read lock.
Por ahora el coordinador no apareció. En el two-phase commit que vimos había un coordinador, y va a ser interesante qué se hace con él, pero por ahora el cliente simplemente va mandando reads a cada grupo de réplicas, y esos read locks se guardan localmente: no se replican. Se guardan en el líder del grupo: de las tres réplicas del participante, una es el líder, y ahí se van guardando los locks a medida que llegan los reads. ¿Y si ese líder se muere? Se aborta la transacción. Todavía no pasó nada —ni siquiera mandamos los writes—, así que podemos abortar todo si hay un cambio de líder.
Eventualmente el cliente quiere hacer commit, y entonces tiene que elegir. Conviene ubicar bien este paso: entre las flechas de los reads y las de los writes hay una flecha más, la elección del transaction coordinator, el TC. Quizás los detalles no sean exactamente así, pero básicamente el cliente elige a uno de los participantes y le indica que será el coordinador del commit. No hay un sistema aparte que sea el coordinador, como en DynamoDB, ni un transaction coordinator global: entre todos los participantes —y cada participante es en definitiva un shard de la base— el cliente elige uno, y ese orquesta todo lo demás. Además de la data del shard, ese TC va a tener algunas estructuras internas donde guardar sus cambios de estado. Por ahora no guarda nada; cuando eventualmente le diga commit al otro participante, ahí sí habrá estado que anotar.
A continuación, el cliente manda a cada participante los valores que quiere escribir, que venía guardando en el buffer de valores intermedios. El algoritmo es algo intrincado, pero conviene seguirlo hasta el final. Lo importante es que antes del write hay que obtener un write lock. Al write lock se lo suele llamar lock exclusivo, porque para obtenerlo no tiene que haber nadie con ningún lock de ninguna clase. Los read locks, en cambio, los pueden tener varios a la vez. Si dos transacciones obtuvieron el read lock y las dos quieren el write lock, se produce un deadlock, y una de ellas debe abortarse. Cómo resolver deadlocks es tema de la materia de concurrentes, y abordarlo nos alejaría del tema.
¿Por qué el cliente hace las cosas en este orden, un poco contraintuitivo? Para minimizar las comunicaciones. Con leer los valores iniciales alcanza: los leyó y tomó sus locks, y como tiene el lock sabe que nadie se los va a modificar. Puede modificarlos localmente todo lo que quiera, y cuando tiene los valores finales se los manda.
Ahora sí arranca el two-phase commit de la clase pasada. El TC manda los prepare, también a sí mismo —internamente no debe ser un prepare, pero conceptualmente lo es—, y al otro participante, que responde OK. Cada vez que se inicia el proceso de commit y entramos en la primera fase, el TC tiene que ir guardando las respuestas. Como ya vimos, si fallaba a mitad del proceso todo quedaba bloqueado, porque el otro participante queda esperando el commit. Del mismo modo, el participante, cuando responde, lo guarda en log persistente, y siempre que lo guarda en el log lo guarda en las tres réplicas. La garantía de que el mecanismo no queda bloqueado indefinidamente es que está todo replicado y tolera fallas.
Eventualmente el coordinador recibe la confirmación de todos: registra el commit y le manda el commit al otro. Cada participante aplica el commit, y ahí libera los locks. Liberarlos al final era la parte del two-phase locking: el two-phase locking estricto nos obliga a liberar los locks después del commit.
Hasta aquí es un two-phase commit con locking pesimista bastante típico. La única rareza es que no usa un coordinador externo sino uno de los participantes, seguramente para ahorrarse máquinas: podría haber un coordinador externo que replique su propio estado con Paxos, y el sistema funcionaría igual.
Hay algo interesante en este intercambio, que sirve como repaso. El two-phase locking garantiza serializabilidad. No es linealizabilidad, aunque en este caso garantiza las dos cosas —a eso vamos a llegar—. La serializabilidad era la propiedad de las transacciones: aunque las máquinas ejecuten muchas transacciones a la vez y las operaciones individuales se entrelacen, el resultado tiene que ser como si se hubieran ejecutado una después de la otra. En particular, nos tienen que quedar snapshots consistentes entre una transacción y la siguiente. ¿Por qué lo garantiza? Porque está demostrado matemáticamente; es una de las cosas que demostró Jim Gray, del que hablábamos la vez pasada.
El resultado se publicó en “The notions of consistency and predicate locks in a database system” (Eswaran, Gray, Lorie y Traiger, 1976); Gray es uno de los cuatro autores.
Spanner es famoso por TrueTime y los relojes atómicos, pero esta parte no tiene nada de eso. Todavía es un sistema bastante estándar de bases de datos, solo que distribuido. Y que cada cambio de estado se persista con Paxos en las réplicas es lo que hace que el two-phase commit no sea inestable. Tradicionalmente se evitaba hacer two-phase commit en un sistema distribuido, porque si se rompía el coordinador por la mitad quedaban todos los participantes bloqueados esperando el commit. Como aquí el estado está replicado, si se rompe el coordinador se elige un nuevo líder, que sigue mandando los mensajes: el algoritmo no se bloquea infinitamente.
Esto se parecía también a DynamoDB. DynamoDB sí tenía un transaction coordinator separado, pero ese coordinador guardaba su estado en una tabla especial de DynamoDB. Era algo circular, pero como esa tabla también replicaba con Paxos, los dos usan indirectamente la misma estrategia para que el two-phase commit distribuido no se bloquee.
Pero esto es lento. Según el paper, tarda entre 10 y 100 milisegundos, lo cual para transacciones de un sistema en línea es relativamente lento.
Los números salen de la tabla IV del paper, que mide el two-phase commit según la cantidad de participantes: 14,6 ms de media con uno solo, 33,8 ms con cincuenta y 122,5 ms con doscientos. Y la tabla VI mide lo que percibe F1, el sistema de anuncios de Google que corre sobre Spanner, a lo largo de veinticuatro horas de producción: 72,3 ms para un commit de un solo sitio y 103,0 ms para uno multisitio.