5. Log compaction y snapshots
Queda un último tema, y conviene examinarlo con atención porque no es exclusivo de Raft: aparece en otros sistemas, con otros nombres, resolviendo el mismo problema. Se denomina log compaction y se desprende directamente de la persistencia que acabamos de ver: es la consecuencia incómoda de haber decidido que el log sea lo único que se guarda.
Crecimiento del log y snapshots
Si uno lee el paper con esa decisión presente, encuentra algo que a primera vista desconcierta: el log es lo único persistente, y del estado de la capa de aplicación el paper no dice una palabra. Puede resultar extraño, y en los sistemas reales la aplicación suele tener su propia persistencia, pero el paper asume el peor caso: que la aplicación —lo que teníamos dibujado en la parte superior del esquema de capas, con Raft abajo, la aplicación en el medio y una base de datos o lo que corresponda— podría perfectamente residir en memoria. Y para Raft eso es aceptable.
De ese supuesto se desprende una consecuencia inmediata: como el log es lo persistente y la capa superior no, cuando un servidor cae y se recupera tiene que reaplicar desde el origen, entrada por entrada desde el índice cero, para reconstruir el estado de la aplicación. Así lo veníamos pensando, y es exactamente lo que el compaction va a modificar. La estrategia cierra perfectamente: si guardamos el log de manera permanente, siempre podemos reconstruir la base de datos aplicando nuevamente todas las operaciones.
Hay dos problemas evidentes. El primero es que resulta muy lento aplicar desde el principio cada vez que un servidor se recupera; ninguna base de datos procede así, a pesar de que todas hacen algo similar para restaurarse. El segundo es que el log crece indefinidamente: si hay varias operaciones por cada fila de la tabla de la capa superior, el log va a terminar siendo mucho más grande que la aplicación misma, y la mayor parte van a ser entradas antiguas que, si todo funciona correctamente, no vamos a reaplicar nunca.
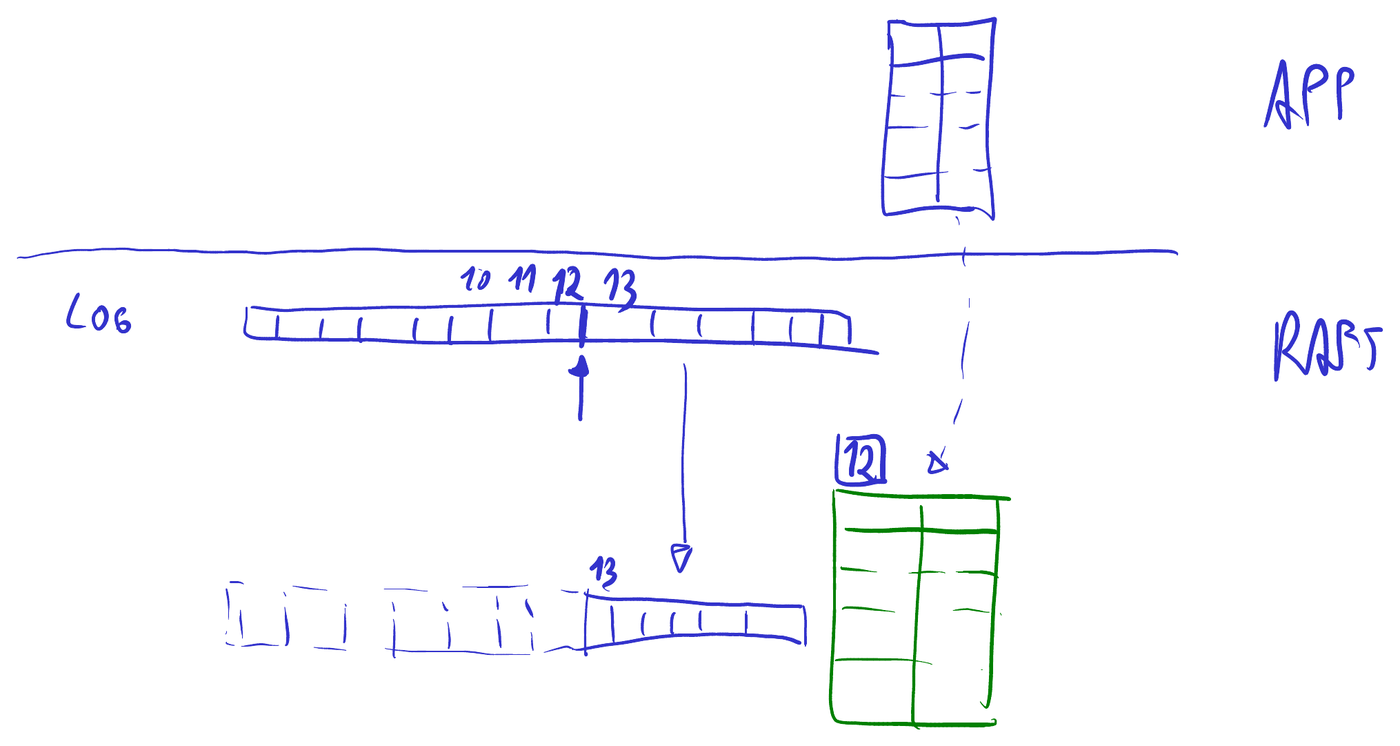
La técnica que resuelve ambos problemas es el log compaction, y conviene representarla gráficamente: abajo el log de Raft, la secuencia de entradas que avanza; arriba la aplicación, con todas sus filas. Vale la pena detenerse en la capa superior, porque es fácil pasarlo por alto: a Raft no le interesa qué hay allí. Puede ser una tabla, un key-value store, un árbol de archivos; para Raft son bytes y nada más.
El mecanismo consiste en que, cada cierto tiempo, Raft se detiene, toma el log en algún punto y obtiene un snapshot de la base de datos. Para eso tiene que salir de su capa y dirigirse a la aplicación, solicitándole una copia del estado de la base tal como está en ese momento. Esa división del trabajo es la que vuelve general al mecanismo: la iniciativa es de Raft, que decide cuándo se toma el snapshot, y la ejecución es de la aplicación, que sabe qué contiene y cómo serializarlo. Tendrá sus complicaciones, porque debe ser un snapshot consistente: no puede tener una mitad en un estado y la otra mitad en otro. Cómo se logra lo retomamos al final de esta sección.
Ese snapshot es una copia de los bytes de la capa superior, y para Raft es opaco: no sabe interpretarlo, es un array de bytes que va a almacenar. Lo único que sí hace es etiquetarlo con la posición en la que estaba: si veníamos con los índices 10, 11, 12, 13, registra que el 12 es la posición hasta la cual está aplicado el log; ese snapshot tiene, desde el origen, todo aplicado hasta el 12.
Y después toma el log y elimina todo lo anterior a ese punto, liberando el espacio. El log va a seguir existiendo, porque continuaron llegando entradas: el snapshot se toma al final del log, pero mientras se estaba tomando siguieron llegando entradas y siguió avanzando la aplicación, que es parte de por qué la manera de tomar el snapshot constituye un asunto aparte.
Hay un detalle de la representación que conviene aclarar para no confundirse con los índices: el tramo eliminado se considera conceptualmente existente. No se reinicia la numeración; esa entrada sigue siendo la 13, y desde allí continúa. Simplemente el log se eliminó desde ese punto hacia atrás.
Las ventajas son evidentes. Cuando un servidor caiga y deba recuperarse, restaurar la aplicación va a ser mucho más rápido, porque no tiene que recorrer el log desde el principio; ni siquiera lo conserva, el principio ya no existe. Lo que ejecuta es el restore, en dos pasos: primero toma el snapshot y se lo envía a la capa de aplicación, que del mismo modo en que lo serializó ahora lo deserializa y lo coloca nuevamente en memoria; después toma el log desde la posición 13 —porque sabe que en el 12 estábamos aplicados— y aplica cada una de esas entradas de nuevo, un replay con el que se pone al día.
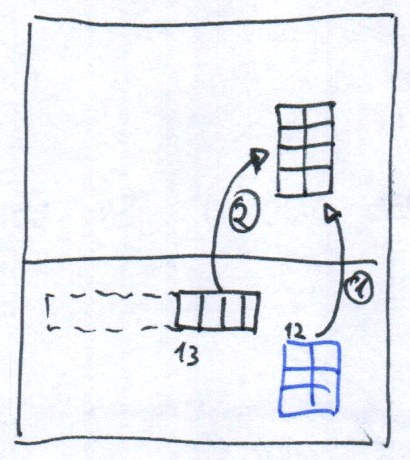
Con eso quedaron resueltos los dos problemas iniciales, cada uno en un lugar distinto del mecanismo: el de la lentitud lo resuelve el restore, que parte del snapshot en lugar de partir del origen, y el del disco que se llenaba lo resuelve la eliminación del tramo antiguo.
Es una técnica similar a la de las bases de datos, aunque allí resulta más difícil porque el log se utiliza además para hacer rollback de las transacciones. Aquí sirve únicamente para restaurar la aplicación.
InstallSnapshot
Queda un último detalle, y es el que mayor dificultad va a presentar a la hora de implementar el trabajo práctico: eliminar entradas del log introduce un problema considerable.
Veamos un ejemplo sencillo. Dos servidores, S1 y S2, y en algún lugar estará el tercero. S1 tiene apenas dos entradas; S2 tiene varias, pero las primeras están dibujadas en otro color, y ese color significa algo preciso: ese tramo del log fue eliminado, ya no existe, no está en disco ni en ningún otro lugar.
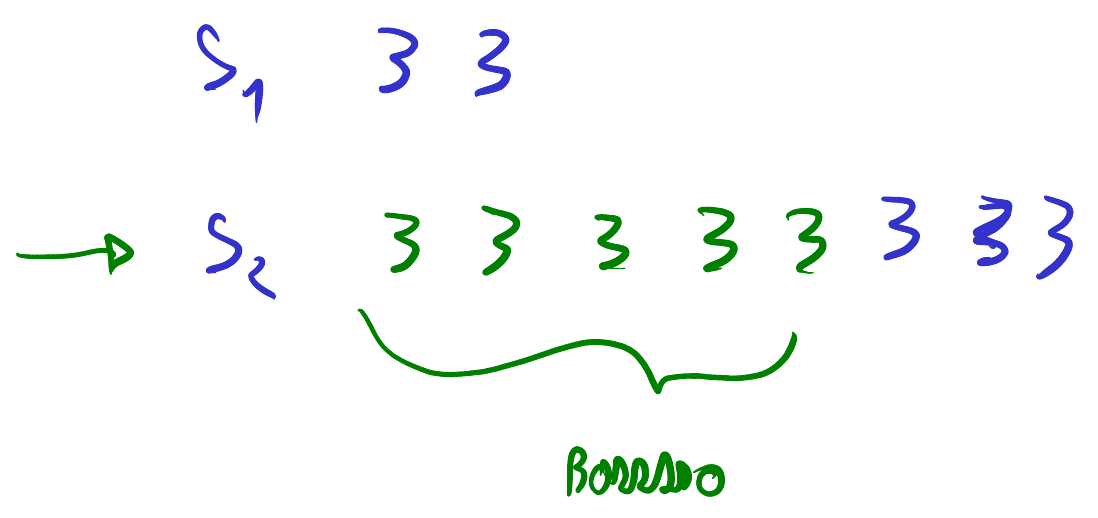
Entonces, cuando S2 sea elegido líder —o cuando advierta que el otro está atrasado porque le envió un AppendEntries y recibió una respuesta negativa—, va a intentar escribirle. Le envía una entrada, el otro la rechaza; le envía dos, después tres; y eventualmente advierte que el otro está tan atrasado que ya no conserva ninguna de las entradas que necesitaría para seguir rebobinando. El rebobinado, que en la sección 2 siempre terminaba encontrando el punto de coincidencia, aquí se queda sin material, y si no se toma ninguna medida S1 nunca podría actualizarse.
La solución requiere un mecanismo adicional, que el paper presenta en la sección 7 junto con la compactación del log. Tiene sentido, pero agrega complejidad.
Imaginemos el líder y el follower desactualizado. El líder tiene su log, un snapshot que había guardado previamente, y la aplicación de la capa superior con la información al día; el log del follower es breve, no contiene nada relevante. Cuando el líder advierte que no puede seguir rebobinando, ¿cómo hace para actualizarlo?
Le envía una operación diferente, InstallSnapshot. Hasta este punto todo el diálogo entre líder y follower se había desarrollado mediante AppendEntries; esta es una operación nueva que existe únicamente para este caso. El líder le comunica que ya no puede avanzar por la vía habitual y le envía todo el snapshot que tenía guardado, que siguiendo el ejemplo anterior estaba etiquetado con el 12.
El receptor realiza dos acciones. La primera: en el caso habitual su log ya no le resulta útil y puede eliminarlo por completo. Hay una excepción: si el snapshot cubre solo un prefijo de su log —por ejemplo, por una retransmisión—, conserva las entradas posteriores al snapshot (figura 13 del paper). La segunda: recibe el snapshot, lo almacena en algún lugar —quizás ni siquiera lo almacene— y se lo transfiere a la capa de aplicación, que debe restaurarlo. A esa altura vamos a estar con un snapshot en la posición 12 del log anterior, porque ese 12 es lo que nos lo indica. Y después falta lo que va del 13 en adelante, que el líder debe enviarle para que lo aplique. Eso viaja por separado: la operación nueva transporta únicamente el snapshot, junto con el índice y el término hasta los que está aplicado, y si el snapshot es grande se divide en fragmentos y viaja en varios mensajes. Las entradas siguientes vuelven por el AppendEntries habitual, con el mecanismo que ya conocemos, una vez que el follower quedó posicionado en el 12.
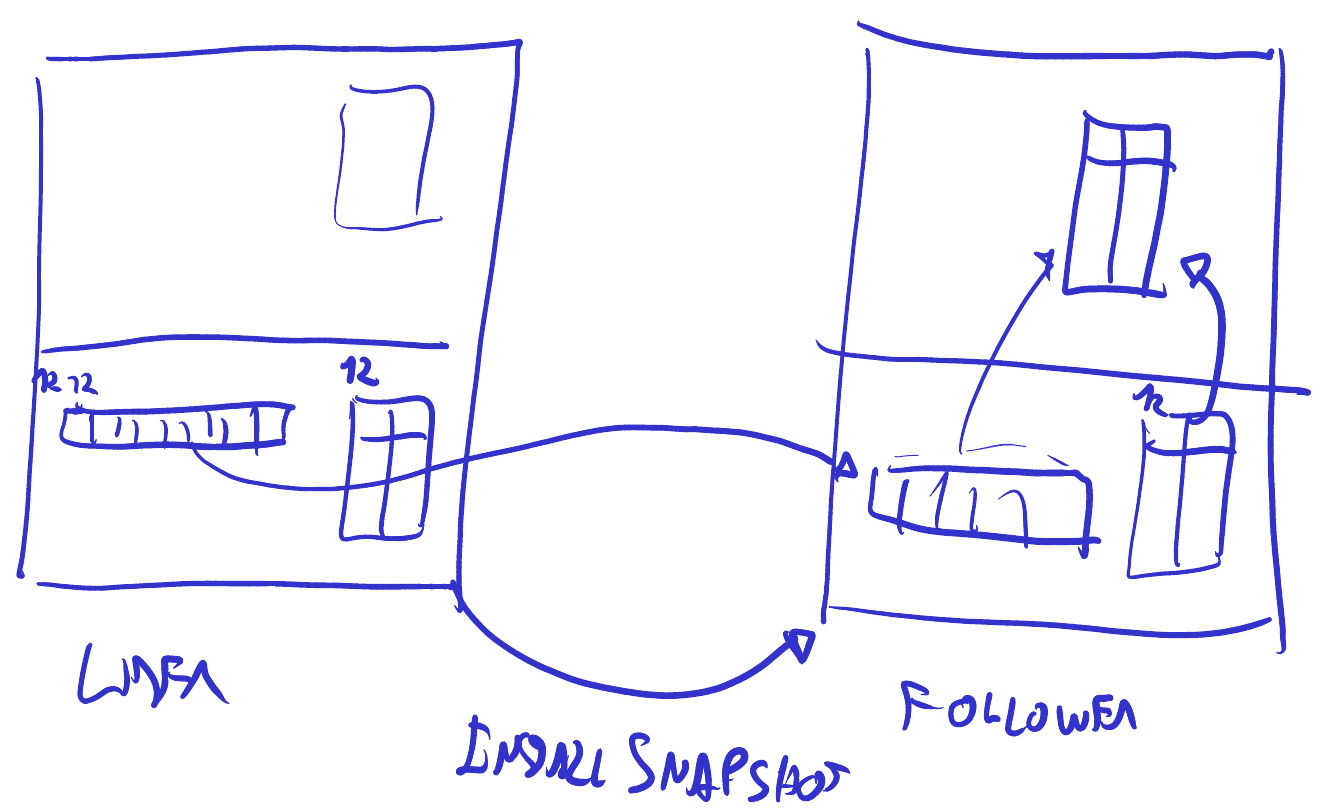
Además, el propio paper reconoce que el mecanismo de snapshots se aparta del principio de líder fuerte, porque cada follower compacta su log sin intervención del líder; los autores lo justifican señalando que, al compactar, el consenso ya fue alcanzado (sección 7). El flujo queda así: si ya no se puede seguir rebobinando, se envía un snapshot, el otro lo restaura, y después se le aplica el log de la manera habitual. Con eso el follower puede continuar avanzando.
Condiciones para tomar un snapshot
Hay otro aspecto interesante: cada máquina puede decidir cuándo toma snapshots, en cualquier momento. En función de los que tenga, gestiona unilateralmente qué longitud desea para su log. Pero con una condición: los datos deben estar comiteados y aplicados.
Las dos mitades de la condición se justifican de manera distinta. Lo que se elimina debe estar aplicado para que el snapshot tenga sentido: si una entrada todavía no se aplicó, el snapshot no la contiene, y eliminarla equivaldría a perderla. Y debe estar comiteado, porque si elimináramos entradas no comiteadas nos quedaríamos con el snapshot y nunca podríamos comitearlas. Debería resultar evidente, pero es fundamental y vale la pena enunciarlo por separado: las entradas que ya están comiteadas se pueden eliminar en cualquier momento, y cada máquina gestiona cuándo lo hace.
Evidentemente la operación va a ser costosa, porque la base de datos de la capa superior puede ser muy grande. Cada implementación tendrá que optimizarla según sus posibilidades: tomar cada vez un snapshot completo, o desarrollar alguna forma de snapshot incremental que se construya sobre el anterior guardando la diferencia. El paper no impone ninguna, pero sí discute alternativas (sección 7): menciona enfoques incrementales como log cleaning y LSM trees, sugiere tomar el snapshot cuando el log alcanza un tamaño fijo en bytes, y propone técnicas de copy-on-write —por ejemplo, fork en Linux— para escribir el snapshot sin frenar la operación normal.
Lo que el paper sí especifica es que cada servidor toma sus snapshots por su cuenta, independientemente de los demás, y siempre sobre las entradas comiteadas de su propio log. Y de allí se desprende que, como cualquiera puede transformarse en líder, cualquiera debe haber guardado un snapshot antes de compactar. Allí se comprende cuál era el propósito de todo el mecanismo: una razón es restaurarse si se reinicia; la otra es poder transferirlo a una máquina atrasada, porque si no hubiéramos tomado el snapshot se habría perdido información. No es sencillo de comprender, y va a ser difícil de implementar.
Queda para el final una duda que conviene atender porque es donde surge la desconfianza. Si hay una elección de líder con un log ya eliminado, ¿no se puede llegar a un estado inconsistente? La respuesta está en la condición: siempre que elimina entradas del log, elimina entradas comiteadas, y si están comiteadas ya habrá otros nodos que las tengan. Nunca va a eliminar entradas parcialmente comiteadas.
La objeción insiste, y con razón: ¿y si elimina algo comiteado, que estaba en mayoría, y después en la elección eso ya no constituye mayoría porque se eliminó? No es posible. El nodo sabe con certeza que está comiteado y que estuvo en una mayoría, y en eso no puede equivocarse. Si eliminó entradas y aparece un nodo atrasado que no tenía esos valores, le envía el snapshot y le actualiza lo que corresponda.
Y allí queda a la vista la razón última de la condición: no puede eliminar entradas no comiteadas porque no tiene ninguna garantía de que exista algún otro nodo que las conserve. Imaginemos que toma el snapshot de todos modos, elimina entradas que no estaban comiteadas, y después cae, y resulta que esa era la única máquina que las tenía. Allí sí se puede perder información.