4. Gossip y membresía
En esta sección
Membresía del anillo
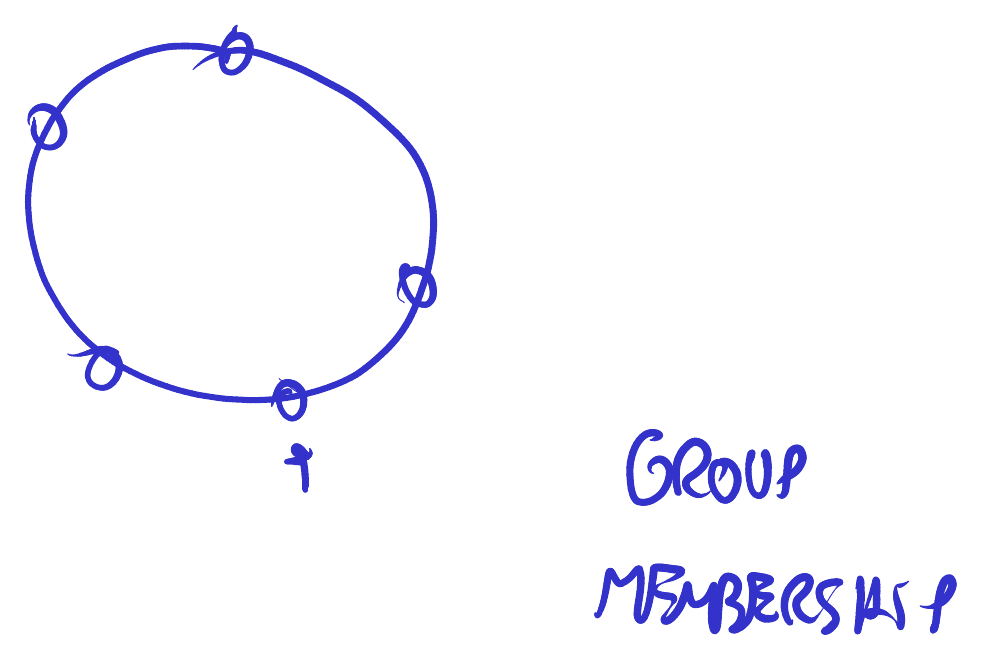
El último tema del paper es uno de los más interesantes, aunque hoy no se use tanto: el gossip. Resuelve algo que veníamos esquivando. Siempre hablamos del anillo con sus virtual nodes, y de cómo se lo recorre para encontrar las réplicas de una clave; pero hasta ahora no explicamos cómo hace cada nodo para conocer a los demás, ni para saber qué posición ocupa cada uno en el anillo.
Y ahí está la clave, porque el mecanismo asume exactamente eso: que todos los nodos conocen el anillo completo y dónde está cada uno. En base a eso les mandan las escrituras a los vecinos y saben cuál es la preference list de cada clave. Todo Dynamo descansa sobre ese supuesto, que nunca justificamos. El problema tiene nombre propio: group membership, averiguar quiénes son los miembros del grupo.
Alternativa 1: servicio de configuración
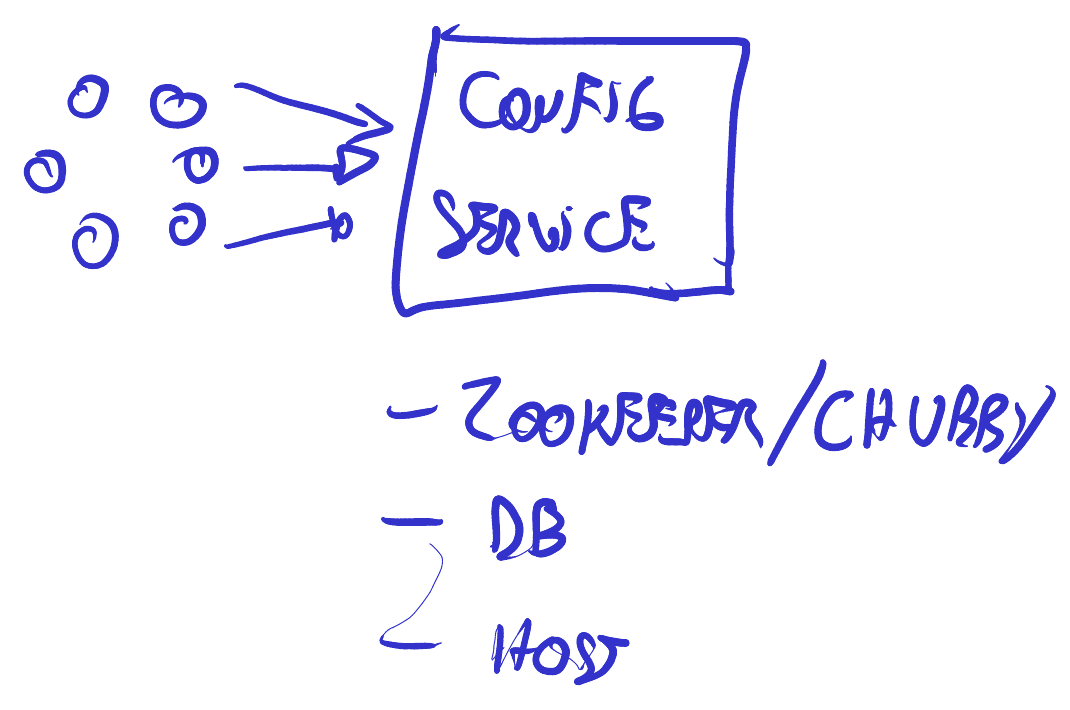
La primera alternativa ya la vimos un par de veces en la materia: aparte del anillo, un servicio de configuración, un config service. Todos le mandan sus datos y todos lo consultan. El tráfico va en las dos direcciones, y por eso alcanza con un solo lugar: cada nodo publica ahí lo que sabe de sí mismo y lee lo que necesita de los demás.
¿Qué podría ser ese config service? ZooKeeper, que ya conocemos. En algunos casos, una base de datos tradicional. O inclusive un host común, una máquina con un disco rígido. Los dos últimos tienen problemas. Si se rompe ese host se pierde la información de los miles de nodos, así que no conviene. La base de datos mejora un poco, aunque no tanto: si fuera DynamoDB tendríamos un problema del huevo y la gallina, y si fuera relacional seguiría siendo un punto de falla.
ZooKeeper sería la mejor de las tres. O, si fuéramos Google, Chubby, el otro paper que no vimos, que resolvía cosas similares. El orden histórico es el inverso del que uno supondría por la fama: Chubby es de 2006 y ZooKeeper de 2008, así que ZooKeeper es la versión abierta de Chubby, y no al revés. Ninguno de los dos está pensado para soportar una base de datos entera, pero los dos soportan perfectamente esta clase de información de configuración, con alta disponibilidad. Así cada nodo averiguaría su lugar en el anillo y quedaría resuelto el group membership.
Alternativa 2: gossip
Hay otra forma, más elegante y fácil de entender: la versión completamente distribuida, donde los nodos se comunican entre sí sin ningún servicio intermedio.
En su versión básica, los servidores se reportan a todos los compañeros. Eso exige saber dónde están los compañeros, pero dejémoslo de lado un segundo: el mecanismo sería parecido a un heartbeat. Una vez que todos se conocen, se reportan entre sí y así se detectan las fallas.
A partir de eso se puede hacer algo más interesante. En vez de decir “sigo vivo, estoy aquí”, decir “sigo vivo, y esta es mi visión de todo el mundo”. Todos se van pasando colaborativamente, como un rumor, el estado global de las cosas. De ahí el nombre del algoritmo.
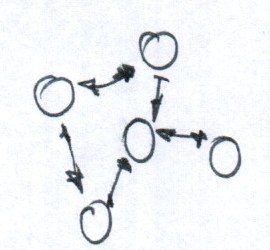
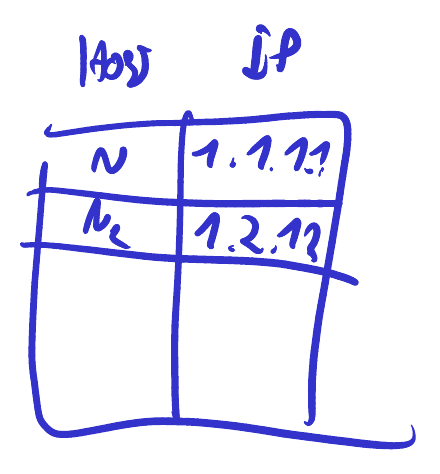
¿Qué sería concretamente ese estado global? Por ejemplo, el host y su IP: una fila por nodo con su nombre y su dirección. Esa tabla no existe en ninguna base centralizada: cada nodo tiene su propia copia, tan al día como se lo permitió el último intercambio, y todos se la pasan hasta que todos la conocen.
El algoritmo tiene tres pasos y se ejecuta cada T segundos. Primero, elegir un peer al azar entre los que uno conoce —y con conocer a uno solo, eventualmente funciona—. Segundo, intercambiar estado con ese peer. Tercero, y aquí está la clave: el peer no manda solo su propio estado, sino todo lo que conoce del clúster, y eso hay que combinarlo (merge) con lo propio: merge(estado_del_peer, estado_propio). El merge depende de qué sea el estado; si es una tabla, simplemente se concatenan los valores. Y eso se repite constantemente.
Lo importante es esto último: la información que me mandó mi peer, cuando yo se la mande a otro, viaja junto con la mía.
Propagación epidémica
Hay dos maneras de ver por qué funciona. Una es el rumor que se propaga de boca en boca, de donde sale el nombre (gossip significa chisme). La otra, más precisa, es que el algoritmo se inspira en cómo se propagan las epidemias, y es la que nos va a dar el número.
Yo tengo un dato y se lo mando a uno cualquiera. Ese se lo manda a otro, y ese a otro más. Después todos se lo mandan a todos, y a alguno le llega por dos lugares distintos. En muy poco tiempo, todos se enteraron. Es el mismo comportamiento que una epidemia, pero con información en lugar de un virus. Yo se lo mando a uno, después nosotros dos se lo mandamos a cuatro, y así crece exponencialmente.
Durante la pandemia de COVID se habló mucho de crecimiento “exponencial” en los medios; para quien estudió análisis matemático, el concepto es familiar. Es exactamente la misma idea, usada para propagar información en las redes. Los routers de internet también se pasan la información así: BGP, el protocolo de ruteo entre los sistemas autónomos de internet, funciona como una especie de gossip distribuido. Cada sistema autónomo les anuncia a sus vecinos las rutas que conoce, esos las reanuncian a los suyos, y una ruta nueva termina difundiéndose por internet entera sin que nadie tenga la tabla completa de antemano. La diferencia con Dynamo es que las sesiones de BGP no se eligen al azar: cada uno habla siempre con los vecinos que tiene configurados. No vamos a desarrollarlo porque excede el alcance de la clase, pero la idea de fondo es esa.
El protocolo es BGP, Border Gateway Protocol, especificado en el RFC 4271.
Falta la parte cuantitativa, que es la que convence. El paper original —de 1987— demostró que la convergencia es de orden logarítmico en n, la cantidad de nodos. El logaritmo es en base dos, aunque la base no importa demasiado. Ese orden mide la cantidad de rondas de intercambio: uno le manda a uno, y esa es una ronda; esos dos les mandan a otros dos, y esa es otra. Con 1024 nodos, alcanzan solamente 10 rondas para que el sistema se estabilice y todos conozcan todo. El 10 no es una estimación: es exactamente el logaritmo en base dos de 1024, porque 2¹⁰ es 1024. Y si T es un segundo —el paper de Dynamo usa un segundo—, 1024 nodos conocen el estado del clúster entero en 10 segundos. Lo fuerte es la forma de la curva: duplicar el clúster no duplica el tiempo, le agrega una ronda. Con 2048 nodos son 11 segundos, y para llegar a 20 segundos haría falta un millón de nodos.
Push, pull y push-pull
El paso de intercambiar estado con el peer admite variantes. Con un nodo A y su peer, una forma es push: A le envía sus datos al otro sin que este los haya pedido. Otra es pull: A le pide al peer y el peer le manda su estado. Y lo típico es intercambiar: A manda su estado y el peer responde con el suyo. Es más rápido, porque en una sola ida y vuelta los dos ya intercambiaron toda su información.
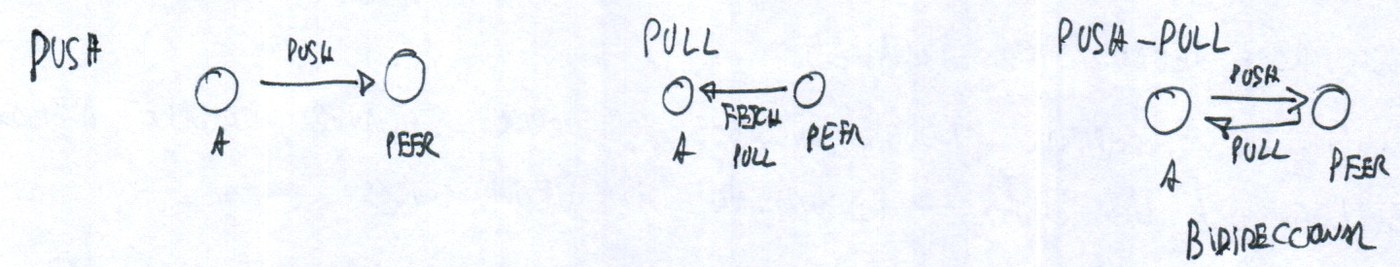
Gossip es un algoritmo interesante y fácil de entender, y no vamos a profundizar más.
Gossip en Dynamo e incorporación de nodos
En Dynamo, concretamente, se gossipean los miembros del clúster y los tokens de cada uno en el anillo; el paper a veces les dice tokens y a veces virtual nodes, pero son lo mismo. Es información que cambia poco: no se agregan y sacan nodos miles de veces por segundo, sino que el conjunto se mantiene estable por largos períodos y de vez en cuando alguno falla.
Hay un detalle interesante que corona todo lo que vimos hoy. Si aparece un nodo nuevo, habrá un momento de transición en el que algunos nodos ya lo conocen y otros todavía no. ¿Se rompe el sistema si, dentro de una misma preference list, unos nodos piensan que ese nodo tiene que estar y otros no lo saben?
No, y justamente ahí funciona todo lo anterior. El tiempo de propagación lo absorben los mecanismos que acabamos de ver: un nodo nuevo conocido parcialmente es como una falla temporal, del tipo que ya sabemos tratar. Cuando el gossip termina de propagarse, el hinted handoff y los Merkle trees hacen que todo se restaure y el sistema vuelva a un estado consistente.
Dynamo en la actualidad
De todo esto quedan sistemas concretos que se pueden ir a mirar, porque varias empresas importantes tomaron el paper de Dynamo de 2007 y lo implementaron: LinkedIn, Facebook y otras. La de Facebook es casi seguro la más famosa: Cassandra. Tomó el modelo del anillo y del consistent hashing de Dynamo y lo combinó con el modelo de datos de otro paper de Google, BigTable. Riak era otro, todavía más fiel a Dynamo que Cassandra.
Todo esto se sigue usando. Cassandra, por lo que se sabe, sigue usando gossip para que los nodos se comuniquen entre sí.