1. Restricción de elección
En esta sección
La pregunta que quedó abierta en la clase anterior reaparece en la segunda parte del trabajo práctico: cuando un candidato solicita el voto, ¿en qué casos se lo otorgan y en qué casos no? La regla se enuncia en dos líneas, pero enunciada así no permite entender por qué debe ser esa y no otra. Vamos a recorrer el camino inverso: construir un sistema que funcione y después someterlo a fallas. Los ejemplos con los que lo quebramos funcionan como un catálogo de lo que puede ocurrir cuando se eligen líderes nuevos.
Partición de red y split brain aparente
Hay dos restricciones al voto, una evidente y una sutil. La evidente ya apareció la clase anterior: si el nodo que recibe el pedido ya votó por alguien en ese término, no vota dos veces.
La sutil es la que nos ocupa. Para responderle a un candidato que lo acepta como nuevo líder, el candidato tiene que demostrarle al votante que su log está más actualizado que el del votante: no se puede votar a alguien desactualizado. Qué significa exactamente “más actualizado” lo vamos a definir con precisión más adelante; por ahora alcanza con la noción intuitiva, porque lo primero que hay que construir es la intuición de por qué la restricción debe existir.
Empecemos con el ejemplo habitual de cinco nodos, con el que se visualiza casi todo con claridad. Afuera hay un cliente que le envía un request al líder, un put, por ejemplo. Ese request lo representamos con una marca verde dibujada dentro del nodo, y significa algo preciso: que el nodo pudo guardar el request en su log, de manera fija y persistente.
El líder les envía esa entrada a dos vecinos con un AppendEntries. Los dos la agregan a su log y responden afirmativamente. Con esas dos respuestas el líder comitea la entrada, y recién entonces le responde OK al cliente. Ese OK significa que la entrada está comiteada, es decir, que está por lo menos en una mayoría de nodos.
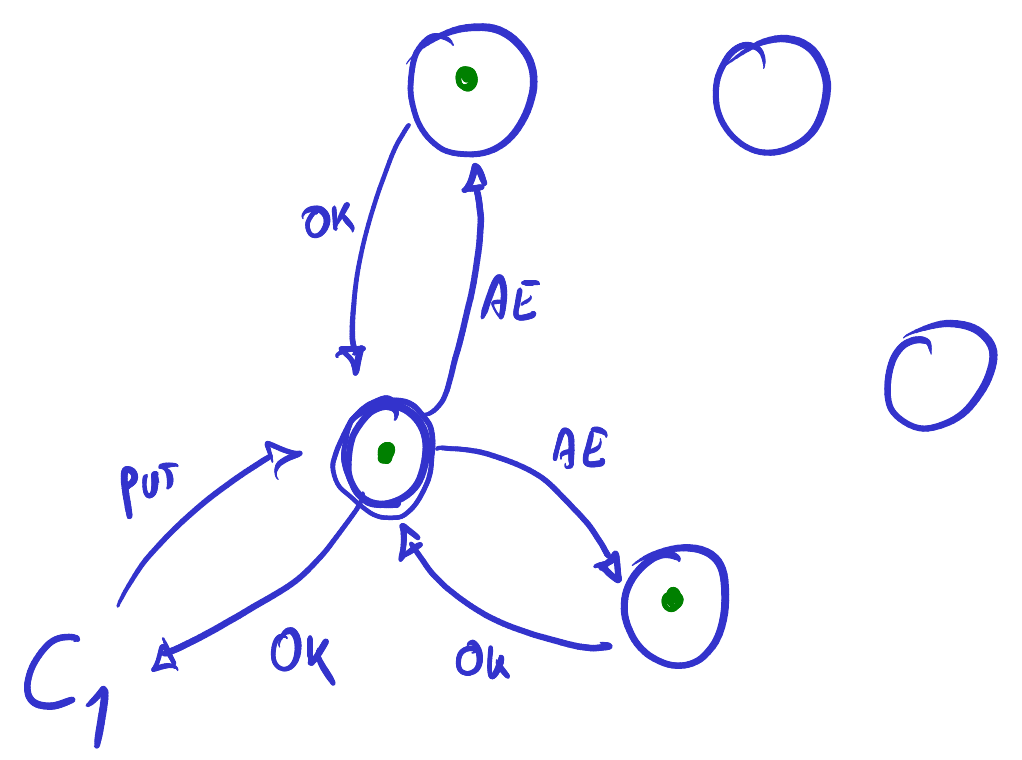
El detalle de que el líder le haya enviado la entrada a dos vecinos y no a los cuatro es deliberado: si se la envía a todos, no queda nada para analizar. Supongamos que iba a enviársela a los otros dos, pero que algo va a ocurrir antes.
Fijemos el estado antes de introducir la falla. El líder está actualizado y dos de sus vecinos también, al menos en el log. Y ocurrió algo más cuando el líder respondió: además de contestarle al cliente, envió la entrada a la capa de aplicación. Si sobre Raft hay una base de datos, esa escritura ya se aplicó allí. Ese detalle va a ser relevante enseguida.
La primera falla que introducimos es una partición de red, de manera tal que el líder queda de un lado con un solo vecino y los otros tres quedan del otro lado.
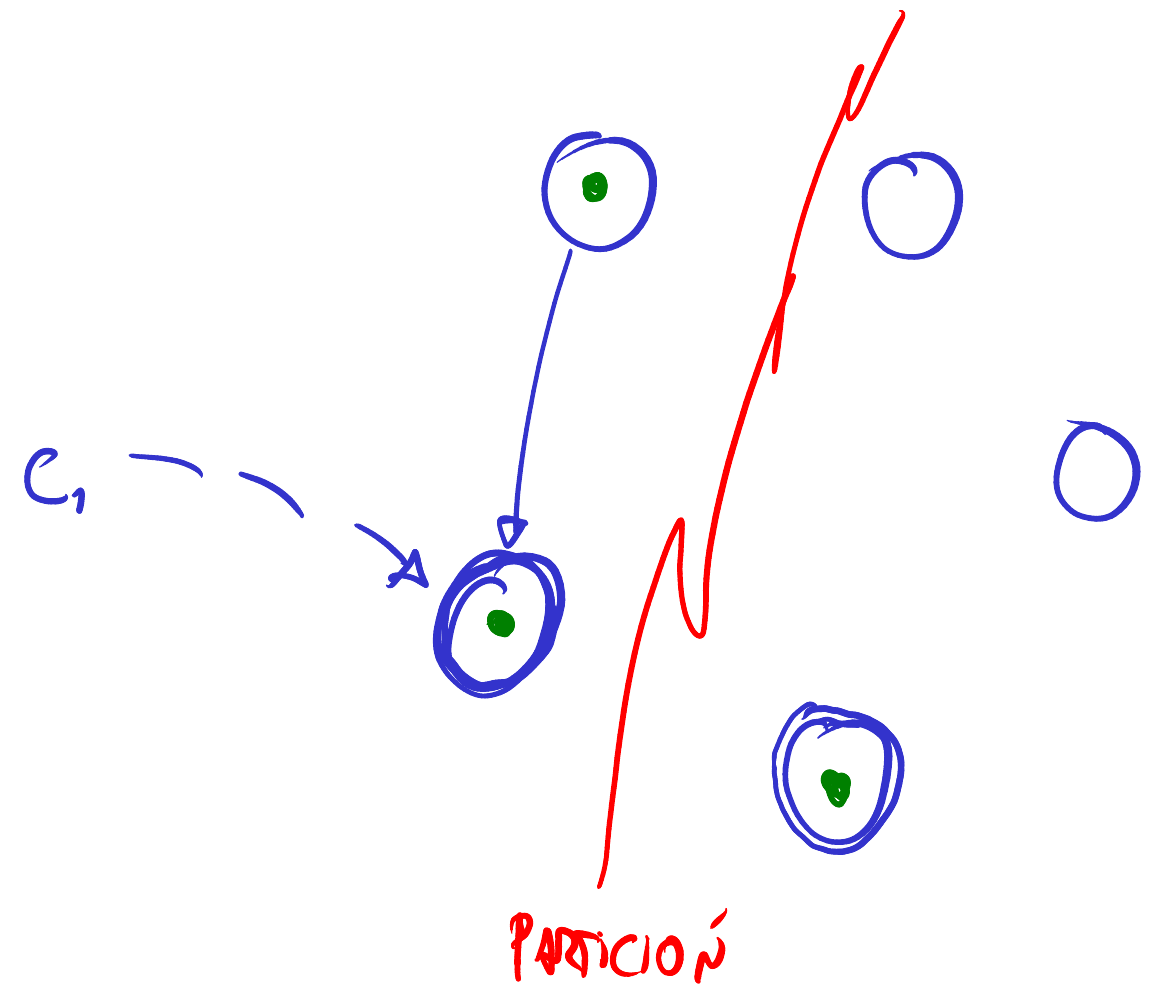
Lo primero que hay que revisar es si estamos protegidos del split brain, es decir, de que surjan dos sistemas funcionando en paralelo. Y para verlo hay que ser riguroso respecto de lo que un nodo puede llegar a saber: la partición se produce rápidamente y no sabemos detectarla adecuadamente en tiempo real. No hay un instante en el que alguien anuncie que se cortó la red; simplemente dejan de llegar mensajes.
Del lado menor puede seguir habiendo clientes que le envían pedidos al líder, y ese líder va a seguir considerándose líder mientras la partición dure. Un líder abdica cuando le llega un mensaje con un término más nuevo que el suyo —lo vemos en un momento—, pero de ese lado no le llega ninguno. Sin nadie que lo contradiga, se sigue creyendo líder indefinidamente, y como se cree líder sigue trabajando: le llega otro request, lo escribe en su log, se lo envía al vecino que le quedó del mismo lado, y el vecino le responde afirmativamente. Vista desde adentro, esa mitad siguió funcionando en apariencia.
La otra mitad, mientras tanto, dejó de recibir heartbeats. Los tres nodos van a iniciar una nueva elección, y como son mayoría —tres de cinco— van a elegir a alguno de ellos y va a aparecer un líder nuevo. El líder anterior no llega a enterarse de que dejó de serlo.
La clave del escenario es que el líder anterior nunca va a obtener una mayoría de respuestas, porque de su lado tiene un solo par. Su log va a seguir avanzando, y el de ese par también, pero las entradas nunca van a ser comiteadas, y como nunca se comitean tampoco se le responde OK al cliente. Lo que el cliente observa son timeouts o errores: envía un request, el líder se lo transmite a uno, intenta transmitírselo a los otros tres, no lo consigue, reintenta un par de veces, y el cliente termina desistiendo o recibiendo un error. El cliente no recibe confirmación, y eso es lo importante de retener.
Por eso, si bien parecería que hay split brain —dos líderes a la vez—, lo que tenemos es un split brain parcial: hay un líder, sí, pero no puede hacer avanzar la aplicación que tiene por encima. Su log puede avanzar considerablemente, pero nada de eso llega a la capa de aplicación. Y después, si la partición se resuelve y las dos mitades se vuelven a unir, vamos a tener que reparar ese log.
En síntesis: la mitad menor no puede avanzar porque su líder nunca va a recibir una mayoría cuando intente hacerle AppendEntries a los vecinos. Lo interesante es lo que ocurre del otro lado.
Elección en la partición mayoritaria
La mitad mayor va a intentar elegir un líder. Alguno de esos tres va a tener un election timeout que expira primero —son randomizados, y por eso siempre hay uno que llega antes—, y ese nodo inicia la elección.
Antes hace falta una propiedad importante de todo Raft, porque sin ella los casos no se distinguen entre sí. Quien es elegido líder, apenas el sistema se estabiliza, les envía su log a los otros nodos. Lo que tenga el líder es el log, por definición: no hay negociación ni fusión de versiones, el log del líder se copia hacia abajo.
Con eso pueden ocurrir dos cosas. Imaginemos primero que el candidato es uno de los dos nodos que no tienen la marca verde. Le envía un RequestVote a uno de sus compañeros y este responde afirmativamente; al otro, lo mismo. Con esos dos votos se transforma en líder, y al sincronizar su log con el nodo que tenía la marca verde le elimina esa entrada.
Y ese resultado sería muy grave. Esa entrada ya estaba en una mayoría de nodos, con lo cual ya se le había respondido OK a un cliente, y probablemente hasta estaba aplicada en la capa de aplicación. Es un resultado desastroso: no se trata de que el sistema quede atrasado, sino de que perdió algo que ya había prometido hacia afuera.
La conclusión es inmediata: ese nodo no puede ser líder porque está desactualizado, porque tiene información vieja. Allí está, en una línea, la razón de ser de la restricción de elección.
La situación simétrica muestra cómo el algoritmo evita el desastre. El nodo desactualizado se transforma en candidato y solicita votos. Le pide el voto a uno de los suyos, que también está desactualizado, y este responde afirmativamente. Le pide el voto al que tiene la marca verde, y ese lo rechaza: al recibir el RequestVote advierte que el log del candidato está más desactualizado que el suyo. Con el voto propio y el del otro desactualizado llega a dos, y no le alcanza. Ese término queda vacante: no hubo elección, no resultó electo nadie, y hay que esperar un nuevo timeout.
Hay un detalle que queda oculto: qué hace un líder anterior si alguien le pide el voto. En esta mitad no hay ningún líder —eran tres followers y uno se transformó en candidato—, pero si un candidato nuevo alcanzara a enviarle un RequestVote al líder anterior, este dejaría de ser líder y le entregaría el voto.
La razón está en los términos. Supongamos que todo el sistema estaba en el término siete y que los cinco nodos lo sabían. Cuando la red se corta, el candidato, al convertirse en candidato, incrementa el término: pasa al ocho. Y una regla general de Raft, que ordena muchas otras cosas, es que si a un nodo le envían un mensaje con un término más nuevo que el suyo, debe asumir que ahora estamos en ese término. Si al líder anterior le llega un mensaje del término ocho, tiene que dejar de ser líder, y después responder afirmativa o negativamente según el estado de su log.
De esa regla se desprende una advertencia de ingeniería. El sistema es sensible a que los tiempos estén bien elegidos: con un election timeout demasiado corto van a aparecer candidatos permanentemente, interfiriendo con el trabajo del líder. Y si una máquina quiere provocar fallas deliberadamente, el procedimiento es sencillo: incrementar el término cada tanto y enviarles RequestVote a los demás; con eso alcanza para destituir al líder una y otra vez y dejar al sistema ocupado en elegir en lugar de trabajar. Conviene aclarar que Raft asume fallas no bizantinas, así que no está diseñado para defenderse de nodos maliciosos. El paper sí trata un caso parecido y no malicioso en la sección 6: los servidores removidos del cluster pueden interrumpir al líder de esta forma, y el paper lo mitiga haciendo que un servidor ignore los RequestVote si escuchó a un líder vigente hace menos que el election timeout mínimo.
Volvamos a la partición, con el término ocho vacante. Lo que sigue es el caso previsible, el que hace que el sistema se recupere: en algún momento el nodo que tiene la marca verde va a ser el primero al que se le expire el timeout. Conviene insistir en que esto es aleatorio: en teoría esta mitad podría quedar indefinidamente sin líder por una cuestión de probabilidades. Eventualmente el nodo actualizado va a intentarlo y va a ganar.
Al postularse pasa al término nueve, y no al ocho, porque cuando el candidato anterior le envió su RequestVote ese mensaje le informó que estábamos en el ocho: respondió negativamente, pero actualizó su término interno. Esto es exactamente lo que muestra el gráfico del paper donde hay términos en los que no aparece ningún líder y que consisten solamente en una etapa de elección.
El resto del proceso es ordenado. El candidato les envía RequestVote a los otros dos e informa el estado de su log; los dos responden afirmativamente porque está actualizado. Se convierte en líder, y al ser el líder quien tiene la información actualizada, esa marca verde eventualmente se propaga a los otros dos.
La dirección de la asimetría es fácil de confundir mirando el diagrama. El nodo que tiene la marca verde nunca vota a favor del candidato desactualizado: siempre lo rechaza. Es al revés: son los desactualizados los que votan a favor del actualizado.
Y ahora el punto conceptual. La entrada marcada en verde ya estaba comiteada, ya estaba en una mayoría desde antes de la partición. Cualquiera fuera el desenlace posterior, lo que tenía que ocurrir para que el sistema siguiera funcionando es exactamente lo que ocurrió: que en la mitad que se restauró la entrada apareciera en todos los nodos. Si ya estaba comiteada antes, sigue comiteada ahora.
Podría pensarse que fue una casualidad afortunada que en la mitad mayor quedara justo una copia. Pero no es casualidad: es esa condición matemática de la que hablábamos la clase anterior. La condición para comitear es que responda una mayoría, y sobre las mayorías dijimos que cualquier partición, sea cual fuere el corte, deja una sola mitad con mayoría, y que esa mitad va a tener por lo menos un nodo actualizado si la entrada se escribió en mayoría. No es un accidente afortunado: está garantizado.
Y el contrafáctico cierra el argumento. Si no se hubiera llegado al commit —si el líder le hubiera enviado la entrada a un solo vecino y en ese momento se hubiera particionado la red—, esa mitad se perdía y la entrada desaparecía. Pero en ese caso tampoco se le había podido responder al cliente. El sistema no pierde nada que haya prometido.
Entradas no comiteadas
Agreguemos otro escenario, interesante por razones distintas. El mismo cluster de cinco. El líder anterior recibe un request del cliente, lo escribe localmente y alcanza a escribirlo en un solo servidor más. Y ahora se produce otro tipo de falla: en lugar de particionarse la red, el líder cae, lo cual equivale a una partición con el líder solo de un lado y todos los demás del otro.
Los cuatro nodos que quedan dejan de recibir heartbeats y van a iniciar una elección entre ellos. Y aquí la situación es distinta de la anterior, que es lo que vuelve interesante al caso: la marca verde está en un solo nodo, esa entrada nunca fue escrita en una mayoría. Si estuviera en dos, sería la historia del escenario anterior.
Numeremos los nodos: S2, S3, S4 y S5 son los cuatro que siguen en funcionamiento, y S2 es el que tiene la marca verde.
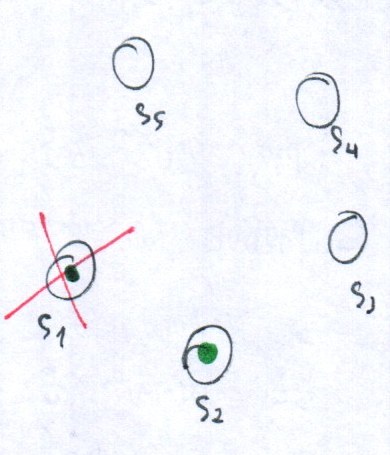
Un caso posible es que S2, el más actualizado, sea el que intente ser candidato. Conviene insistir: es aleatorio, cualquiera de esos cuatro puede hacerlo. Si es S2, les envía RequestVote a todos y todos votan a favor, porque su log está más actualizado que el de los demás. S2 se convierte en el nuevo líder y eventualmente les envía esa entrada a todos.
Y aquí está la observación importante, fácil de pasar por alto: esa entrada no estaba comiteada, nunca lo estuvo. Y sin embargo S2 tiene pleno derecho a ser líder, y cuando lo es se la envía a todos. Que la entrada termine en el log de todos y comiteada es consecuencia directa de haberlo elegido a él. Eso nos dice algo relevante sobre Raft: una entrada que no estaba comiteada puede terminar comiteada por el solo hecho de que el nodo que la tenía ganó la elección, sin que ningún otro haya opinado sobre ella.
El mecanismo por el que llega a comitearse no es el que uno supondría. El líder nuevo no la declara comiteada por haberla replicado en una mayoría: Raft cuenta réplicas para decidir el commit únicamente sobre las entradas de su propio término. Las que hereda de términos anteriores quedan comiteadas de manera indirecta, cuando el líder logra comitear alguna entrada propia y, por la propiedad de coincidencia de logs de la sección siguiente, todo lo anterior queda comiteado junto con ella. El destino de la entrada verde es el que describimos, pero el momento exacto es cuando el nuevo líder comitea algo propio.
¿Y por qué eso no compromete la correctitud del sistema? Hay que analizarlo desde la experiencia del cliente. El cliente envió el request y nunca recibió respuesta, porque la entrada no fue comiteada en ningún lado, así que no sabe si se comiteó o no. A lo sumo va a reintentar, y quizás aparezca un duplicado. Pero como no se le confirmó ni que estaba ni que no estaba, el sistema queda en libertad de decidir.
Y lo que decidieron los autores de Raft es precisamente eso: que ese líder puede determinar por sí solo que su log es el log. Lo grave sería que eliminara entradas ya comiteadas; aquí no elimina nada comiteado, agrega entradas que no lo estaban.
Ese es el primer caso, y el más llamativo de los dos: muestra bien las situaciones inesperadas que pueden llegar a producirse.
El caso sencillo es que el candidato sea, por ejemplo, S3. Les envía RequestVote a todos. S2 lo rechaza, porque S3 no está más actualizado que él, pero S4 y S5 votan a favor, y con esos dos votos se transforma en el nuevo líder. Tres de los cuatro ya están sincronizados entre sí, así que con ellos no hay nada que hacer; con el restante sí: el nuevo líder le va a eliminar esa entrada a S2.
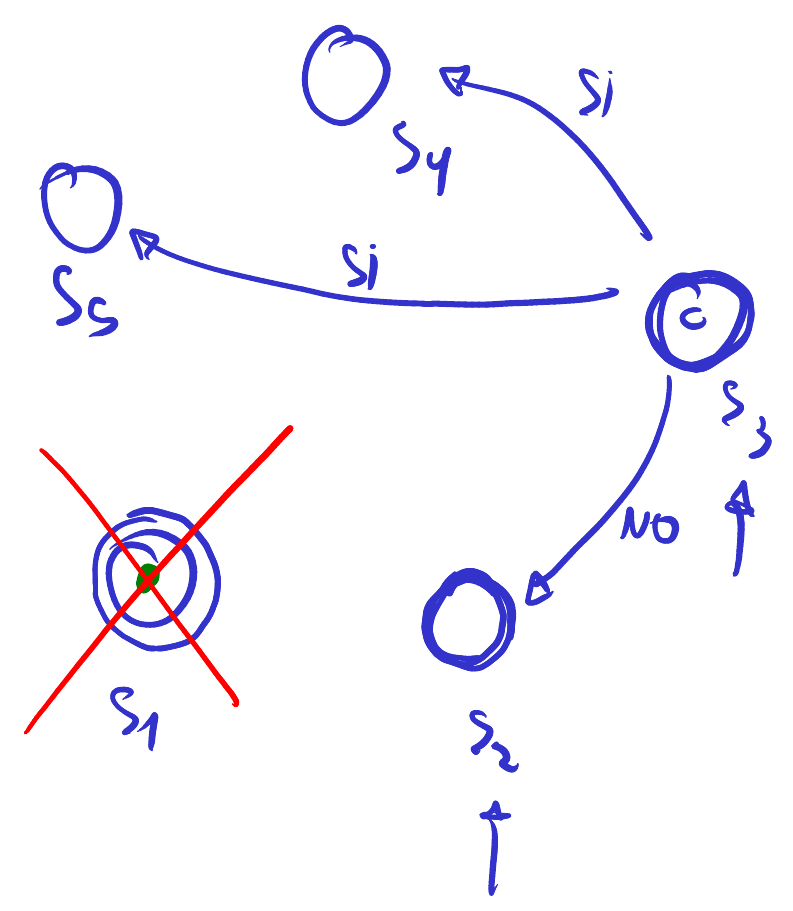
¿Y por qué está habilitado a eliminarla? Por la misma razón que antes: el cliente la había enviado y no había recibido ninguna respuesta. Puede que se haya comiteado o puede que no, y el cliente no lo sabe.
Y allí está el punto más incómodo de los dos escenarios: depende de cuál timeout ocurre primero. Si se elige primero a S2, la entrada termina comiteada y propagada a los cinco; si se elige primero a S3, termina eliminada. Es un resultado prácticamente no determinista. Pero desde el punto de vista del cliente no le estamos violando ninguna restricción que le hayamos comunicado, porque no le comunicamos nada.
Resulta contraintuitivo por dos motivos a la vez: que puedan ocurrir las dos cosas según a quién se elija, y que un líder nuevo pueda imponerles a los demás entradas que ellos no tienen y que terminen comiteadas. Y sin embargo es exactamente lo que el algoritmo permite, y no se produce ninguna inconsistencia.