6. DynamoDB: modelo de datos y arquitectura
En esta sección
Relación entre Dynamo y DynamoDB
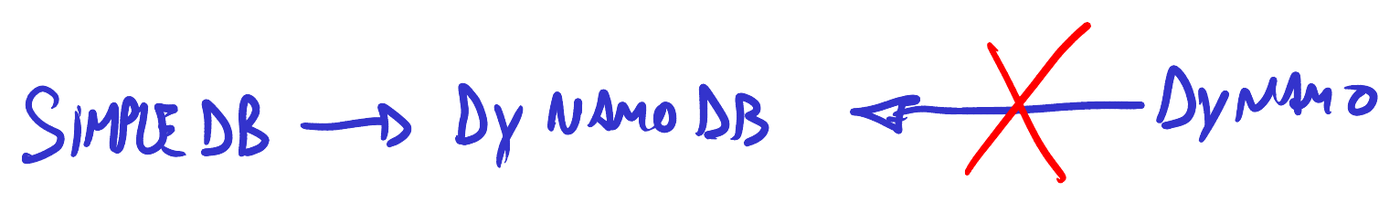
La historia explica buena parte de lo que sigue. Las bases no relacionales se habían puesto de moda, y Amazon quiso hacer una en la nube. No fue la primera: DynamoDB surge de SimpleDB, un sistema que ya no existe. Y ese es el punto importante, antes que ningún otro: DynamoDB no desciende de Dynamo.
¿Por qué se llama así, entonces? Por marketing. El paper de Dynamo tuvo enorme repercusión en 2007: se lo discutía en blogs y en Twitter, junto con los de MapReduce y Google File System; eran los tres papers de moda. Capitalizando esa publicidad, a la siguiente versión de SimpleDB la llamaron DynamoDB, para vender más. Eso es todo lo que hay detrás del nombre.
Cuando veamos la arquitectura vamos a comprobar que no tiene prácticamente nada que ver con la que estudiamos. Conserva la idea general de Dynamo, y nada más; conviene no confundirlos.
La primera diferencia está en la abstracción que se ofrece. Dynamo no tenía tablas: era simplemente un key-value store. DynamoDB incorpora la tabla, la que cualquiera conoce, con sus columnas. Lo importante es que tiene una clave, y esa clave determina cómo se shardea todo.
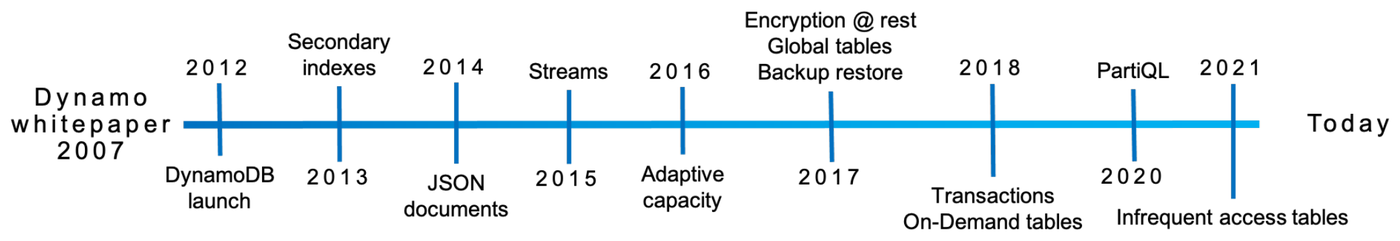
La figura 1 del paper muestra la evolución del servicio: se parte del paper de Dynamo, varios años después sale DynamoDB, y con el tiempo se le incorporan nuevas funcionalidades. De todas ellas vamos a estudiar una en particular: las transacciones. Primero veremos cómo las implementa DynamoDB, y después, en la última clase de bases de datos distribuidas, cómo las implementa Spanner. Son dos formas completamente diferentes.
Vamos al modelo de datos. Las tablas tienen items, que vendrían a ser las filas, aunque como pueden tener JSON adentro la idea de fila no es del todo buena. Cada item tiene atributos, que serían las columnas y son lo que menos nos interesa, y una primary key. El paper describe dos variantes: una partition key sola, o una partition key con una sort key. La segunda no la vamos a ver en detalle porque excede el alcance de la clase; con la lectura del paper se comprende sin dificultad. Lo interesante es la primera.
La partition key importa porque es la que se usa para shardear, terreno que ya conocemos de sobra: la partition key pasa por una función de hash, y de ahí sale un hash.
Y aquí aparece la diferencia que importa: no hay ningún anillo. Hay un espacio de direcciones del hash de 2¹²⁸ − 1 posiciones, desde el 0 hasta el último valor. Son unas 3,4 × 10³⁸ direcciones, muchas más que las claves que va a tener jamás cualquier tabla, y esa desproporción le permite al sistema partir el espacio donde quiera y con la granularidad que quiera: siempre quedan direcciones libres a los dos lados de cualquier corte. El hash de una clave cae en algún lugar de ese espacio. Dónde empieza y termina cada partición es arbitrario: no es aleatorio, sino que lo elige el sistema según varias consideraciones. Tendería a ser uniforme, aunque no necesariamente: una región muy accedida se puede volver a subdividir. Así el espacio queda partido en las particiones uno, dos, tres, cuatro y cinco.
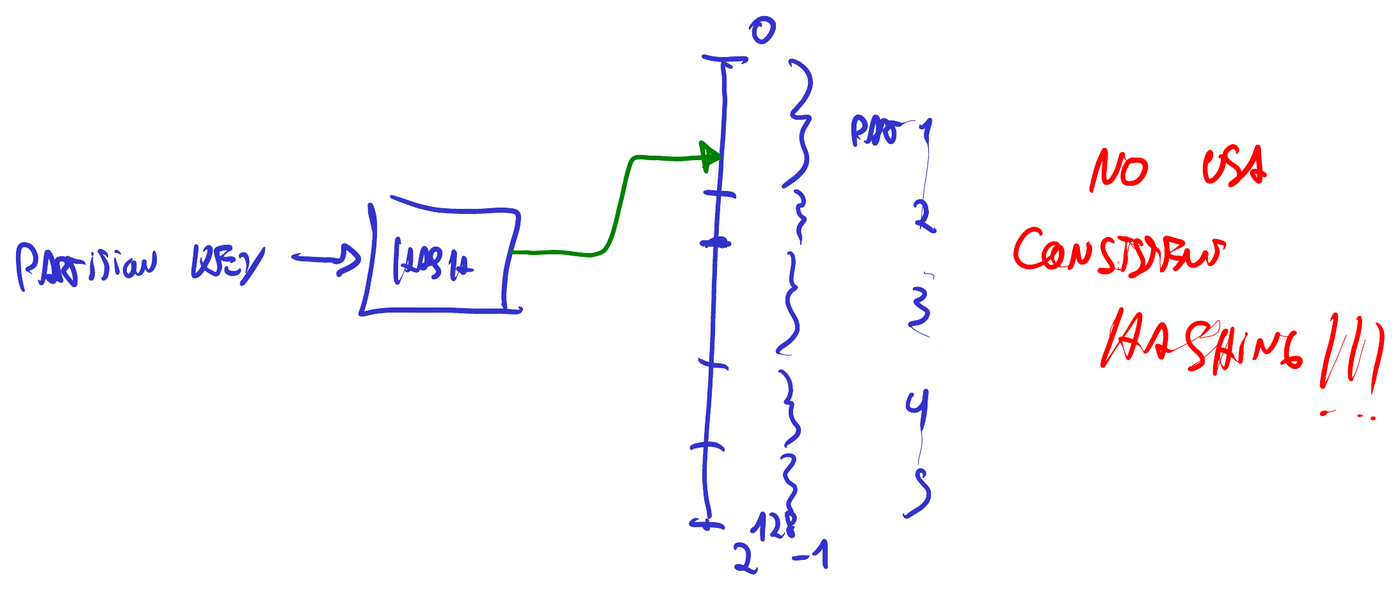
Hasta aquí nada raro. Pero lo importante es que no usa consistent hashing, que era lo fundamental del otro paper. Ni siquiera lo hicieron. Y eso deja una pregunta abierta: si nadie puede calcular con una función conocida por todos dónde cayó cada partición, ¿quién sabe dónde está cada una?
Request router y partition metadata system
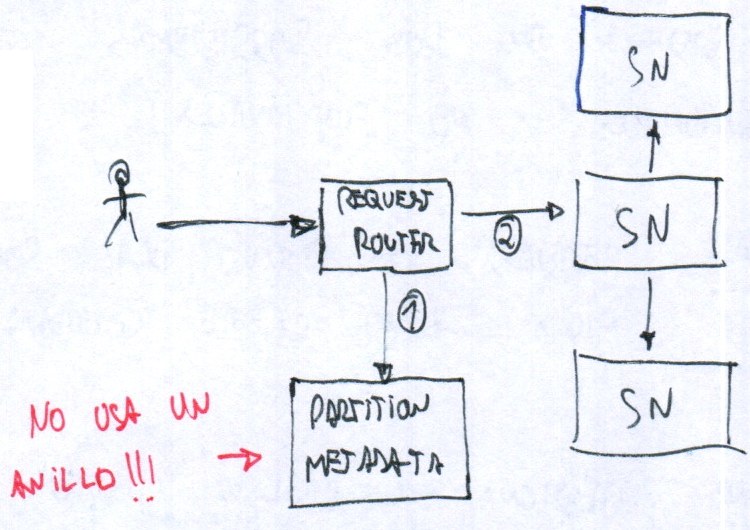
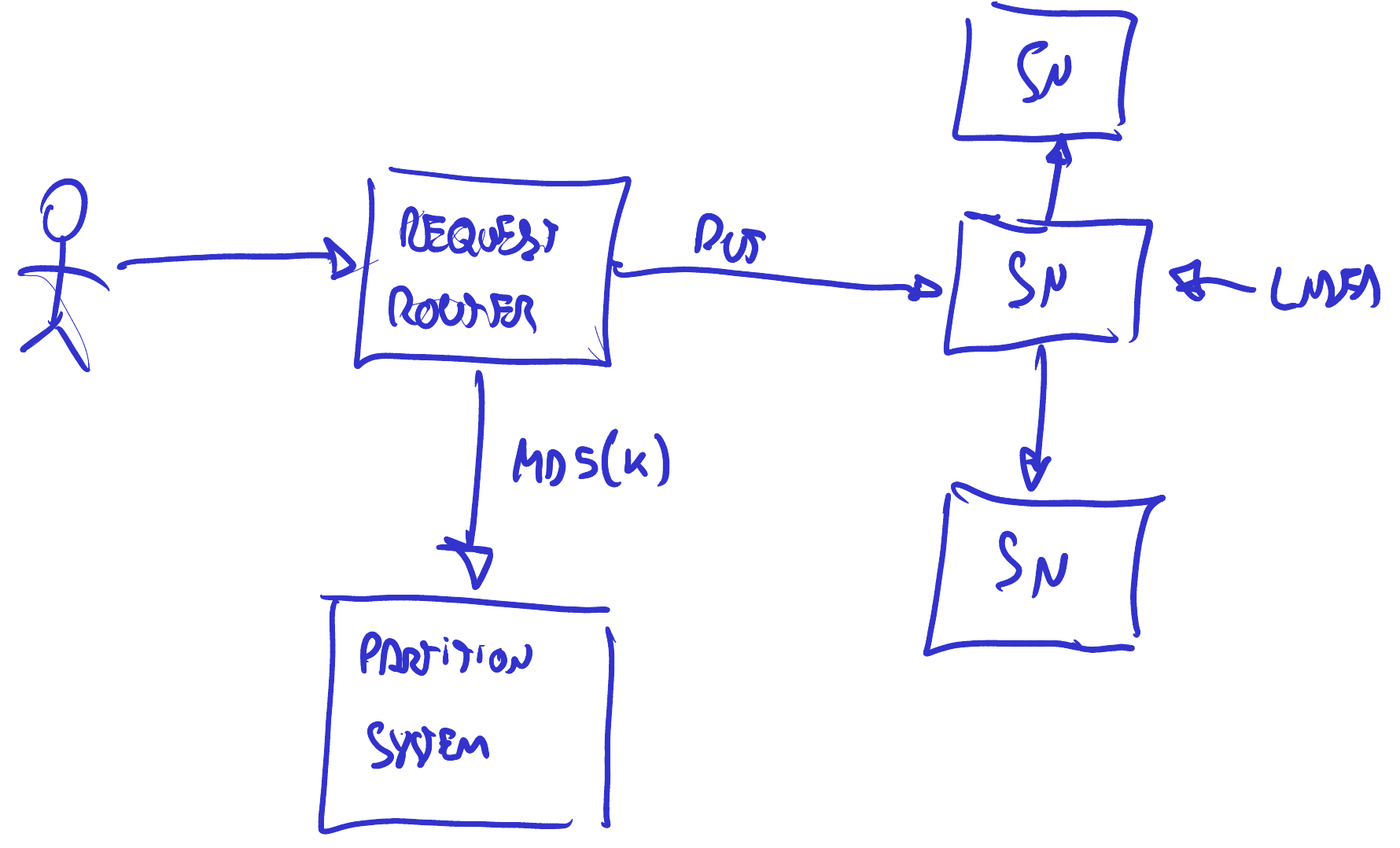
La arquitectura de DynamoDB, en la figura cuatro del paper, responde esa pregunta. Tiene bastantes más componentes que Dynamo, pero para lo que nos interesa se reduce a dos piezas. De un lado están el usuario y la red que lo conecta, que no importan demasiado. Lo primero que encuentra el request al llegar es el request router.
El request router es, básicamente, el servidor web por el que entran todas las peticiones y que después las manda a alguno de los storage nodes. Tiene además dos tareas propias, que no son lo que más nos interesa. Una es autenticar el request: verificar que nadie trate de acceder a la base de datos de otro. La otra es contar cuántos requests por segundo se hacen, que es justamente lo que se le manda al metering que describimos antes.
Lo que sí nos interesa es la otra pieza, el partition metadata system: una base de datos adicional donde vive cómo se reparten las particiones sobre el espacio del hash y en qué nodo está cada una. No es una tabla auxiliar menor, sino una base de datos en sí misma, con una gran tabla adentro. El paper menciona un detalle curioso: la primera versión guardaba esa tabla en DynamoDB, una circularidad incómoda —el sistema que dice dónde está cada cosa, guardado dentro del sistema que uno quiere consultar—. Después la movieron a un sistema aparte, MemDS, un datastore distribuido en memoria: los request routers le consultan a MemDS tanto cuando su caché local falla como cuando acierta, para que la carga sobre el metadata service sea constante y una caché fría no provoque una avalancha. Y dentro de cada nodo de MemDS vive una estructura llamada Perkle, un híbrido entre un Patricia trie y un árbol de Merkle: los mismos árboles de hashes de la sección 3, reaparecidos para otra tarea, la de buscar por prefijo y por rango sobre las claves ordenadas.
MemDS y el Perkle no tienen un paper propio; están descritos en el paper de DynamoDB —Elhemali et al., “Amazon DynamoDB: A Scalable, Predictably Performant, and Fully Managed NoSQL Database Service”, USENIX ATC 2022—, el mismo que la clase toma como fuente. Lo que ese paper efectivamente no detalla es dónde queda almacenada la metadata en última instancia.
Esa gran tabla tiene dos columnas: el rango del hash y los storage nodes que le corresponden. Por ejemplo: el rango del 0 al 1000 —del hash, no de la clave— está en S1, S2 y S3; el del 1001 al 5000, en S4, S8 y S10; y así hasta el último valor del espacio, ese FF de la notación hexadecimal. La tabla tiene que cubrir el rango completo: ninguna porción del espacio de hash puede quedar sin nadie que lo atienda.
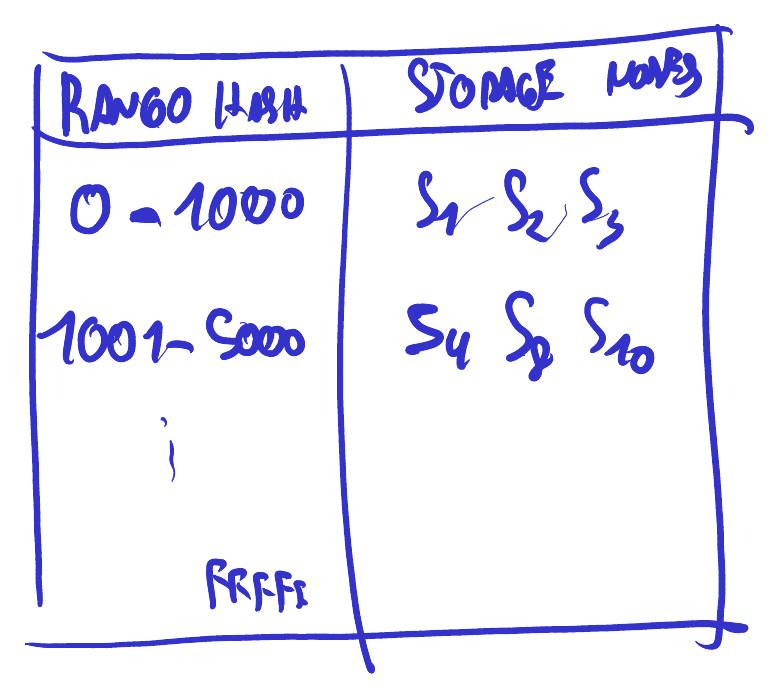
Esta es la primera diferencia de fondo con Dynamo. Dónde va cada cosa no se infiere de un anillo ni lo saben los nodos mismos: hay una base de datos aparte con los rangos, y cada rango dice a qué grupo de storage nodes pertenece. Tampoco hay preference list construida avanzando por un anillo: el rango está conectado directamente con sus tres storage nodes, y así se sabe dónde vive cada partición.
Grupos de replicación de tres nodos
Que los storage nodes de cada rango sean tres no es casualidad. Forman un grupo de replicación que, según el paper, usa multi-Paxos. Como no vimos multi-Paxos, podemos suponer que corren Raft: para lo que nos importa es bastante equivalente, y todo lo que sabemos de Raft se aplica igual.
Flujo de un get y de un put
Con las dos piezas presentadas, veamos el recorrido de un request completo. El cliente lo manda y llega al request router. El router, que por sí solo no sabe dónde vive cada clave, le manda al partition metadata system la clave hasheada —con MD5, por ejemplo—, y este le responde en qué tres storage nodes está.
Si es un get, el router se lo manda a uno cualquiera de esos tres, que responde, por defecto, con lo que tiene. La consecuencia es grande: por defecto la lectura no es linealizable, no es fuertemente consistente. Nadie buscó al líder ni armó un quórum de lecturas; se le preguntó a una réplica y se devolvió lo que tenía.
Si es un put, todo es igual hasta que el router se lo manda a un storage node. Ahí hay dos casos conocidos. Si llega al líder, este se lo manda a los otros dos, responden, se forma el quórum y contesta. Si llega a uno que no es líder, ese le reenvía el put al líder, que hace lo de siempre. Es la misma estrategia de Raft, y es lo elegante del asunto.
Estructura de un storage node
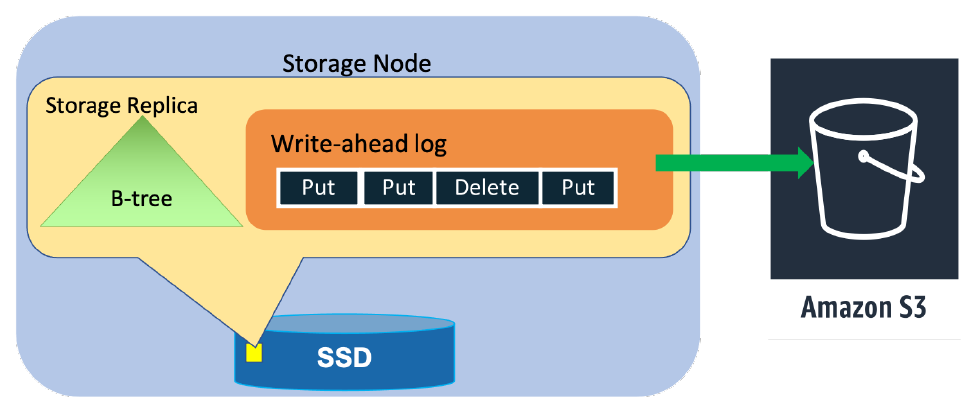
Por dentro, un storage node tiene dos piezas que ya conocemos de Raft.
Una es un write-ahead log, que es justamente lo que se replica con los otros pares del grupo. La otra es un B-tree, donde terminan guardados los datos, porque es fácil de acceder y resuelve rápido gets y puts. No es esencial que sea un B-tree —podría ser un hash gigante, o cualquier estructura que resuelva el acceso por clave en un puñado de saltos de disco—, pero el conjunto es el mismo que en Raft: una mitad es el log replicado y la otra es la aplicación con sus datos, ambas dentro de la misma máquina. Nosotros lo dibujábamos invertido; en el paper aparece en horizontal.
Recapitulando las diferencias con Dynamo: no hay relojes vectoriales, no hay sloppy quorum, no hay nada de eso. DynamoDB es básicamente un conjunto de grupos de replicación, cada uno replicado con un algoritmo símil Raft, que con el request router y el partition metadata system se comporta como una gran unidad.