5. Timestamp ordering
En esta sección
Orden serial definido por timestamp
Llegamos a la parte más interesante, porque es la ocasión de ver en concreto el control de concurrencia optimista —optimistic concurrency control, OCC—. La variante que aparece es muy antigua y se llama timestamp ordering. Está en un paper de Bernstein, otro nombre importante del área, que tiene además un par de libros sobre transacciones. No usa locks: garantiza la serializabilidad de manera optimista.
Es Philip A. Bernstein. El trabajo de referencia es Concurrency Control in Distributed Database Systems, de Bernstein y Nathan Goodman (ACM Computing Surveys 13(2), junio de 1981), donde el timestamp ordering aparece sistematizado junto con el resto de las familias de control de concurrencia; los libros son Concurrency Control and Recovery in Database Systems (con Hadzilacos y Goodman, Addison-Wesley, 1987) y Principles of Transaction Processing (con Eric Newcomer).
¿Cuál es la idea central? El orden serial de las transacciones se define a priori, por timestamp. Quien define el timestamp es el transaction coordinator. Imaginemos un orden serial de transacciones que fueron llegando una detrás de la otra. Cada una ahora se marca con un timestamp, y esto probablemente sí sea nuevo. Cuando la transacción inicia, el coordinador establece que “esta transacción ocurre a las diez y media de la noche” y la marca con ese valor. Usemos números chicos: esta tiene 11, esta otra 12, y así. Aunque no haya en ningún lado un log de transacciones —el dibujo es ilustrativo—, conceptualmente ocurrieron en el orden serial que define su timestamp.
¿Dónde aparece lo optimista? Viene una transacción nueva, el coordinador la marca con 14 y la trata de ejecutar. Va a ser aceptada, porque vino después de la 12. Ahora viene otra y el coordinador la marca con un valor un poco más viejo —es más fácil pensarlo imaginando que llegaron casi todas juntas—: le tocó 13. La última que se ejecutó fue la de 14. Entonces esta va a ser abortada, simplemente porque tiene un timestamp más viejo que la última que se ejecutó.
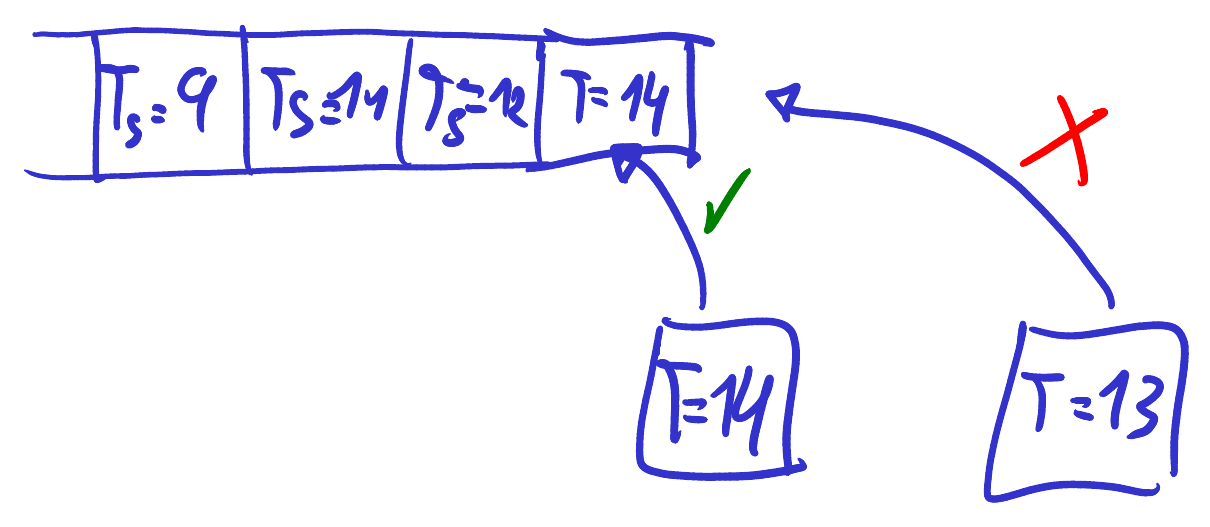
¿Dónde se hacen esas verificaciones? En los participantes mismos. Si un participante recibe una operación con un timestamp más viejo, la rechaza. No hay un coordinador de coordinadores verificando el orden; cada componente verifica cada operación individual. Como el timestamp viaja pegado a la operación, la verificación se puede hacer en cualquier punto del sistema, sin que nadie mire el cuadro completo. Y como todo sucede dentro del two-phase commit, en el prepare, el participante le dice directamente al coordinador que le llegó una operación vieja y que la transacción no puede seguir; el coordinador aborta todo. Esa es la idea básica del mecanismo.
Uso de relojes físicos
Hay un detalle para retener. Dedicamos una hora y media a los relojes de Lamport y a por qué usar timestamps de tiempo real es un problema serio. Este caso es interesante justamente por lo contrario: el mecanismo funciona también con relojes físicos.
¿Por qué? Porque no necesitamos coordinación ni causalidad entre estas transacciones. Cada transaction coordinator puede elegir el timestamp que quiera —sin consultar a nadie, sin acuerdo previo con los demás— y por definición ese va a ser el orden global para todo el mundo. El timestamp no intenta reflejar ninguna relación de causa y efecto entre eventos de máquinas distintas: es una etiqueta que alguien elige y que todos obedecen. Con eso alcanza, porque de todos modos queda definido un orden total.
Pueden pasar cosas problemáticas, claro. Si al asignar el 14 esa máquina estaba muy adelantada y asigna 70, mete un 70 en la fila, y todas las demás, con tiempo normal, van a ser rechazadas. Como los timestamps son tiempo real, el daño se mide en tiempo real: si el reloj de ese coordinador está una hora adelantado, los ítems que tocó rechazan toda escritura durante una hora, hasta que el resto del mundo alcance la marca grabada. Por eso, aun así, se trata de mantener los relojes más o menos sincronizados. Pero el algoritmo, salvo ese caso, funciona asignando timestamps arbitrarios.
Esa es la respuesta a por qué acá sí podemos usar relojes normales y no necesitamos relojes lógicos. Un coordinador con el reloj muy adelantado puede causar problemas; eso es lo único problemático.
Validación del timestamp en el storage node
El mecanismo aterriza en los storage nodes, que son los que lo aplican. Tenemos el storage node uno con una tabla de clave, valor y una columna más; por ahora tiene k₁ con valor v₁. Llega un prepare con la operación —un put de k₁ con valor v₂— y un tercer dato, el timestamp: 11. El coordinador, antes de mandar los prepares, decidió un timestamp para toda la transacción, y a todos les manda ese mismo 11.
El storage node guarda para cada ítem el último timestamp con que se escribió: esa es la columna de más, y en nuestra fila hay, por ejemplo, un 10. Al recibir el prepare compara el timestamp recibido con el de la fila. Como es posterior, no hay conflicto: esta transacción ocurrió después de la última que escribió ese valor. Responde OK. Si en cambio le mandamos un prepare(k₁, v₃, 9) —un coordinador algo atrasado—, responde que no: esa transacción no puede avanzar.
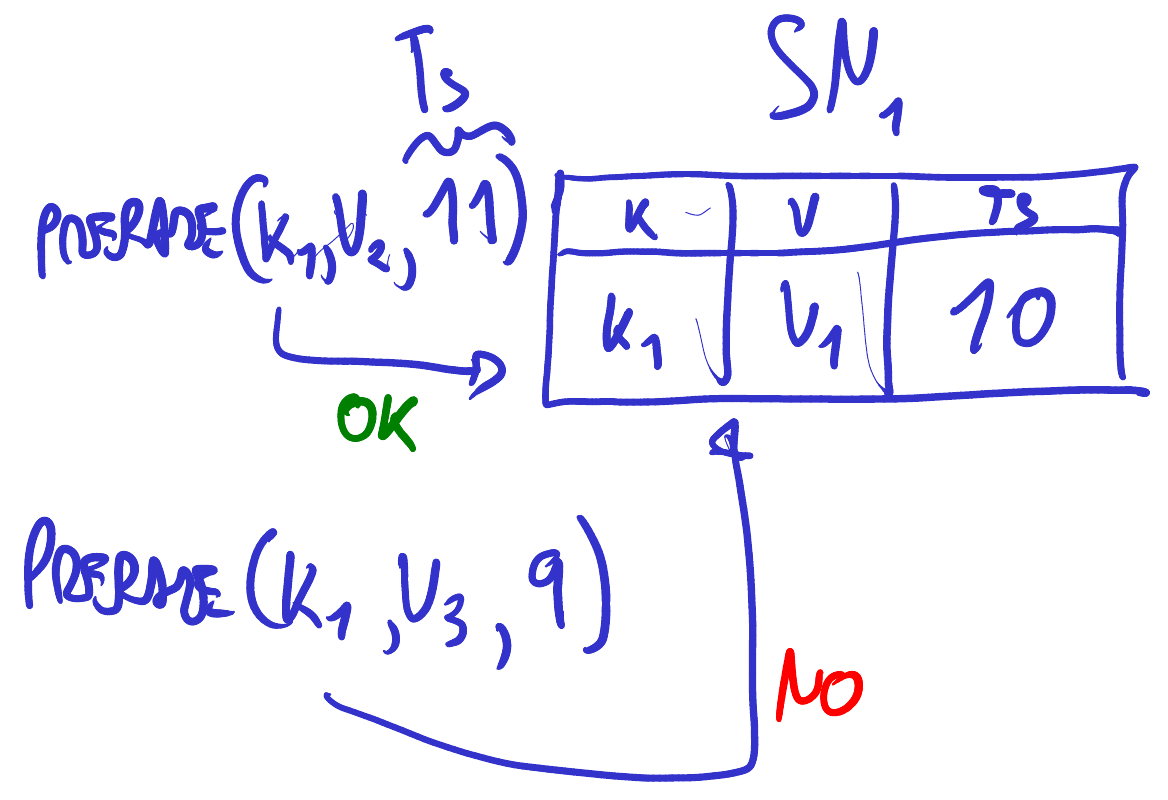
Así, a nivel de los prepares, cada nodo puede verificar timestamps y decidir unilateralmente si la transacción avanza. Con un solo valor viejo, ya la puede rechazar completa.
De ahí salen dos preguntas con consecuencias. La primera es sobre los puts comunes, los que no usan la lógica transaccional: ¿no habría que actualizar también el timestamp al escribirlos? Porque si no, hacemos un put, actualizamos el valor, y después viene una transacción a modificarlo. Según el paper, sí: un put común también pone el timestamp, lo cual significa que un put no transaccional puede hacer abortar una transacción. Son casos poco frecuentes. Y conviene anticipar algo que retomamos al final: la del timestamp no es la única regla que evalúa un participante al recibir un prepare. Hay cuatro, y las otras son bastante más extrañas; esa parte tampoco es del algoritmo, la inventaron los ingenieros de Amazon.
La segunda pregunta es si puede pasar que un solo nodo amerite rechazar el prepare mientras el resto está bien, y si por ese único nodo se revierte todo. Exactamente. Con uno solo desactualizado —o, más precisamente, con uno solo al que ya le llegó una transacción más nueva—, ese nodo rechaza a todas las demás. Es un criterio restrictivo, y esa restricción da pie a lo que viene.
Thomas write rule
Sobre esa restricción hay una optimización que el paper de DynamoDB no menciona por su nombre, pero que en el paper original de Bernstein figura con un nombre curioso: la Thomas write rule. Va como nota al margen.
La regla lleva el nombre de Robert H. Thomas, que la introdujo en A Majority Consensus Approach to Concurrency Control for Multiple Copy Databases (ACM TODS 4(2), junio de 1979). El survey de Bernstein y Goodman de 1981 la recoge con ese nombre, que es donde aparece catalogada como variante del timestamp ordering.
Supongamos que al final de la historia de un ítem hay una escritura con timestamp 8 y después otra con 10, y que esta última fue un put. En DynamoDB los puts pisan completamente el valor: no actualizan una columna, reemplazan el valor viejo con uno nuevo entero. Ahora llega un prepare con timestamp 9, también un put. Con la regla anterior sería rechazado, porque ya tenemos una escritura con 10. La Thomas write rule relaja un poco eso.
El razonamiento es: si hubiera aceptado ese valor y después hubiera ejecutado el put que lo pisó, lo podría haber aceptado de cualquier forma. No importa qué escriba el prepare viejo: la operación siguiente pisó el valor. Entonces, para no bloquear innecesariamente, si después hubo un put la acepta de todos modos: el prepare con 9 responde OK. Es una conclusión a la que probablemente habríamos llegado por nuestra cuenta. Los ingenieros de Amazon hacen esta y otra tanda de optimizaciones, pero esta es quizás la más ingeniosa.
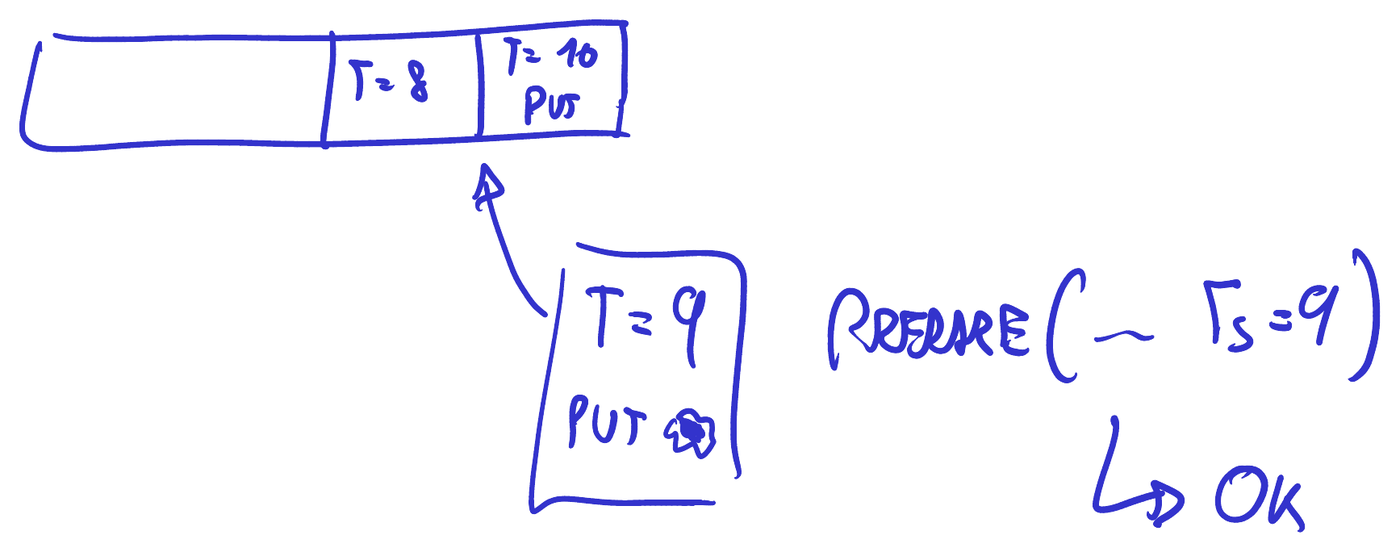
El razonamiento completo: la operación de timestamp 10 pisa el valor de la que estaríamos rechazando, así que la aceptamos; si la transacción se termina confirmando, directamente no aplicamos la operación, la descartamos, y el resultado es correcto. Si fuera un abort, también la descartamos. Lo interesante es el commit en el que no aplicamos la operación, porque la posterior la hubiera pisado de todos modos.
Deletes, max delete timestamp y reglas del prepare
Hay otro caso, exclusivo de lo que hicieron los ingenieros de Amazon, pero interesante de analizar: ¿qué pasa con los deletes?
En principio es lo mismo. Si ocurrió un delete antes y ahora viene un put, podemos revivir el valor, escribiendo algo con la misma clave que se había borrado. El problema es que un delete hace desaparecer la fila, y no queda un valor contra el cual comparar. Esa es la sutileza: cuando se borró una fila y ahora viene un valor, no sabemos si ese valor hubiera sido más nuevo o más viejo que el delete. Si el delete vino después de la transacción, corresponde rechazarla; si vino antes, aceptarla. Sin el row, no sabemos en qué caso estamos.
Hay dos formas de resolverlo. Una son los tombstones, también llamados borrado lógico: no borrar nunca, sino agregar al registro un campo deleted en true, por ejemplo. Así se aplica el mismo algoritmo que antes. A veces, en lugar de un booleano, ponen un deleted_at con la fecha del borrado; eso es implementación. Los ingenieros de Amazon señalan que hacer eso con todo lo que la gente quiere borrar sería un desperdicio enorme de espacio, y que además tendrían que seguir cobrándole al usuario por lo que borró. Así que hacen borrado físico, y con borrado físico no pueden usar el timestamp ordering tal como lo dimos.
La solución que armaron es exclusiva de este paper: guardar el max delete por partición, por storage node. Con un ejemplo: una tabla con k₁, k₂ y k₃, valores v₁, v₂ y v₃, y timestamps de escritura 8, 10 y 7. Vienen los deletes: primero k₁, después k₂, después k₃. El storage node, además de la tabla, guarda el max delete, el valor más grande que vio entre los borrados. Al borrar k₁ lo pone en 8. Al borrar k₂, en 10. Al borrar k₃ no lo actualiza, porque 10 ya es más grande que 7. Siempre guarda el delete más grande visto en la partición.
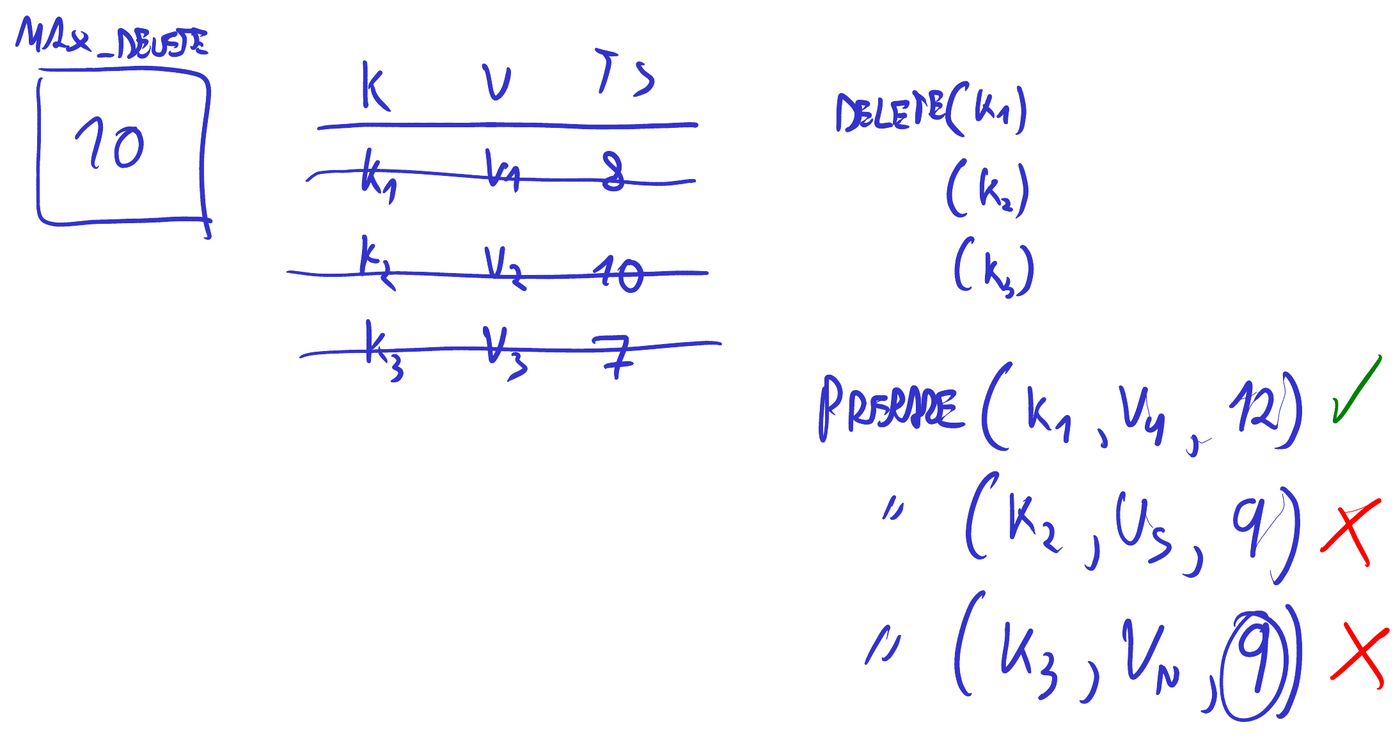
¿Qué pasa al escribir? Después de borrar todo llega un prepare de k₁ con un valor nuevo y timestamp 12. Comparamos 12 contra el 10 del max delete y lo aceptamos, porque viene después. No importa que hayamos borrado esa clave: lo que borramos lo borramos con timestamp a lo sumo 10, así que lo nuevo se escribe después. Tampoco importa que el timestamp propio de k₁ fuera 8: 12 es más grande que 10 y, por lo tanto, que 8. De ahí viene la ley de todo esto.
Lo mismo con k₂: llega un prepare con timestamp 9, lo comparamos contra el 10 del max delete —no contra el 10 de la fila— y lo rechazamos.
El caso interesante es el tercero: llega un prepare de k₃ con timestamp 9. Con un tombstone, sin borrar la fila, habríamos comparado ese 9 con el 7 de k₃, y como viene de una transacción posterior al borrado, lo habríamos aceptado. Pero como no queremos guardar todos los valores, comparamos contra el max delete, y la rechazamos innecesariamente. Puede haber falsos positivos en lo que rechazamos, y eso está bien. Aunque sea muy específico de DynamoDB, vale como ejercicio para pensar este tipo de algoritmos.
Queda lo que dejamos pendiente: las reglas raras. El paper tiene cuatro reglas para el prepare. Dimos solo el timestamp ordering porque es lo más interesante como algoritmo. Las dos primeras no son tan interesantes: que se cumplan las precondiciones que trae la transacción, y que escribir el ítem no viole ninguna restricción del sistema. La tercera es la que venimos viendo: que el timestamp de la transacción sea mayor que el del último write del ítem. Y la cuarta cambia bastante el panorama: el storage node no puede aceptar más de una transacción a la vez sobre el mismo ítem. Prepara de a una, y si ya preparó una y le llega otro prepare, lo rechaza.
Eso es en sí mismo como un mecanismo de lock aparte, y hace que lo demás resulte innecesario: las dos últimas condiciones —timestamps y no más de una transacción preparada— terminan haciendo lo mismo. Ellos mismos lo dicen en el paper: note that these last two conditions are overrestrictive. Lo que no queda claro es por qué agregaron las dos juntas. Estando las dos, el algoritmo funciona; pero no hay ningún caso a la vista donde una necesite de la otra. Parecen dos reglas que hacen dos veces lo mismo.
Los listings se leen distinto con esto en la cabeza. Hay uno que muestra cómo se procesa un prepare, y hace exactamente eso: evalúa las condiciones, las restricciones del sistema, los timestamps —el timestamp ordering— y que no haya ninguna ongoing transaction, es decir, nada preparado. Quizás en algún otro cuatrimestre aparezca el caso donde las dos reglas juntas son necesarias. Si a alguien se le ocurre, vale la pena decirlo; en principio parece innecesario.
def processPrepare(PrepareInput input):
  item = readItem(input)

  if item != NONE:
    if evaluateConditionsOnItem(item, input.conditions)
       AND evaluateSystemRestrictions(item, input)
       AND item.timestamp < input.timestamp
       AND item.ongoingTransactions == NONE:
         item.ongoingTransaction = input.transactionId
         return SUCCESS
    else:
         return FAILED
  else: #item does not exist
    item = new Item(input.item)
    if evaluateConditionsOnItem(input.conditions)
       AND evaluateSystemRestrictions(input)
       AND partition.maxDeleteTimestamp < input.timestamp:
         item.ongoingTransaction = input.transactionId
         return SUCCESS
  return FAILED
Listing 3 de Distributed Transactions at Scale in Amazon DynamoDB: la fase de prepare en el storage node.