2. Mayorías
Mayoría y cantidad impar de nodos
El truco para decidir cuál es la mitad que sigue adelante y cuál no es un solo concepto: la mayoría. De ahí sale todo lo demás.
En un sistema distribuido, una mayoría es la mitad más uno de los nodos. Si son tres máquinas, dos; si son cuatro, tres; si son cinco, también tres. Llamando N a la cantidad de nodos y M a la mayoría, M es N/2 + 1, y eso es toda la definición.
La intuición que nos interesa es más específica: los sistemas donde usamos mayorías y la cantidad de nodos es impar. ¿Por qué impar?
Con tres nodos, N vale tres y M vale dos. La propiedad de los sistemas impares es esta: si particionamos la red de cualquier forma, siempre queda una mitad con mayoría y una con minoría. Con cinco se ve mejor porque hay más cortes posibles. Si el corte aísla un solo nodo, queda una mitad con cuatro y otra con uno; si cae más al medio, una con tres y otra con dos, y mirados desde el otro lado son los mismos dos casos. En todos hay al menos tres nodos de un lado, y esa es la mitad que continuaría.
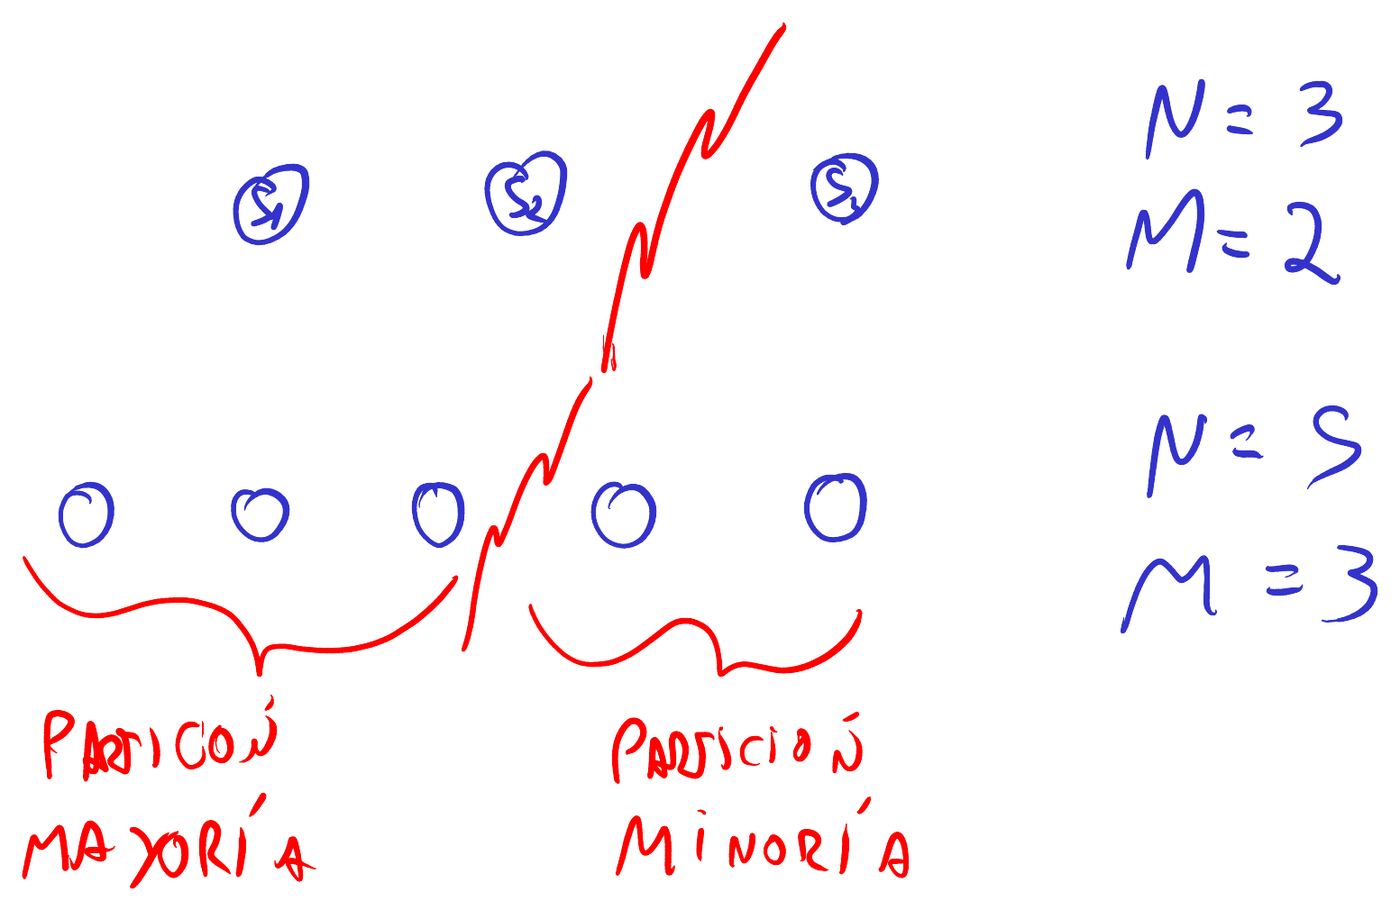
Este es el principio básico que van a tener todos estos algoritmos para garantizar la consistencia incluso con particiones de red. La mitad con mayoría sigue adelante, y la otra funciona en modo degradado: responde información desactualizada, si eso es tolerable, o deja de responder. A una se la llama partición de mayoría, y a la otra, partición de minoría.
Lo importante es que la cantidad impar, combinada con la definición de mayoría, ya nos da una asimetría, y es esa asimetría la que les permite a los nodos decidir unilateralmente qué hacer, porque de todas maneras no se van a poder comunicar.
Hay otro concepto importante que puede resultar confuso al principio. El N y la M, en cada sistema, son un parámetro de diseño o de configuración. El N no se va modificando a medida que se caen servidores. Si tenemos tres máquinas y una muere, no es que ahora N valga dos: N sigue valiendo tres. De hecho, ese caso es equivalente al de la red particionada dejando un nodo de un lado. Las otras dos van a poder seguir operando, porque siguen siendo mayoría. La que murió no va a operar ni siquiera en modo degradado: directamente no va a estar disponible. Pero N no se modifica, y en consecuencia M tampoco.
DynamoDB sirve de ejemplo. Ahí N vale tres —casi un parámetro de diseño—, de manera que todas las particiones se dividen siempre en tres réplicas.
Y es por esto que los ingenieros de sistemas distribuidos somos tan obsesivos con los números impares. Quien haya trabajado con Amazon va a reconocer la estructura: está distribuida en regiones, y cada región tiene lo que llaman availability zones, que son, esencialmente, data centers: instalaciones llenas de servidores. Por diseño, cuando crean una región nueva disponen por lo menos tres separados, porque tener tres es lo que les permite implementar este tipo de algoritmos. DynamoDB, que siempre tiene tres réplicas, va a quedar con una en cada data center. Y eso importa porque es muy probable que el data center como un todo quede fuera de servicio: un corte de energía, una falla de infraestructura. Con las réplicas en instalaciones separadas, el sistema sigue operando.
También es común que haya particiones de red entre data centers, porque están conectados por fibra óptica. Un caso típico: una obra entre dos data centers corta con una amoladora el cable de fibra que los une. Aunque haya rutas redundantes, perder un enlace puede degradar tanto la comunicación que el data center queda prácticamente fuera de servicio.
La cantidad impar de data centers que usan Google y estas empresas se relaciona, entonces, con poder implementar estos algoritmos: tener un poco de asimetría artificial para que una parte de la red siga funcionando y la otra no.
Elección de líder: primera aproximación
Esa asimetría se ve mejor con un anticipo de lo que viene: la elección de líder. Tomemos cinco nodos —siempre vamos a usar cinco en los ejemplos, porque es donde queda más claro—, S1 a S5. Supongamos que no hay líder y hay que elegir uno. Esto es también un anticipo de cómo lo va a hacer Raft, aunque Raft tiene después algunas particularidades propias.
Uno de esos nodos va a manifestar que quiere ser líder, por razones que vamos a ver después. Se transforma en candidato, y lo que hace es pedirles votos a los demás. Los servidores le responden, y cuando el candidato recibe una mayoría de votos se convierte en líder. Hagamos el conteo con detenimiento: el candidato típicamente se vota a sí mismo, así que le hacen falta dos votos ajenos para llegar a la mayoría de tres.
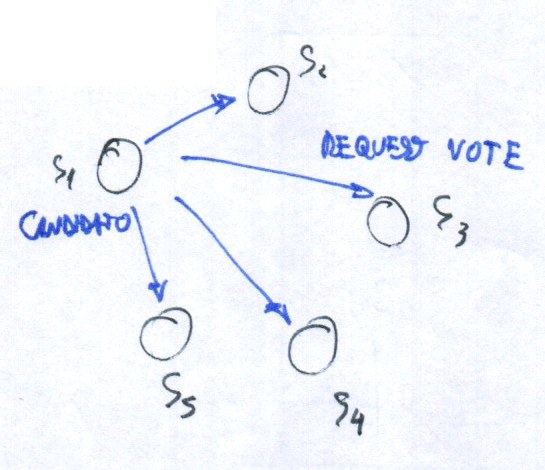
Miremos ahora la misma situación con una partición en el medio: dos nodos quedaron separados del resto y surge la necesidad de elegir un nuevo líder. Consideremos el caso complicado: dos candidatos simultáneos, uno de cada lado del corte.
Del lado grande, el candidato le pide un voto a un vecino y ese dice que sí; le pide al otro y también. Uno, dos, tres: se convierte en líder. Del otro lado, el candidato le pregunta a su único vecino, que le dice que sí, se cuenta a sí mismo, y le falta un voto. Va a tratar de comunicarse con el resto y no va a poder.
El conteo de ese lado es donde suele producirse la confusión. Ese candidato tiene dos votos: el propio y el del vecino. Necesita tres, porque el sistema total es de cinco. Le hacen falta dos votos externos y consiguió uno solo.
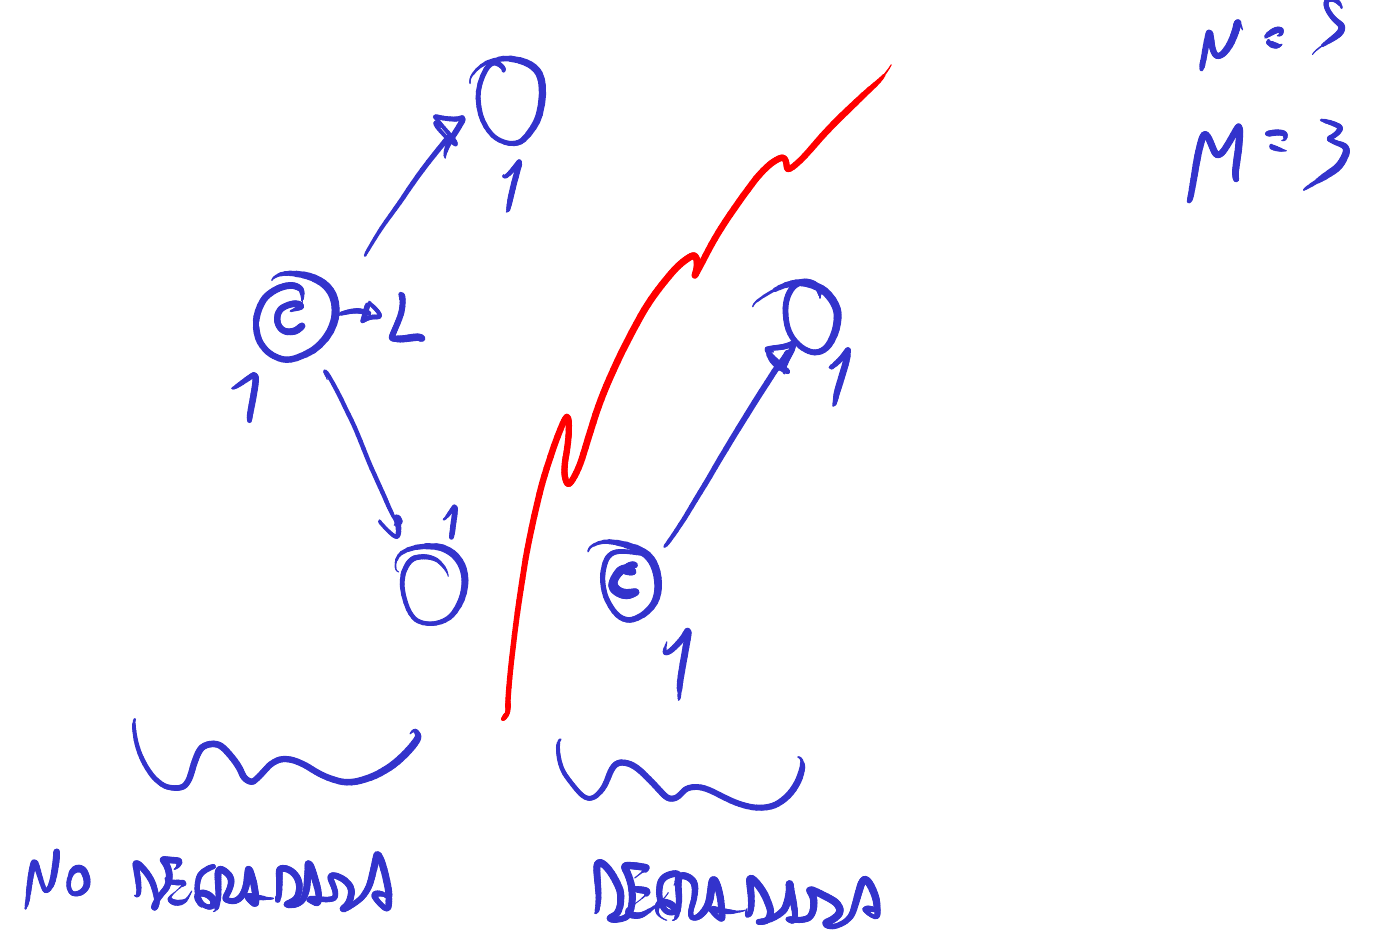
Aquí se ve con claridad cómo la idea de mayorías resuelve la elección de líder de manera natural, sin forzar nada. La mitad pequeña simplemente no puede avanzar con el algoritmo, que es tan simple como esto: me convierto en candidato y me vota una mayoría. Una partición ya alcanza para que eso no ocurra, y por eso esa mitad va a ser la degradada, y la otra, la no degradada. En Raft el mecanismo es un poco más complejo, pero esto ya sirve para generar la intuición de cómo aparecen casi automáticamente las propiedades de la mayoría, con muy pocos elementos.
¿Y cómo sabe la mitad degradada que no puede seguir con la votación? Tiene que conocer todos los nodos del sistema original, y los conoce por diseño: todos saben desde el principio que son cinco, y asumimos que cada uno conoce la IP —o el nombre— de todos los demás. En este esquema la configuración es fija; agregar o quitar nodos a medida que se producen fallas es un problema aparte. Concretamente, el nodo del lado pequeño va a intentar comunicarse con los otros tres y solamente uno le va a responder. Sabe que necesita dos votos que nunca va a obtener; si está bien programado, no se convierte en líder con uno solo. Si estuviera mal programado y diera por suficiente ese único voto, ahí se nos produce el split brain: ese líder puede empezar a aceptar requests, y ahí está el gran problema.
¿Qué se hace normalmente en ese caso? La mitad degradada no puede hacer mucho; eventualmente no puede hacer nada. Con Raft va a empezar a responder error, primero porque sabe que no es el líder. Pero podría pasar que el nodo que quedó en la minoría sea el líder: la red se particiona y el líder queda del lado pequeño. Ese caso también lo contempla Raft, y ese líder va a empezar a responder error porque, por otra cuestión que veremos más adelante, esa mitad no va a poder avanzar.
A lo sumo se van a poder hacer dos cosas. Una escritura nunca va a ser aceptada. Una lectura depende de qué tan relajados sean los criterios de consistencia: quizás se responde, dando por sentado que quien la solicita sabe que puede estar desactualizada. Va a ser una lectura que en algún momento estuvo en la otra mitad; lidiar con un dato desactualizado queda a cargo de quien lee.
Y aquí hay una sutileza del paper que es importante: Raft opta por la no disponibilidad, no por la no consistencia. Una lectura en la mitad pequeña devuelve error. La intuición que nos va a quedar es que Raft perfectamente podría responder una lectura desactualizada, y quien decida hacerlo puede hacerlo, pero el paper en teoría no lo permite. El caso de las lecturas lo retomamos la clase que viene.