5. Servicios cloud
En esta sección
Si volvemos a la tabla con la que arrancamos, ya vimos todo: el consistent hashing y los relojes vectoriales en la clase pasada, y el sloppy quorum, los Merkle trees y el gossip hoy. El catálogo quedó completo, y eso es lo que hace valioso este paper: es un gran catálogo de los mecanismos que uno efectivamente termina usando cuando le toca implementar un sistema distribuido.
Queda el otro paper, el de DynamoDB. Su arquitectura es interesante, pero lo más interesante es otra cosa: es el primer servicio cloud que vamos a estudiar.
Más allá del uso comercial del término, ¿qué significa que algo sea un servicio cloud? Se entiende por contraste. Los papers anteriores eran arquitecturas que inventaba Google, Amazon, Facebook o quien fuera, y esas mismas empresas tenían que desplegarlas: poner los nodos, configurarlos y mantenerlos en su propia infraestructura.
Dynamo ilustra bien el punto. Cada equipo de Amazon que quería usarlo le preguntaba al equipo que lo había inventado cómo funcionaba; le pasaban el repositorio, o lo que fuera, y ese equipo desplegaba su propio Dynamo. Eran responsables de que funcionara, y si algo se rompía tenían que arreglarlo ellos. Por mucho tiempo, eso fueron los sistemas distribuidos.
Eso cambió mucho, porque ahora casi todo se delega a servicios cloud. Un servicio cloud es, básicamente, un sistema distribuido que opera otra organización: generalmente un proveedor de cloud como Amazon, Microsoft o Google, los tres grandes, y algunos más pequeños. Esa es la diferencia principal.
Hay otra diferencia, más filosófica. Dynamo, Google File System, MapReduce: ninguno tenía valor en sí mismo, sino que resolvía un problema. Amazon instalaba Dynamo para resolver el carrito de compras y que los clientes realizaran sus compras; de ahí obtenía sus ingresos. Dynamo era solo un componente del sistema. En un servicio cloud la relación es la inversa: el servicio mismo es lo que se vende.
DynamoDB nació justamente con ese objetivo: tomar la idea de las bases no relacionales, que había tenido muy buena recepción, y venderla como un servicio administrado por Amazon. Vamos a llegar ahí. Pero un servicio cloud tiene cuatro propiedades que lo separan de todo lo que vimos antes, y hay que mirarlas primero.
Fully managed
Detrás de cada uno de estos servicios hay un equipo que lo desarrolla y lo mantiene, pero desde afuera uno no lo opera. El paper de DynamoDB tiene un nombre para eso: el servicio es fully managed, completamente operado por la empresa.
Cuando a uno le toca usar DynamoDB —y es probable que en algún momento de la carrera le toque— la experiencia es esta: se crea una tabla, la tabla aparece y se la empieza a usar. No hay que preocuparse por el aprovisionamiento. La nube es un término muy poético, pero las cosas no están en ninguna nube: hay servidores físicos. Cuando uno crea una tabla, alguien del otro lado tiene que elegir un servidor físico, con su procesador y su disco, y la tabla se crea en el disco de esa máquina. Todo eso es transparente: nada de eso lo elige ni lo ve el que creó la tabla.
El escalado también lo manejan ellos. La actualización del software depende del sistema, pero en la mayoría uno no se tiene que preocupar por actualizar el sistema operativo de lo que corre su tabla. Después viene la tolerancia a fallas, y aquí hay algo casi paradójico: si la maneja Amazon, parece que esta clase no tuviera sentido, porque llevamos dos meses hablando de tolerancia a fallas y, si uno usa Dynamo, se olvida del tema. Aunque hay un matiz: si uno quiere trabajar en Amazon, tiene que aprender cómo funciona y todas las técnicas que la implementan, que también se usan a pequeña escala. Con la replicación pasa lo mismo. Y la lista es más larga: estos son apenas algunos ejemplos de lo que un servicio fully managed resuelve por el cliente.
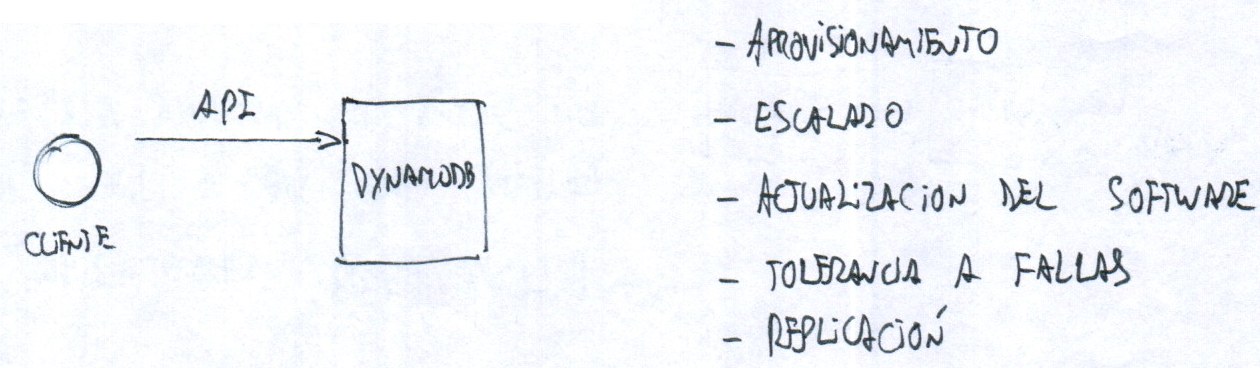
Eso es fully managed. Todos los problemas en los que pusimos tanta cabeza, Amazon cobra por resolverlos: dispone de personal que, cuando algo falla, se levanta en mitad de la noche, se conecta por SSH y lo repara. Es una de las propiedades más seductoras para las empresas, porque la parte más difícil de un sistema distribuido se delega en otra empresa. Y eso facilitó mucho el desarrollo web a gran escala: internet creció de forma explosiva cuando hubo empresas grandes dedicadas a resolver los problemas difíciles y empresas muy pequeñas que simplemente usaban esos servicios.
Multi-tenant
Para que eso tenga sentido, primero tienen que cerrar los números. No sería viable que por cada cliente nuevo de Amazon alguien tuviera que instalar una máquina física en el rack y ponerla en funcionamiento.
De ahí la segunda propiedad: estos sistemas son multi-tenant, y tenant quiere decir inquilino. Sobre un único sistema —un único DynamoDB, por ejemplo— viven todos los usuarios mezclados. Cada uno está aislado del otro, pero comparten la misma infraestructura, y eso permite aplicar economía de escala. Sería muy costoso que cada cliente tuviera su propio DynamoDB. Lo que hace falta entonces son mecanismos para que un usuario que usa mucho una parte del sistema no interfiera con otro; en la jerga, el noisy neighbor, el vecino ruidoso.
No siempre fue así. Antes de Amazon, cuando esto ni siquiera se llamaba nube, hubo proveedores que funcionaban al revés: por cada cliente nuevo creaban una instancia nueva de Postgres, y cada uno terminaba con su propia base corriendo aparte.
Y la pregunta no desapareció con ellos. Quienes no están familiarizados con los sistemas modernos suelen preguntar si cada cliente de una empresa tiene su propia base de datos o si es todo una única base. La respuesta es que están todos en una única base. El costo operacional y económico de infraestructura propia por cliente, cuando uno quiere miles o millones de clientes, sería prohibitivo.
Multi-tenant es eso: los clientes comparten el sistema, abstraído de manera que ninguno lo note. En los sistemas cloud es prácticamente un principio fundamental.
API con SLA
Después vienen detalles más finos. La API tiene un SLA estricto, y eso es parte de lo que venden: garantía de disponibilidad y de latencia. Cuán laxo sea depende de la empresa. Amazon mide la disponibilidad en cantidad de nueves: el 99,99% del año el sistema tiene que estar levantado, y el 0,01% restante es el margen de caída tolerado. El año tiene 525.600 minutos, así que ese margen son 53 minutos: si el servicio estuvo caído menos que eso en el año, el contrato se cumplió. Si se pasan, devuelven un porcentaje del dinero según el tiempo excedido. Así de estrictos son con el SLA.
No venden solamente el servicio, sino también, como parte del contrato, la garantía de que va a funcionar. Todos los proveedores grandes tienen garantías de este tipo.
Escala “ilimitada”, elasticidad y serverless
Lo otro muy prometedor para las empresas, especialmente las startups, es la escala ilimitada. No es realmente ilimitada: lo es en el sentido de que si la instancia de DynamoDB resulta insuficiente, podemos ampliarla, en principio sin límite. También se la llama elasticidad. Son términos de marketing y algo confusos. Lo que importa es que todo el aprovisionamiento está abstraído del lado del servicio: el cliente ya no elige cuántos nodos tiene su DynamoDB, simplemente solicita más capacidad y el sistema se adapta.
Al costado hay un término que se escucha mucho y que en algún momento veremos con más detalle: serverless. No quiere decir que no haya un servidor. Se aplica más bien al cómputo. Cuando uno compra cómputo —máquinas virtuales, containers, servidores dedicados—, cada producto expone distinta visibilidad sobre las máquinas físicas. En el producto de máquinas virtuales de Amazon, uno crea una máquina, la ve y puede acceder a ella. En otro producto, serverless, que se llama Lambda, uno manda un código y ese código se ejecuta en algún lugar. Lo que se configura es cuánta memoria tiene la función —el procesador escala junto con la memoria— y cuántas copias pueden correr a la vez; cuántas instancias hacen falta en cada momento lo decide Amazon sola. Esos requests también se ejecutan en servidores, pero los administra Amazon y uno no los ve: por eso serverless. Es una cuestión administrativa. La capacidad está mucho más abstraída, y la unidad deja de ser la máquina: en las máquinas virtuales se cuentan máquinas, en Lambda ejecuciones simultáneas toleradas. Es otro término de moda, ligado directamente a esa escala supuestamente ilimitada.
Modelo de cobro
El modelo de cobro es casi un descanso en la teoría dura, y sin embargo es la parte con la que uno más va a tratar: en la práctica profesional uno interactúa con proveedores de cloud mucho más de lo que arma servicios como estos. Cuando algo falla o se comporta de manera anómala, la teoría sirve para intuir qué puede estar mal —problemas de consistencia, por ejemplo—, pero en el día a día lo que preocupa es cómo escalan los servicios y cuánto cobran.
La característica principal se entiende otra vez por contraste. Antes uno compraba una máquina física y la instalaba en algún lado: una inversión toda al principio, con la cuenta de en cuánto tiempo se recupera, la amortización a lo largo de los años, y la decisión de cuánta capacidad de más comprar para no quedarse corto. En un servicio cloud eso desaparece: se cobra como la luz o el gas, por uso. Es un principio fundamental que en el sentido amplio nunca falla: si uno usa menos, paga menos; si usa más, paga más. Las variaciones están en el detalle, y tres ejemplos muestran lo distintas que resultan.
El primero son las máquinas virtuales. En Google Cloud, por ejemplo, se cobra la hora de uso: si uno deja una máquina funcionando tres horas, la factura dice tres horas multiplicadas por el precio de la hora.
El segundo es un CDN, un content delivery network: una red de servidores caché distribuidos por el mundo, que sirven imágenes y páginas web desde un lugar cercano a quien las pide, lo que acelera mucho las descargas. Si todo tuviera que llegar al servidor central, que bien puede estar en Estados Unidos, sería muy lento. Los cachés se conectan solos con el servidor original, que les manda el contenido, y uno accede a esa copia cercana. El ejemplo familiar es Netflix: cuando lo vemos, el tráfico no va hasta Estados Unidos sino a algún servidor cercano, en la zona de Buenos Aires. Un CDN cobra por tráfico. Lo llamativo es que el modelo es completamente distinto del anterior: uno cobra por hora, el otro por tráfico. Y en ninguno hay un pago inicial para recién después poder usar el servicio.
El tercero es DynamoDB, una base de datos, que combina dos dimensiones: storage y requests por segundo. Cobra más cuanto más espacio se usa y cuantas más queries se hacen. La cuenta es más complicada, pero la idea es la misma: cuanto más se usa, más se cobra. Y si casi no se usa, quizás haya algunos costos fijos, pero la factura no aumenta.
Esto tiene una consecuencia arquitectónica, y es lo más interesante. El usuario se conecta en abstracto con el servicio cloud y lo usa. Pero internamente estas empresas tuvieron que inventar otros servicios para que el cobro por uso sea posible. El servicio cloud le manda datos a un servicio que suele llamarse metering, el equivalente del medidor de gas de una casa: le va mandando las métricas de uso de cada usuario. En Dynamo, donde se cobran requests por segundo, le reporta cada cierto tiempo cuántos requests hizo cada usuario. El metering agrega todos esos datos y se los pasa al servicio de billing, que los combina con los precios, hace todas las complicaciones contables, y el resultado vuelve al usuario: la factura, que después hay que pagar.
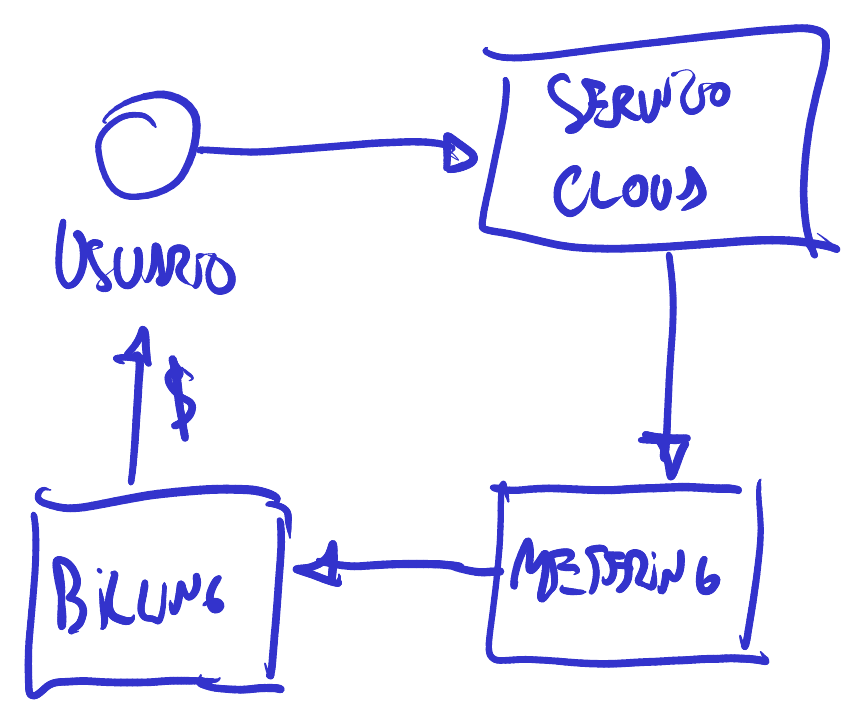
Los servicios cloud tuvieron que resolver una parte que uno no imaginaría: si esto se va a vender, hay que poder medirlo y cobrarlo.