5. Relojes vectoriales y reconciliación en Dynamo
En esta sección
Relojes vectoriales
Los algoritmos que se arman sobre relojes de Lamport suelen ser complicados, justamente porque la relación de la que disponemos es limitada: una implicancia en un solo sentido. Sería muchísimo mejor que valiera al revés, que de C(a) < C(b) pudiéramos concluir que a ocurrió antes que b. Pero funciona exactamente al revés: si sabemos que ese fue el orden de los eventos, entonces los números van a dar bien; pero que los números den bien no garantiza absolutamente nada sobre el orden.
La solución a ese problema es bastante más fácil de entender que lo anterior. Se llaman vector clocks: relojes vectoriales.
El espíritu es el mismo: queremos un mecanismo para detectar la precedencia entre eventos. Lo interesante es que ahora sí se va a cumplir la propiedad fuerte, la que nos quedó faltando: a ocurrió antes que b si y solo si V(a) < V(b). En los dos sentidos, no en uno solo.
Ese V(a) ya no es un contador suelto: es un vector, un array de números, uno por cada nodo del sistema. Si tenemos tres nodos, cada vector va a tener tres posiciones, y los números que guarda adentro en general van a ser distintos entre sí. Lo único que importa es que la cantidad de elementos coincida con la cantidad de nodos del sistema.
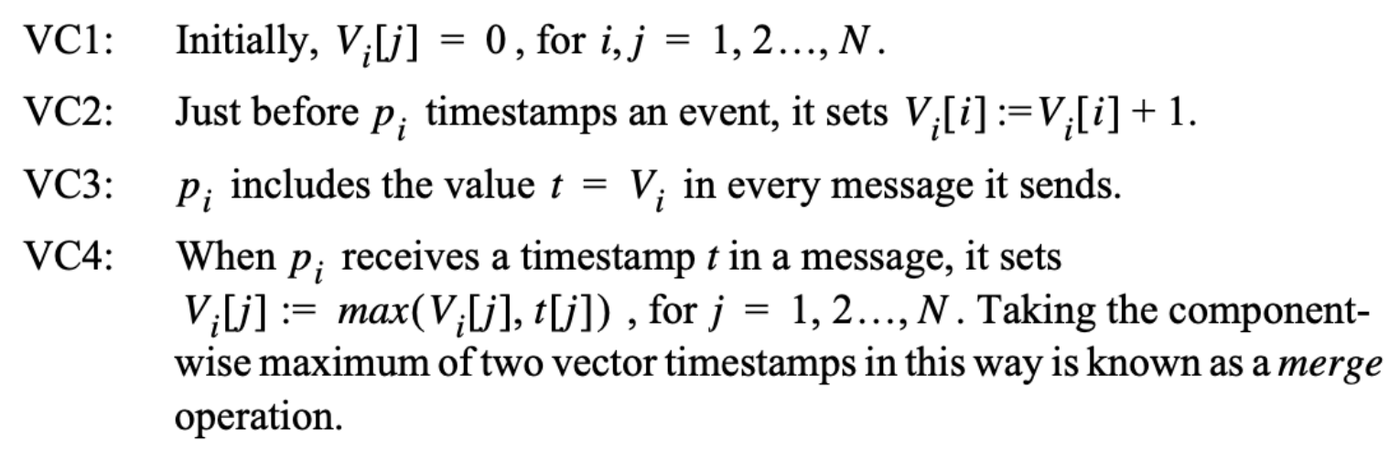
Las reglas son tres, con una aclaración previa: todos los contadores arrancan en cero. Los de Lamport también arrancaban en cero, aunque no lo hayamos dicho explícitamente; aquí el punto de partida es un vector entero de ceros. La primera regla es que justo antes de que ocurra un evento local se incrementa el contador, y lo interesante es cuál: el que corresponde a la posición propia. Si son tres posiciones, una le corresponde a este nodo, y esa es la única que toca; las otras dos quedan como estaban. La segunda es que se incluye el vector entero en cada mensaje, igual que con Lamport se mandaba el contador. Y la tercera es que, al recibirlo, hay que aplicar la misma regla que en Lamport, pero considerando que cada posición del vector es un reloj de Lamport individual.
Es mucho más fácil verlo con un ejemplo. Tenemos tres procesos y todos arrancan en (0,0,0).
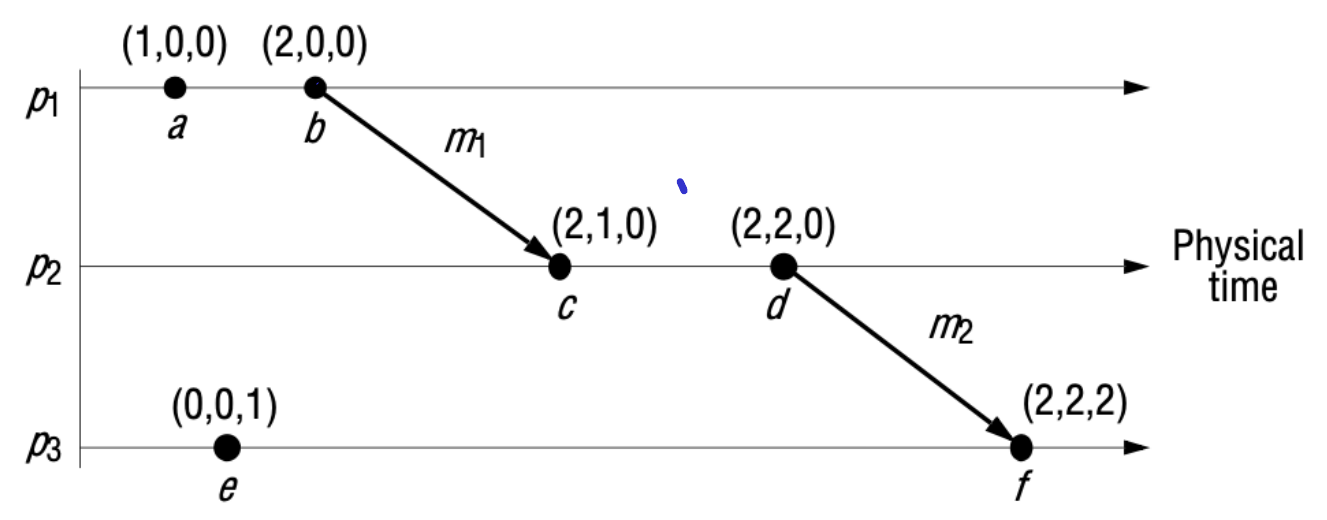
En el primer proceso ocurre un evento: su posición sube a uno y el vector queda en (1,0,0). Ocurre después otro —enviar un mensaje— y esa misma posición sube a dos: (2,0,0). Ese vector, tal cual está, viaja junto con el mensaje.
Del otro lado, el segundo proceso lo recibe y tiene que combinar los dos vectores, el propio y el que llegó, tratando cada posición como un reloj de Lamport independiente. Su vector venía en (0,0,0). Para la primera posición compara su cero contra el dos que llegó, y gana el dos. Para la segunda, que es la propia, la incrementa en uno; como el mensaje traía un cero ahí, queda el uno. La tercera se queda en cero. El resultado es (2,1,0).
Más abajo, en ese mismo proceso, ocurre otro evento local: incrementa su propio contador, el segundo, y el vector queda en (2,2,0). Y desde ahí sale otro mensaje, que se lleva ese vector consigo.
Mientras tanto, en el tercer proceso había ocurrido un evento suelto, que no tiene que ver con nada de lo anterior: su vector pasó de (0,0,0) a (0,0,1). Cuando le llega el mensaje del segundo proceso, ese evento de recepción tiene que mergear su vector con el que llegó. Compara su cero contra el dos y queda el dos; compara su cero contra el dos y queda el dos de vuelta; y la tercera posición, que es la propia y valía uno, la incrementa a dos y la compara con el cero que traía el mensaje: gana el dos. El resultado es (2,2,2).
Comparada con otras cosas que uno se cruza en la carrera, la lógica es sencilla. Lo que quizás no sea tan fácil de ver es por qué funciona, y en eso no vamos a profundizar. Lo que sí importa es cómo se comparan dos de estos vectores, porque ahí está todo lo interesante: al compararlos de la forma correcta obtenemos exactamente qué ocurrió antes que qué, y qué es concurrente con qué.
De manera informal, para que haya una relación de precedencia entre dos vectores tienen que darse dos condiciones: todos los elementos de uno tienen que ser mayores o iguales a los del otro, posición por posición, y por lo menos uno tiene que ser estrictamente mayor. Lo segundo hace falta porque si fueran todos iguales estaríamos hablando del mismo evento, y eso no puede ocurrir.
Sobre el ejemplo se comprueba enseguida. El evento que quedó en (2,2,2) ocurrió después del que quedó en (2,2,0): dos es mayor o igual que dos, dos es mayor o igual que dos, y dos es mayor que cero. Todos mayores o iguales, y el último estrictamente mayor: hay precedencia. Algo parecido pasa comparando (2,1,0) con (2,2,0): el dos y el dos son iguales, el uno es menor que el dos, el cero y el cero son iguales, así que también hay precedencia, en la dirección esperada.
El caso interesante es el otro. Comparemos (2,1,0), el evento de recepción del segundo proceso, con (0,0,1), el evento suelto del tercero. Dos es mayor que cero, sí. Uno es mayor que cero, sí. Pero cero no es mayor que uno. Ahí la comparación no dio bien, y cuando no se cumple que todos sean mayores o iguales entre sí, lo que tenemos son dos eventos que fueron concurrentes.
Ahí está lo que vuelve verdaderamente potente al mecanismo: no solo permite detectar la precedencia, sino además detectar cuáles eventos fueron concurrentes, cuáles no tienen ninguna relación entre ellos. Es muchísimo más potente que los relojes de Lamport.
Escrito de forma más matemática, son dos enunciados. El primero es que V(a) < V(b) si y solo si a ocurrió antes que b, y a eso lo llamamos causalidad. El segundo es que si V(a) no es menor o igual que V(b) y además V(b) tampoco es menor o igual que V(a), entonces a y b son concurrentes, a ∥ b, y a eso lo llamamos concurrencia. El segundo tiene una rareza: con números normales no podría pasar, porque dados dos cualesquiera siempre alguno es menor o igual que el otro. Con vectores sí puede ocurrir que no se dé ninguna de las dos comparaciones.
Los dos nombres conviene retenerlos, causalidad y concurrencia, porque son exactamente los dos casos que Dynamo necesita distinguir. Toda la clase fue para llegar a este punto: lo que sigue es cómo Dynamo los usa para detectar cuándo hubo causalidad entre dos escrituras y cuándo hubo concurrencia.
Escritura sin conflictos: un reloj por clave
De vuelta en Dynamo, ya tenemos el anillo con sus nodos, ya sabemos que una clave cae en algún punto de la circunferencia y ya definimos el grupo de replicación que se hace cargo de ella. Para lo que viene dibujemos esos tres nodos aparte: siguen sobre el anillo, pero el anillo ya no importa.
La escritura de algo nuevo funciona así: se elige uno de los tres, se le manda el valor que uno quiere escribir —un put(k1, v1)— y ese nodo lo escribe localmente. Y aquí aparece un punto que todavía no habíamos dicho y que es donde entran los relojes: cada clave está asociada a un reloj vectorial. Como k1 no existía hasta recién, Dynamo guarda internamente la clave, el valor v1 y además le inicializa un reloj propio a esa clave en particular.
El nodo elegido es lo que el paper llama el coordinador, y lo que hace es incrementar su propia posición dentro de los tres números del vector. Si el elegido fue el del medio, el reloj queda en (0,1,0). Después replica: les manda a sus dos compañeros la clave k1, el valor v1 y el mismo vector (0,1,0), y ellos también lo escriben.
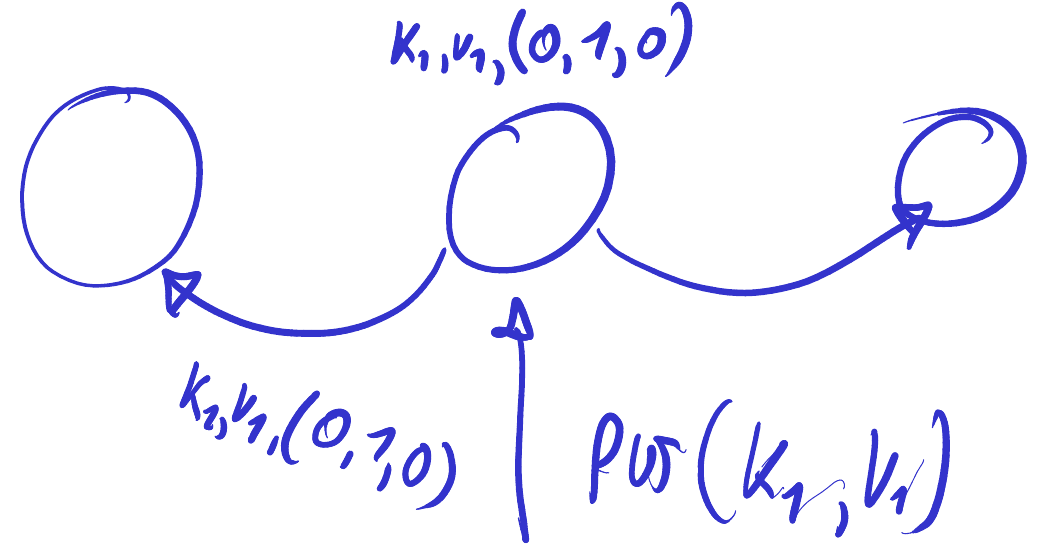
¿Por qué el que recibe eso lo acepta? Este caso es fácil: ve que no tiene esa clave y la acepta directamente. Pero el razonamiento que importa es el hipotético: si la tuviera, tendría un vector asociado, y ese vector vendría antes que el que le están mandando, así que igual la terminaría aceptando. Ahí se empieza a ver para qué van a servir estos vectores.
Ese es el caso feliz de un ítem nuevo. Y todo lo que sigue también va a ser el caso feliz.
Update y contexto opaco
Los updates en Dynamo no se pueden hacer a ciegas. Siempre hay que obtener la clave primero, modificarla y recién entonces volver a ponerla; es parecido a lo que vimos en ZooKeeper con el locking optimista. No podemos dar por sabido que la clave existe y mandar el valor nuevo directamente.
La secuencia concreta es así. Primero hacemos un get(k1), y eso nos devuelve dos cosas: el valor y el reloj vectorial que esa clave tiene asociado en ese momento. El reloj no viene suelto, y aquí hay un detalle que el paper se toma el trabajo de explicar: viene dentro de un campo opaco al que llama contexto. Opaco quiere decir que no tenemos por qué interpretarlo ni derecho a depender de su formato: para nosotros es una cadena de bytes sin significado. ¿Para qué nos lo manda, entonces? Para que se lo terminemos devolviendo.
Después, cuando hacemos el put(k1, v2), tenemos que mandarle el mismo reloj vectorial que nos había dado originalmente: el contexto va y vuelve intacto. Eso sirve, en principio, para saber si hay dos clientes modificando la misma clave concurrentemente: es la misma idea del locking optimista.
Pero lo interesante es qué pasa cuando llega ese request. Tenemos de vuelta los tres nodos, y para complicarlo un poco imaginemos que esta vez se elige un coordinador distinto del anterior, y que el put aterriza ahí.
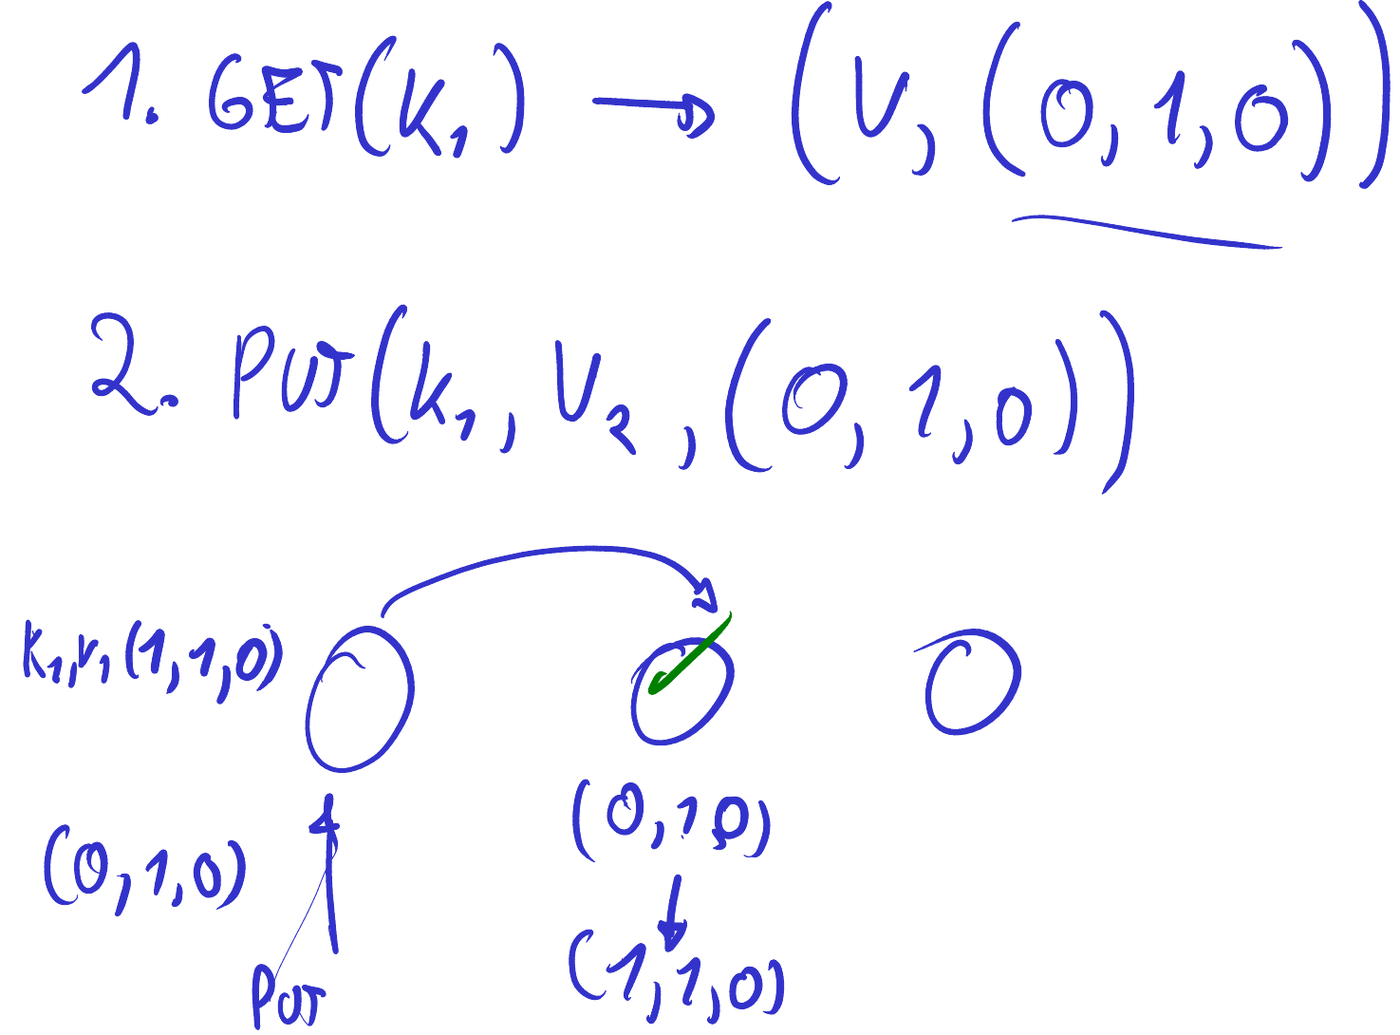
Al recibirlo, ese coordinador ve que el reloj que le estamos mandando es (0,1,0), y eso es consistente con el que él tiene guardado, que también es (0,1,0), porque se lo había mandado el coordinador de la vez anterior. Y aquí hay una diferencia con el mecanismo general de los relojes vectoriales que vale marcar: al recibir una réplica no se incrementa nada. El nodo se guardó el reloj tal como vino, sin tocarlo; el incremento no ocurre en la recepción.
Ocurre recién al aceptar la escritura. Ahí no solo la acepta, sino que además actualiza su reloj propio: como ahora es él quien coordina, incrementa la posición que le corresponde dentro del vector. Las otras dos quedan como estaban, y el vector pasa de (0,1,0) a (1,1,0).
Y después propaga. Le manda el vector nuevo a su vecino, que tenía (0,1,0) y ahora recibe (1,1,0). El vecino verifica la precedencia componente a componente: uno es más grande que cero, y las otras dos son iguales. Hay precedencia, con lo cual lo que le están mandando vino después de lo que él tenía guardado, y lo acepta sin problemas. Lo mismo pasa con el tercero, que también había quedado con (0,1,0) y hace la misma verificación.
Hasta aquí, el caso es sencillo.
Escrituras concurrentes y reconciliación
Falta el caso concurrente, que es el interesante. Volvamos al grupo de replicación de tres nodos, que ahora conviene nombrar: S1, S2 y S3. Y partamos del estado en el que quedaron las cosas después de la escritura anterior, porque seguimos con el mismo ejemplo: la clave valía (0,1,0).
Ahora llega alguien y le pone un put a S1. Y al mismo tiempo llega otro y le pone un put a S3. Los dos se aceptan, y la pregunta es por qué. Se aceptan porque no hay un coordinador de coordinadores: las dos escrituras llegaron a lugares distintos, y cada uno de los que las recibe razona exactamente igual: si recibe una escritura, asume el rol de coordinador. No verifica si hay otro, no se elige un líder, no existe ninguna coordinación adicional. Todo el mundo always writable, como dijimos desde el principio. Dynamo intenta algunas optimizaciones para que los clientes le manden siempre al mismo nodo, pero al margen de eso no hay ninguna restricción que impida lo contrario.
S1 hace lo que ya sabemos que hace un coordinador: guarda el valor localmente e incrementa su propia posición, la primera, con lo cual el vector le queda en (1,1,0). S3 hace lo mismo con la suya, la tercera, y le queda (0,1,1). Y después cada uno hace lo otro que le toca, replicar: S1 intenta replicar hacia S3 y, al mismo tiempo, S3 hacia S1. Uno manda (1,1,0) y el otro (0,1,1), y los dos mensajes se cruzan en el camino.
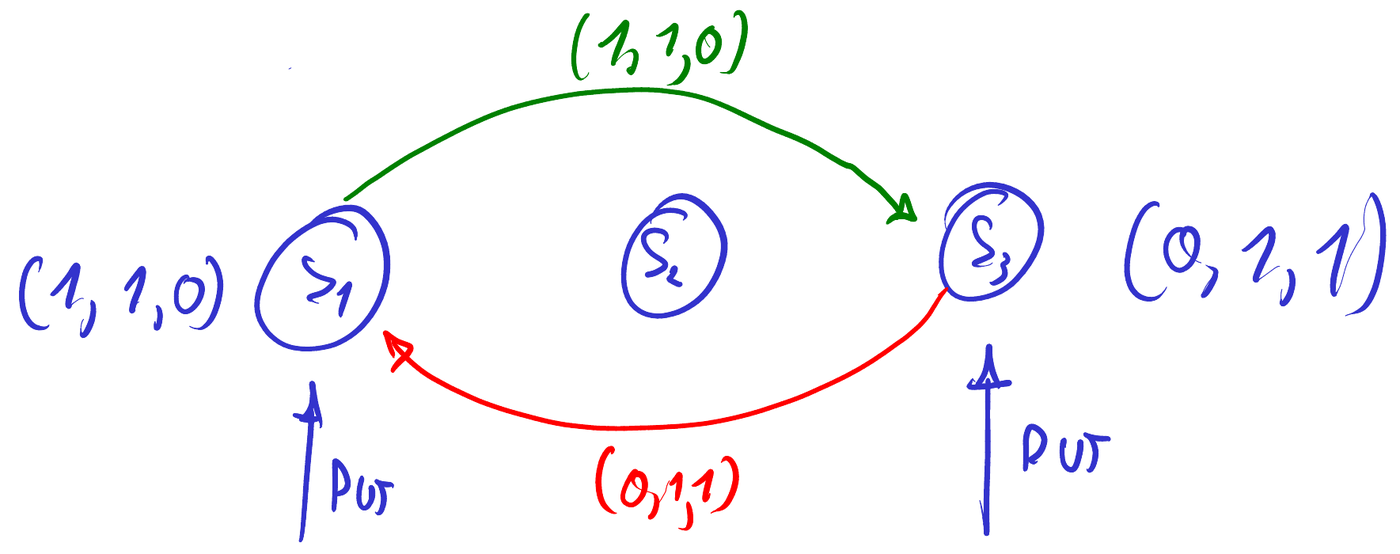
Cuando a uno de los dos le llega el vector del otro, hace la comparación de siempre. Tiene guardado (1,1,0) y le llega (0,1,1): en la primera posición el que tiene guardado va adelante; en la tercera va adelante el que le acaba de llegar. Ninguno precede al otro, y lo que deduce es que son concurrentes. Ese es, en esencia, el gran problema.
Lo primero que hace Dynamo para resolver estos casos ya está hecho, y no es poco: con los relojes vectoriales pudo detectar el problema de concurrencia. ¿Y cómo lo resuelve? Aceptando los dos. Resulta llamativo, pero funciona: tanto S1 como S3 van a guardar los dos valores. No eligen entre uno y otro, no descartan ninguno.
Lo que podría estar pasando se ve con el ejemplo clásico del paper: el carrito de compras. Lo que S1 está tratando de hacer es un put sobre el carrito del usuario uno. Quien lo manda ya leyó el valor: en el carrito había pan, y quiere agregarle queso, con lo cual el carrito le queda en pan y queso. Al mismo tiempo, en S3 ese mismo carrito se está actualizando de otra manera: parte también de pan, pero le agrega leche, y le queda pan y leche. Las dos escrituras se desincronizaron.
Lo que termina pasando es que en los dos servidores quedan las dos versiones. Queda guardado pan y queso asociado al vector (1,1,0), el valor con el que se guardó localmente, y queda también pan y leche asociado al otro vector, (0,1,1), el que mandó el otro nodo y que se aceptó de cualquier forma. Las dos versiones cuelgan de la misma clave, el usuario uno.
Todo esto se termina reconciliando cuando alguien hace un get. El cliente hace get del usuario uno, y lo que responde Dynamo es lo interesante, porque no responde un valor: responde todas las versiones que tiene —pan y queso, y pan y leche— y además un vector que, como dice el paper, las subsume. Es una palabra poco habitual en castellano, así que vale traducirla: subsumir es superar, estar por delante de las dos versiones. Ese vector es (1,1,1), y se obtiene tomando el máximo componente a componente de los dos vectores: donde uno tiene un uno y el otro un cero queda el uno, y donde los dos tienen un uno queda el uno. Es una especie de merge, y el resultado está por delante de las dos versiones a la vez.
El cliente recibe entonces esa respuesta un poco rara: un vector, que en rigor no le importa porque es opaco —le va a importar recién cuando lo devuelva—, y dos valores. Y ahí es donde Dynamo le traslada el problema al cliente: estas son todas las versiones disponibles, y combinarlas según la lógica de negocio es tarea suya.
El carrito de compras es un buen ejemplo justamente porque es fácil llegar a un criterio lógico con el cual combinar esos valores. Si una lista es pan y queso y la otra pan y leche, y el sistema nos garantiza que las dos fueron concurrentes, lo que hace el cliente cuando actualiza es un put del usuario uno con el merge de las dos listas: pan, queso y leche. Y le manda el vector que le habían mandado a él, porque ese contexto siempre hay que devolverlo.
¿Por qué un merge de listas y no otra operación cualquiera? Porque es lo que le conviene a quien está usando Dynamo. Si los valores no fueran listas y fueran un entero, un contador por ejemplo, quizás correspondería sumarlos, aunque el contador es más difícil y no es un buen ejemplo. Lo que queda firme es lo otro: el cliente tiene que usar alguna lógica propia para resolver el merge.
Dynamo no puede tomar ninguna decisión razonable, y la razón es de fondo. Para Dynamo, esto que nosotros vemos como listas son datos: son bytes. El usuario mandó bytes y el sistema devuelve los bytes que le mandó el usuario. El que interpreta que eso es una lista va a ser el usuario, y el que interpreta que si le devuelven dos versiones tiene que combinarlas también va a ser el usuario.
Mirado desde arriba, ¿qué estamos resolviendo con todo esto? Un split brain. Si hubiera una partición de red esto pasaría definitivamente, y las dos mitades empezarían a avanzar cada una por separado; eventualmente el cliente tiene que usar lógica de negocio propia para reconciliarlas.
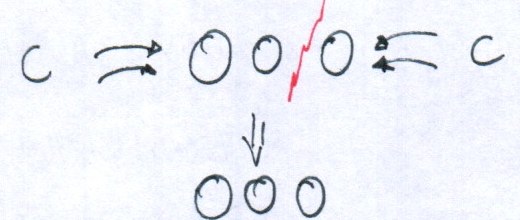
Hubo entonces dos formas de reconciliación. Una es la del caso feliz: la versión guardada estaba antes que la que se estaba mandando, y ahí es obvio lo que Dynamo tiene que hacer, reemplazar la versión anterior por la nueva. A esa la llaman reconciliación sintáctica; el nombre no es tan importante, porque lo inventaron los de Dynamo. La otra, la que acabamos de recorrer, se llama reconciliación semántica, y cabe conjeturar por qué: porque involucra lo que los valores son en sí y cómo se comportan. Hace falta saber cuál es la operación que mergea dos versiones para terminar con una sola y que no nos queden varias conviviendo.
Queda por decir algo que reordena hacia atrás todo el recorrido. De Dynamo en sí mismo hablamos prácticamente nada. La excusa de haberlo puesto aquí fue poder hablar de los relojes de Lamport y de los relojes vectoriales, que son el gran tema teórico.