4. Funcionamiento interno del mapper y del reducer
Ya sabemos cómo se parte el universo de claves entre los reducers. Falta abrir los nodos y mirar adentro: qué archivos escribe un mapper, qué archivos lee un reducer, y qué hace cada uno con ellos.
Agrupamiento por clave: sort y merge
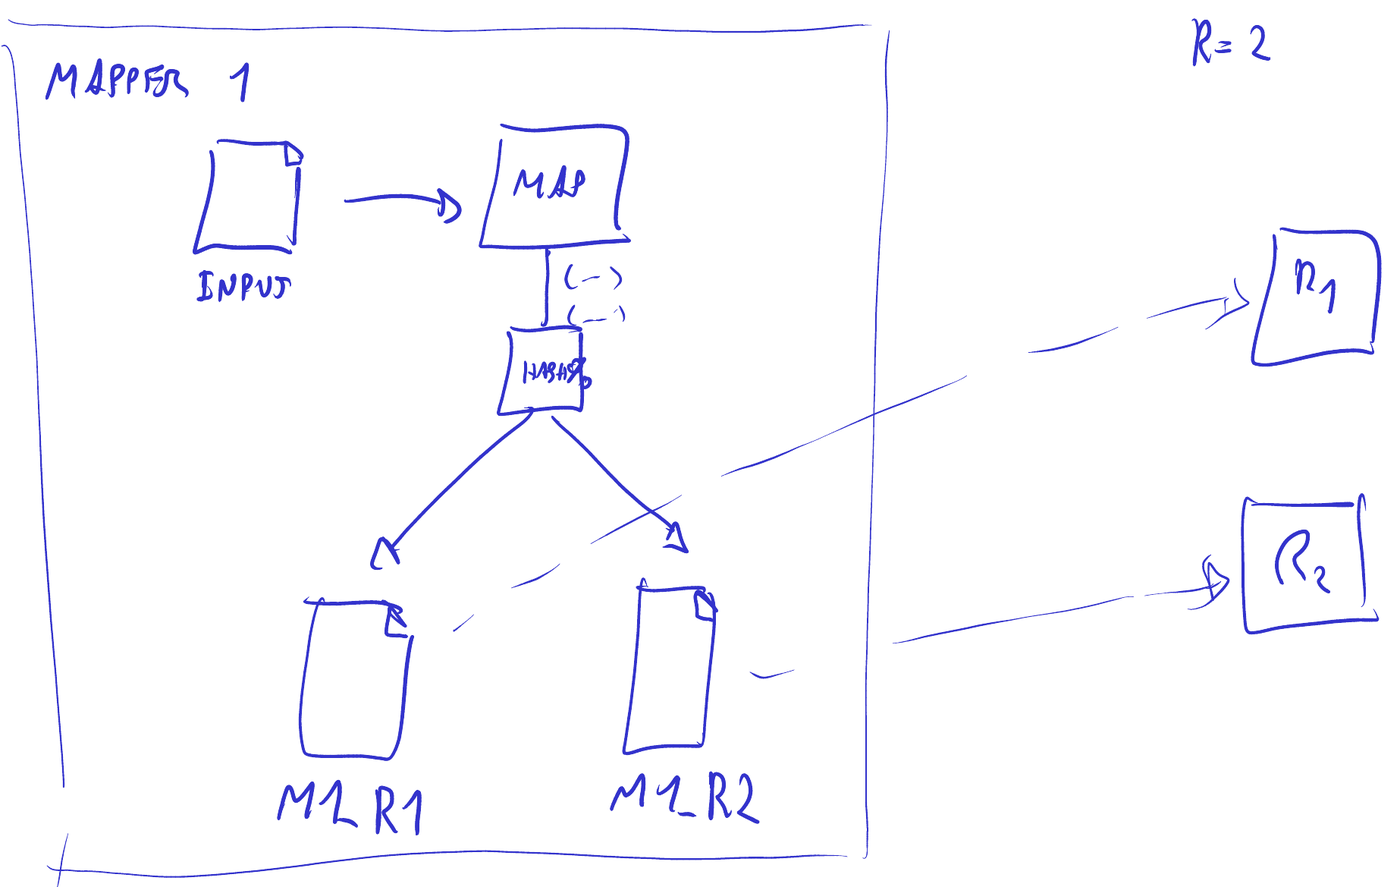
Miremos un mapper por dentro, con la diferencia marcada desde el principio: no la función map, sino el nodo cuando está funcionando como mapper. Seguimos con el ejemplo donde R vale 2.
Lo que hay ahí es un recorrido. Entra un input, se le pasa a la función map que escribió el programador, y esa función emite una secuencia de claves y valores que pasa por el hash y el módulo. De ahí se generan dos archivos en el disco local del mapper.
Llamémosle mapper 1 a este nodo: al primero de esos archivos lo llamamos M1_R1 y al segundo M1_R2. La nomenclatura se adivina sola: M1_R1 es lo que el mapper 1 prepara para el R1, y M1_R2 lo que prepara para el R2. Eventualmente cada uno va a ir a su destino.
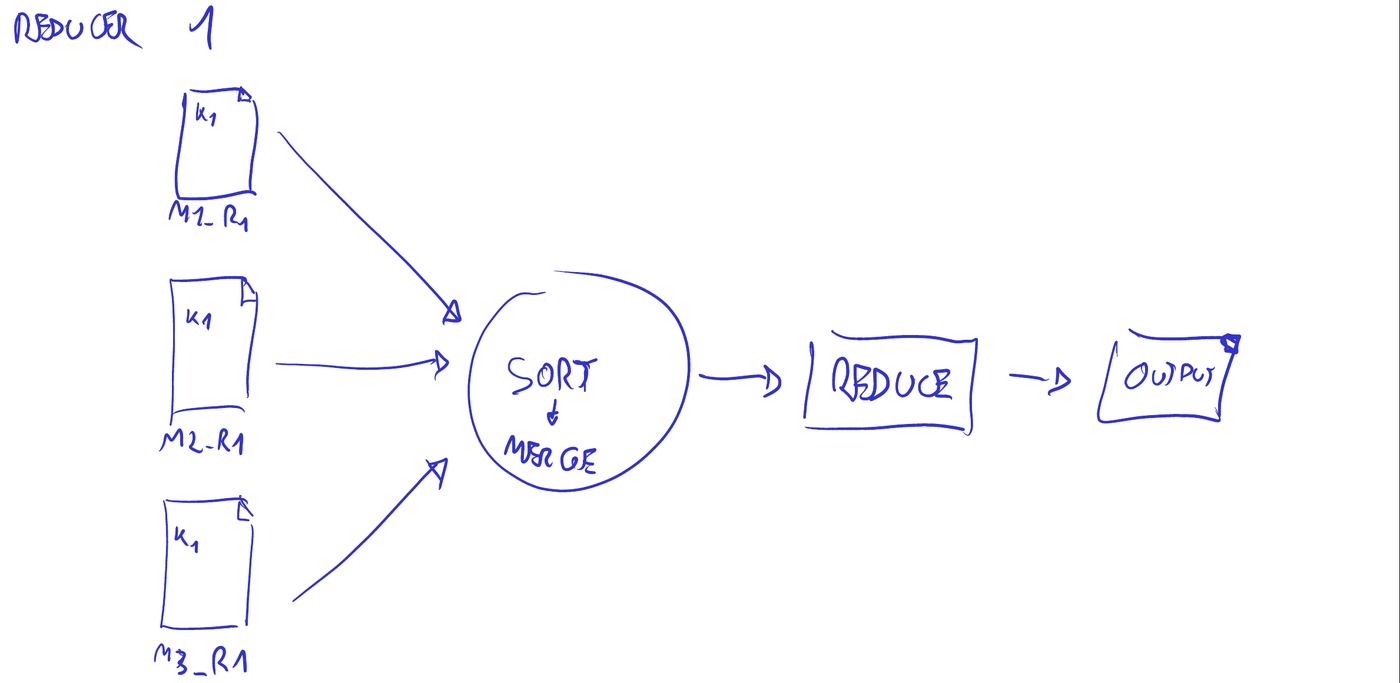
Pasemos a la perspectiva del reducer 1. ¿Cuántos archivos va a recibir? Tantos como mappers haya: el M1_R1, el M2_R1 y el M3_R1. Todo lo que era para el R1 se le envía por esa vía.
Lo que ese reducer tiene que hacer con esos tres archivos es agrupar todas las claves, porque el caso común es que tenga instancias de la misma clave en los tres. “Hola” va a aparecer en documentos que se le enviaron al mapper 1, al 2 y al 3: los tres emitieron pares con esa clave y los pusieron en su archivo para R1.
Si queremos que queden juntas todas las instancias de una misma clave, hay que hacer un sort: un sort de todos los archivos que el reducer recibe, juntos, como si fueran uno solo. Y eso ordenado es lo que se le entrega a la función reduce, con cierta maquinaria intermedia, de manera tal que reduce recibe la clave y una lista con los valores. Y ni siquiera es una lista: generalmente es un iterador, por cuestiones de memoria. El reduce, a su vez, produce un output.
El paper confirma esto y agrega dos precisiones. Sobre el iterador, dice que es lo que permite manejar listas demasiado grandes para caber en memoria. Sobre el sort, da la razón complementaria: hace falta porque a una misma tarea de reduce le caen típicamente muchas claves distintas, no solo muchas apariciones de una; y si los datos intermedios no caben en memoria, se usa un sort externo. Lo otro es una consecuencia valiosa del sort, en §4.2: MapReduce garantiza que dentro de una partición los pares se procesan en orden creciente de clave, lo que deja ordenado el archivo de salida de cada reducer. Eso importa cuando el formato de salida tiene que soportar búsquedas eficientes por clave.
El sort está ahí para que ocurra algo muy concreto. Supongamos que llega (a,1), (b,1), (a,1), (c,1) y (b,1), en ese orden mezclado. Si lo ordenamos por la clave queda (a,1), (a,1), (b,1), (b,1) y después (c,1): todas agrupadas. Y una vez agrupadas es muy fácil lograr que, en lugar de aparecer muchas veces la clave a con un uno cada vez, aparezca una sola vez con todos los unos juntos. Esa es la interfaz que ve el programador.
Y aquí aparece una optimización, porque todo esto se simplifica notablemente si el sort ya viene hecho. Si cada mapper ordenó por la clave su resultado parcial, el trabajo del reducer se transforma en un merge: toma esos archivos, que ya vienen ordenados, y hace un merge de todos los valores para generar el output. Es una optimización muy deseable, y estos sistemas la suelen tener.
Se puede ir un paso más allá. El mapper no está obligado a emitir un único archivo por reducer: puede tener un buffer en memoria donde acumula pares, ordenarlos cuando se le llena y emitir un archivo con eso, generando varios. Todos van al reducer, que hace el merge entre más entradas: el mismo trabajo.
Reducers abstractos y M×R archivos
Aquí cabe una objeción, en toda su fuerza. Si cada mapper sabe a qué reducer le va a hablar, ¿no los estamos acoplando demasiado? ¿No debería el mapper ser más agnóstico —le llegan sus datos, escribe su archivo, y ahí se termina su trabajo— y que después otro nodo se encargue del agrupamiento y del sort?
La respuesta empieza por precisar qué sabe el mapper. La cantidad de mappers y la de reducers son parámetros de la ejecución: cuando se inicia un job, además de las funciones map y reduce, se dice cuántos mappers —cuántos inputs— y cuántos reducers.
Lo que no se dice en ninguna parte es la ubicación física de esos reducers. Es lo que veníamos anticipando: son jobs abstractos. Con cinco reducers, lo único que se sabe es que van a existir el 0, el 1, el 2, el 3 y el 4. Eso, y nada más, es lo que saben los mappers: cuando dividen su salida, dividen entre esos números.
El resto lo hace el coordinador. Cuando un mapper termina, le avisa. Y cuando el coordinador ve que todos terminaron, elige un nodo cualquiera y le dice que va a ser, digamos, el reducer 3, y qué mappers le tocan. Ese reducer va a esos mappers y obtiene los datos.
Ahí está la respuesta a la objeción. No hay acoplamiento directo entre nodos mappers y nodos reducers: al mapper se le dice solamente cuántos R hay, y con eso separa internamente sus outputs y los deja preparados para que alguien se los venga a buscar. Quien pone en correspondencia esos jobs con nodos físicos es el coordinador, que está en el medio. Y hay algo de fondo que ahora se vuelve nítido: el nodo no es intrínsecamente un mapper ni un reducer. El nodo es un nodo.
El paper dice esto mismo con una palabra que vale retener. En §3.2 llama al master el conducto por el cual la ubicación de las regiones de archivo intermedias se propaga desde las tareas de map hacia las de reduce: por cada tarea de map completada guarda las ubicaciones y los tamaños de las R regiones que produjo. El detalle que la clase no da es que empuja esa información de forma incremental a los workers que ya tienen tareas de reduce en curso, sin esperar a que se le pregunte. Y hay un cierre elegante del arco de la clase en cómo el reducer obtiene los datos: según §3.1, usa remote procedure calls para leer los archivos de los discos locales de los workers de map.
El diálogo completo, dicho como si los dos hablaran, es este. El nodo pregunta “¿hay trabajo para mí?”, y el coordinador contesta “sí: vas a ser un mapper, este es tu input y tenés que generar dos salidas”. Ese nodo ejecuta la función map, genera sus dos archivos y los deja donde están. Después avisa: “ya terminé, soy el mapper 1”. Cuando el coordinador ve que todos terminaron, toma un nodo y le dice “ahora sos el reducer 1, tenés que ir a buscar todos estos archivos” —el M1_R1, el M2_R1, y así sucesivamente—. E incluso, si ese reducer falla, le va a decir a otro “ahora sos el reducer 1”.
Queda una última consecuencia, de las que vale calcular mentalmente. Si M y R son parámetros del sistema, tener M mappers y R reducers equivale a tener M×R archivos intermedios. Como mínimo, porque un mapper puede producir más de uno por reducer, como vimos con el buffer. Las dos cantidades se multiplican, así que con mil mappers y mil reducers eso da un millón de archivos intermedios para un solo job. Y lo que MapReduce resuelve como sistema distribuido —su gran aporte— es exactamente eso: el reparto entre esos mappers y esos reducers.